工場や設備の現場には、いまも数多くのアナログ計器(圧力計・温度計・電流計…)が並んでいます。それを写真に撮るだけで、指針の値を自動で読み取る― これが本記事で紹介する アナログメーター読値認識AI です。
読み取った結果は、ただの数値ではなく 構造化JSON(値・単位・スケール・自信度)で返します。中核には視覚言語モデル(VLM)のファインチューニングを使っていますが、当社の独自性はそこではありません。「AIの読みを鵜呑みにしない」フェイルセーフ設計 ― 誤読を検知して止められることにあります。
デモ映像
① 何をするAIか ― 画像を入れるだけで“読値JSON”に
やることはシンプルです。メーター画像を入力すると、VLM が読値を JSON にして出力します。
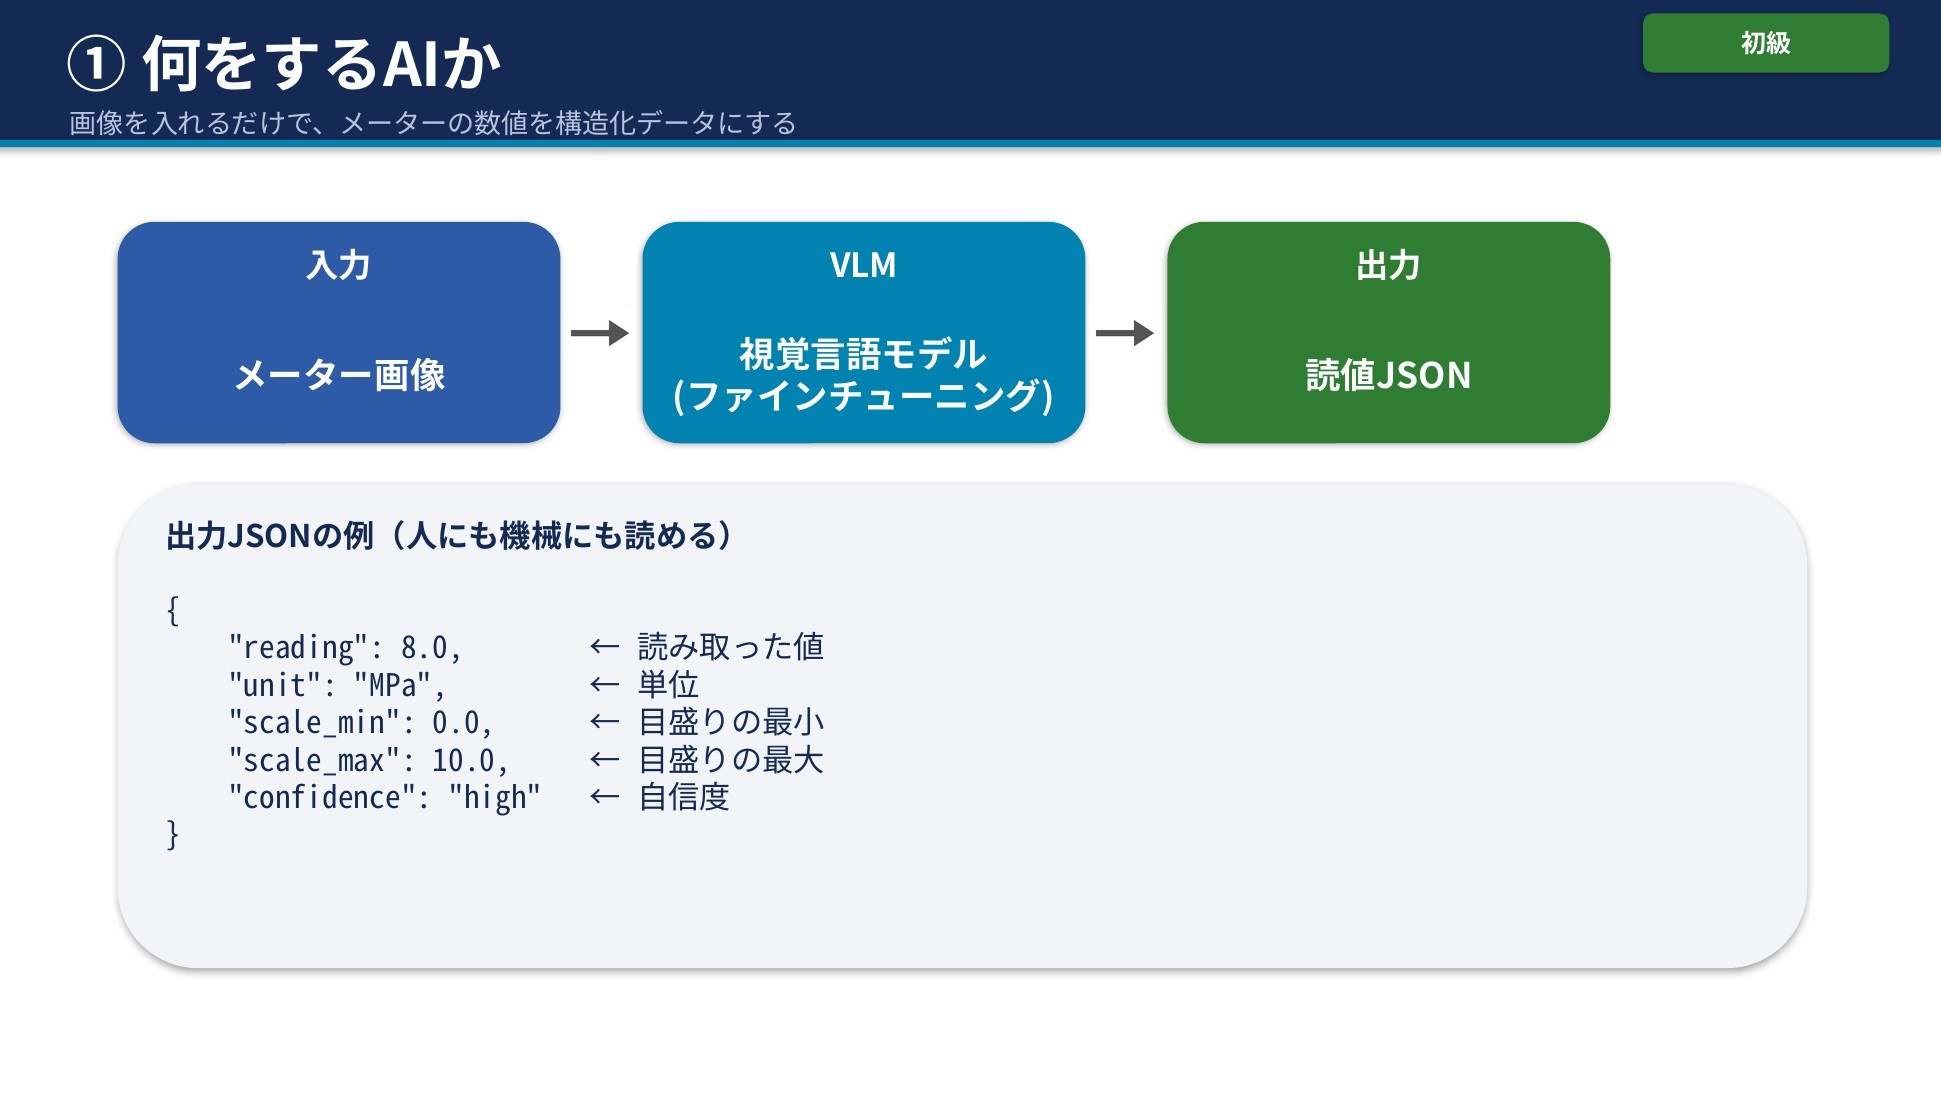
自由文で「だいたい8くらいです」と答えるのではなく、{"reading": 8.0, "unit": "MPa", "scale_min": 0.0, "scale_max": 10.0, "confidence": "high"} のように必ず決まった形で返す ― これが後段の検証と運用を支えます。
② FSRの設計思想 ― 「AIを鵜呑みにしない」
最新の VLM/LLM は強力ですが、ときに自信満々で間違えます。そこで当社は、最新モデルを活用しつつ、その出力は必ず検証し、従来技術と同じ運用様式で“確実に使える”状態にすることを方針にしています。
- 構造化出力の強制 ― 自由文ではなく必ず JSON(値・単位・レンジ・自信度)。機械が扱え、検証もできます。
- 検証層で握りつぶさない ― パース失敗・レンジ外は
valid=Falseとして棄却し、棄却理由を残します。誤読を黙って通しません。 - 運用様式への接続 ― 読値 →しきい値判定(NORMAL / WARNING / ALARM)を、既存監視と同じポリシー様式で発報します。
- 定量評価の常設 ― 精度・相対誤差・JSON妥当率を回帰テスト化し、改善が数値で追えるようにしています。
独自性は「精度の高さ」だけではありません。『間違いを間違いとして検知し、止められる』― ここが核心です。
③ システム構造 ― 4層アーキテクチャ
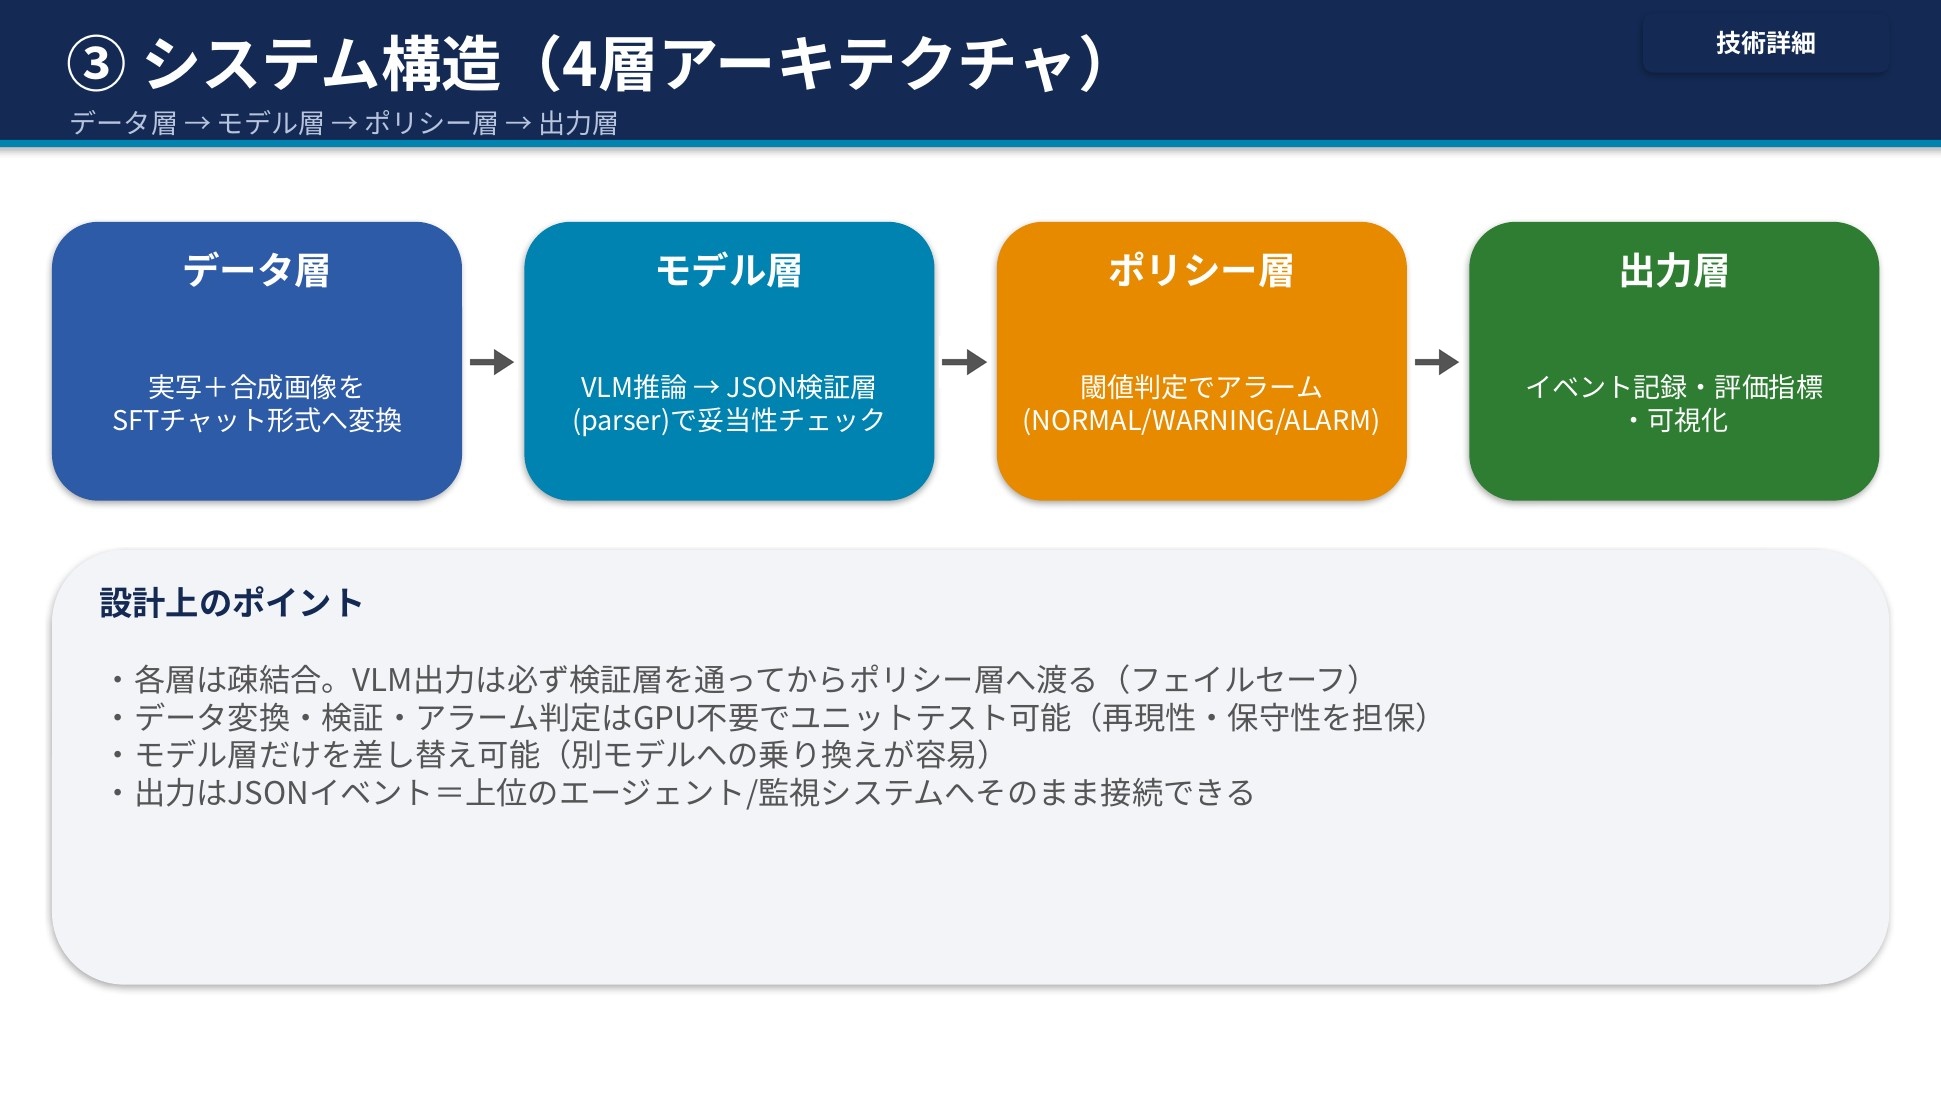
システムは データ層 → モデル層 → ポリシー層 → 出力層 の4層で、各層は疎結合です。
④ なぜVLMか ― 従来手法との比較
アナログ計器の読取には、従来から「針を検出して角度から物理量を計算する」CV手法があります。これは精度も説明性も高い一方、機種ごとの校正が要ります。多品種のメーターが混在する現場では、VLM の汎化性が効いてきます。
| 観点 | 従来型CV(針検出+角度計算) | VLMファインチューニング(本方式) |
|---|---|---|
| 汎化性 | 機種ごとに校正が必要 | 目盛り数字を読むため未知機種に汎化しうる |
| 単位・レンジ | OCRを別途組合せ | モデル単体で読値・レンジ・単位を同時出力 |
| 説明可能性 | 高い(角度→物理量) | 構造化JSON+自信度で補完 |
| 保守コスト | 機種追加ごとに校正作業 | 追加データで再学習するのみ |
| 連携 | 数値のみ | 読値+文脈を JSON/自然言語で返せる |
どちらが上という話ではなく、「多品種・未知機種への汎化」と「単位まで含めた構造化出力」が要る場面で、VLM は有力な選択肢になります。重要な計器では、従来型の校正を併用することもできます(フェイルセーフ)。
⑤ 学習データと学習方法
実写+合成のハイブリッド
学習データは、現場の難しさを含む実写メーター写真と、針位置を一様に大量生成した合成ゲージ画像(1.5万枚規模)を混ぜています。
- 評価は実写テストのみ ― 合成は学習補強で、性能は必ず実機画像で測ります。
- 合成データは針位置がランダム → 実写に不足しがちな高読値域・中間角度を補完します。
- 単位は psi / MPa / bar / kgf/cm² / ℃ など多様。実写に単位ラベルが無い分は欠損許容とし、合成側で構造化フィールドを学習します。
省メモリな軽量ファインチューニング
学習は、画像→JSON のペアによる教師ありファインチューニング(SFT)です。量子化+部分パラメータ更新で、汎用GPU 1枚でも学習が成立します。推論は決定的(同じ画像は常に同じ結果=再現性)で、学習と推論で同一プロンプトを使い挙動を安定させています。そして生成JSONは、必ず検証層を通してから利用します。
⑥ 評価結果 ― 実写1,007件で実測
テストセット全件(実写1,007件)を並列評価で実測した結果です。
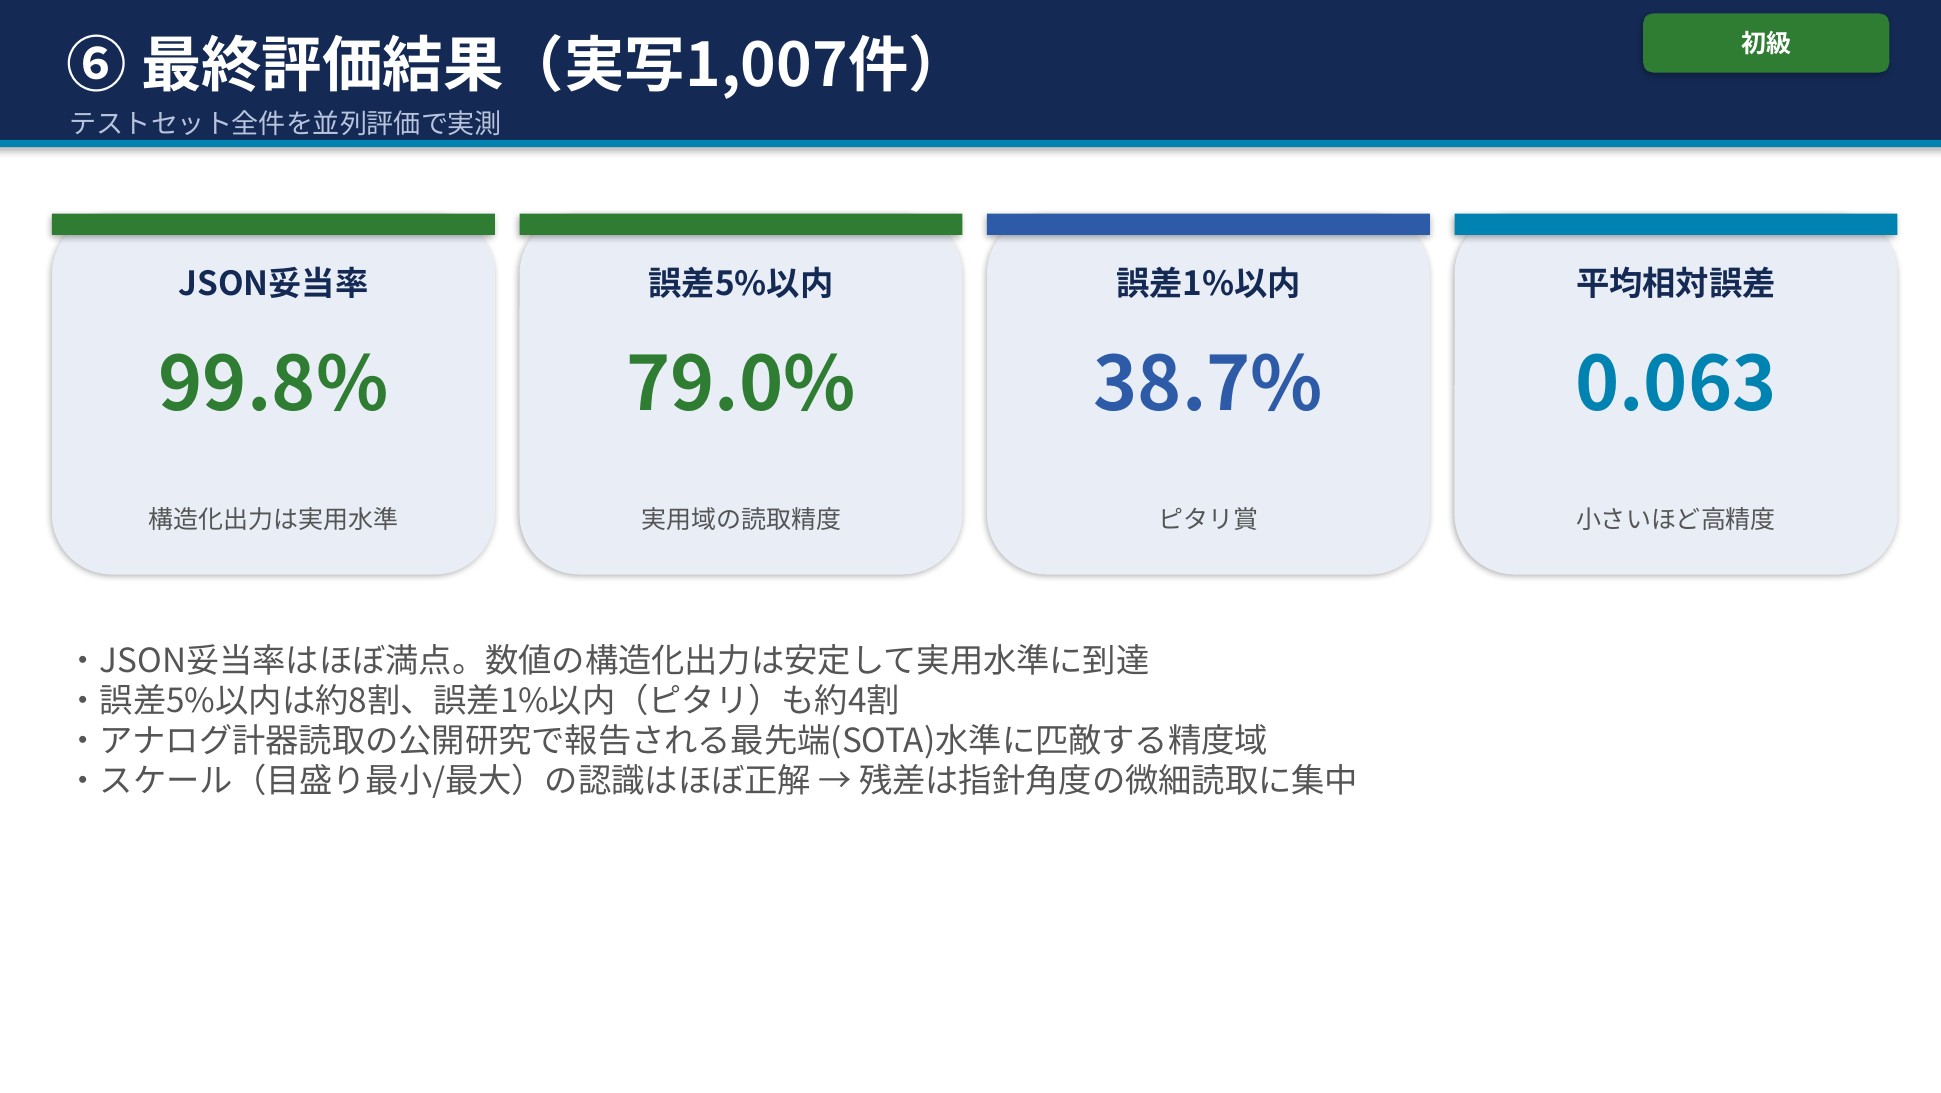
JSON妥当率はほぼ満点で、数値の構造化出力は安定して実用水準に達しています。誤差5%以内は約8割、誤差1%以内(ピタリ)も約4割 ― アナログ計器読取の公開研究で報告される最先端(SOTA)水準に匹敵する精度域です。スケール(目盛りの最小/最大)の認識はほぼ正解で、残る誤差は「指針角度の微細な読取」に集中しています。
⑦ 実際の推論例 ― 多数の実写サンプル
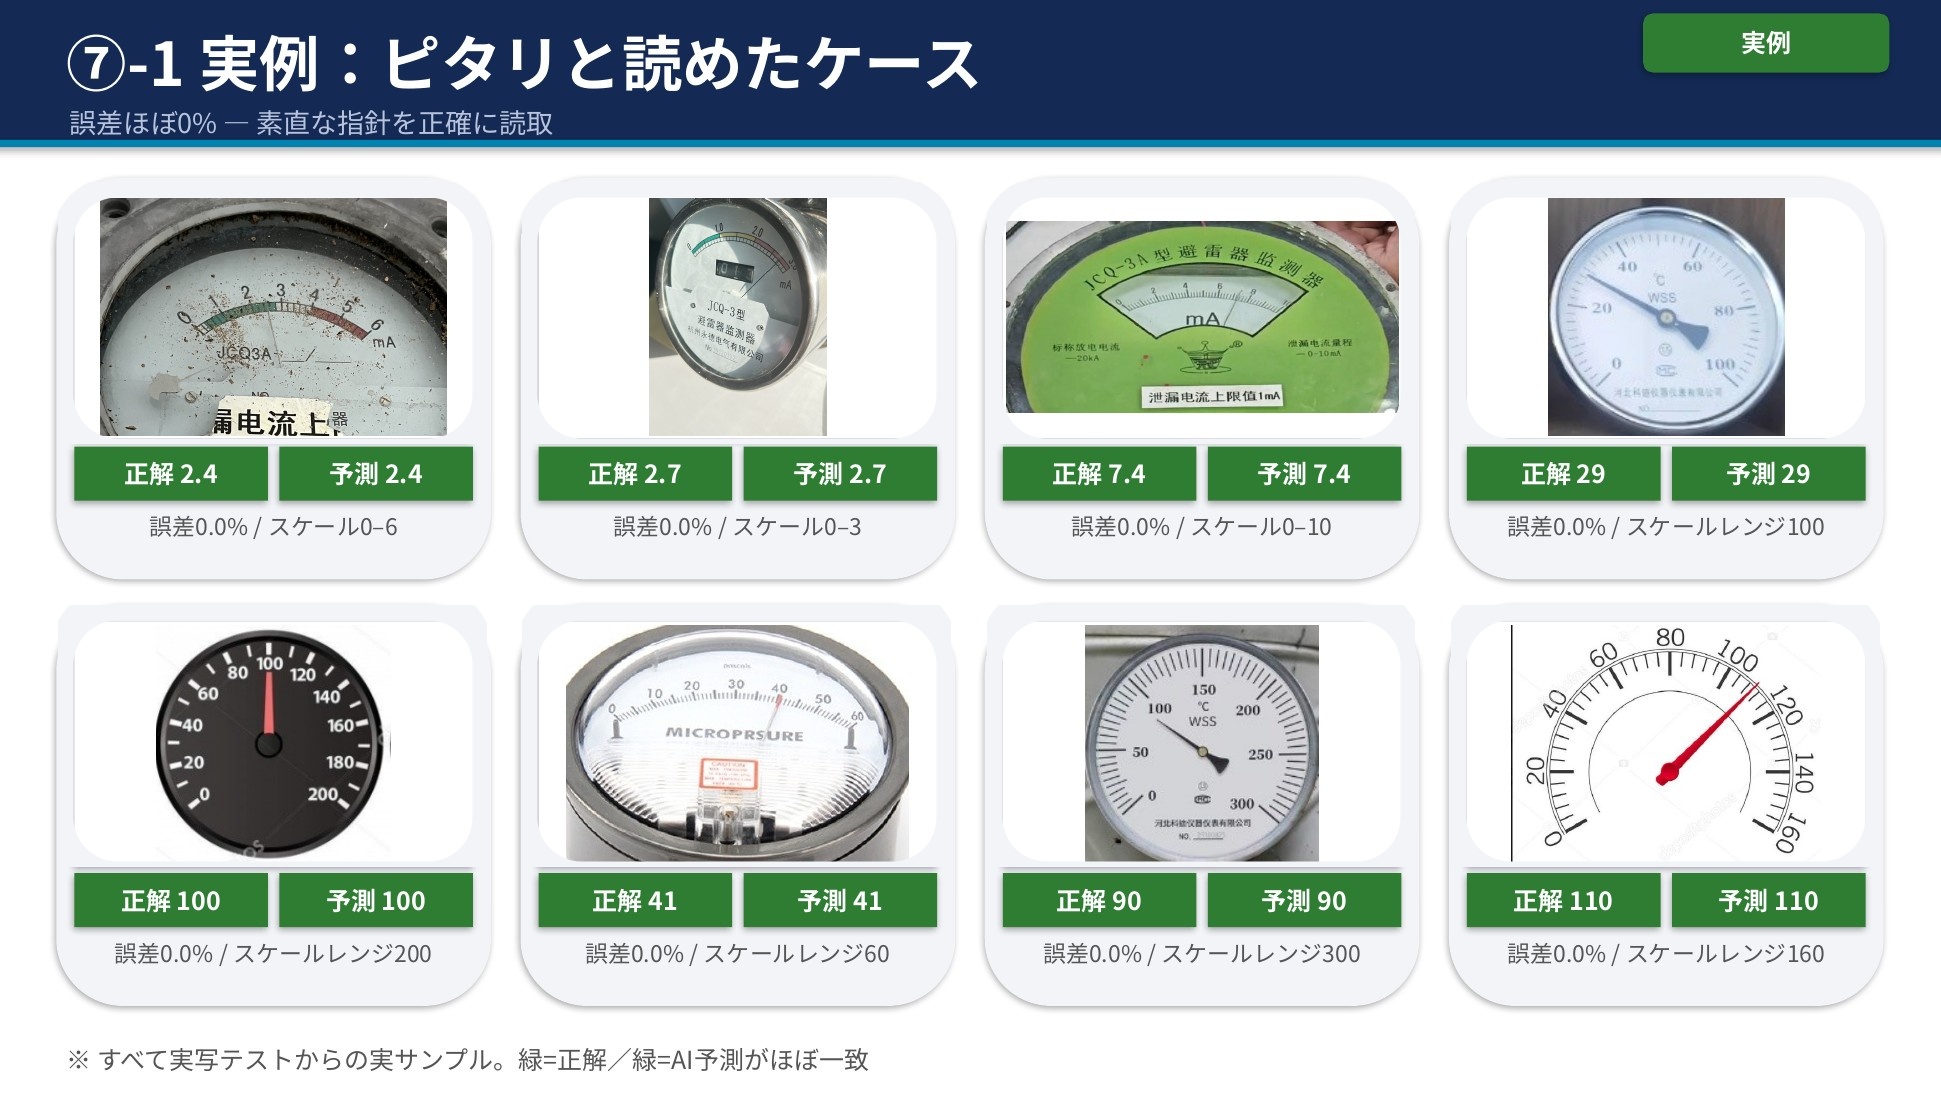
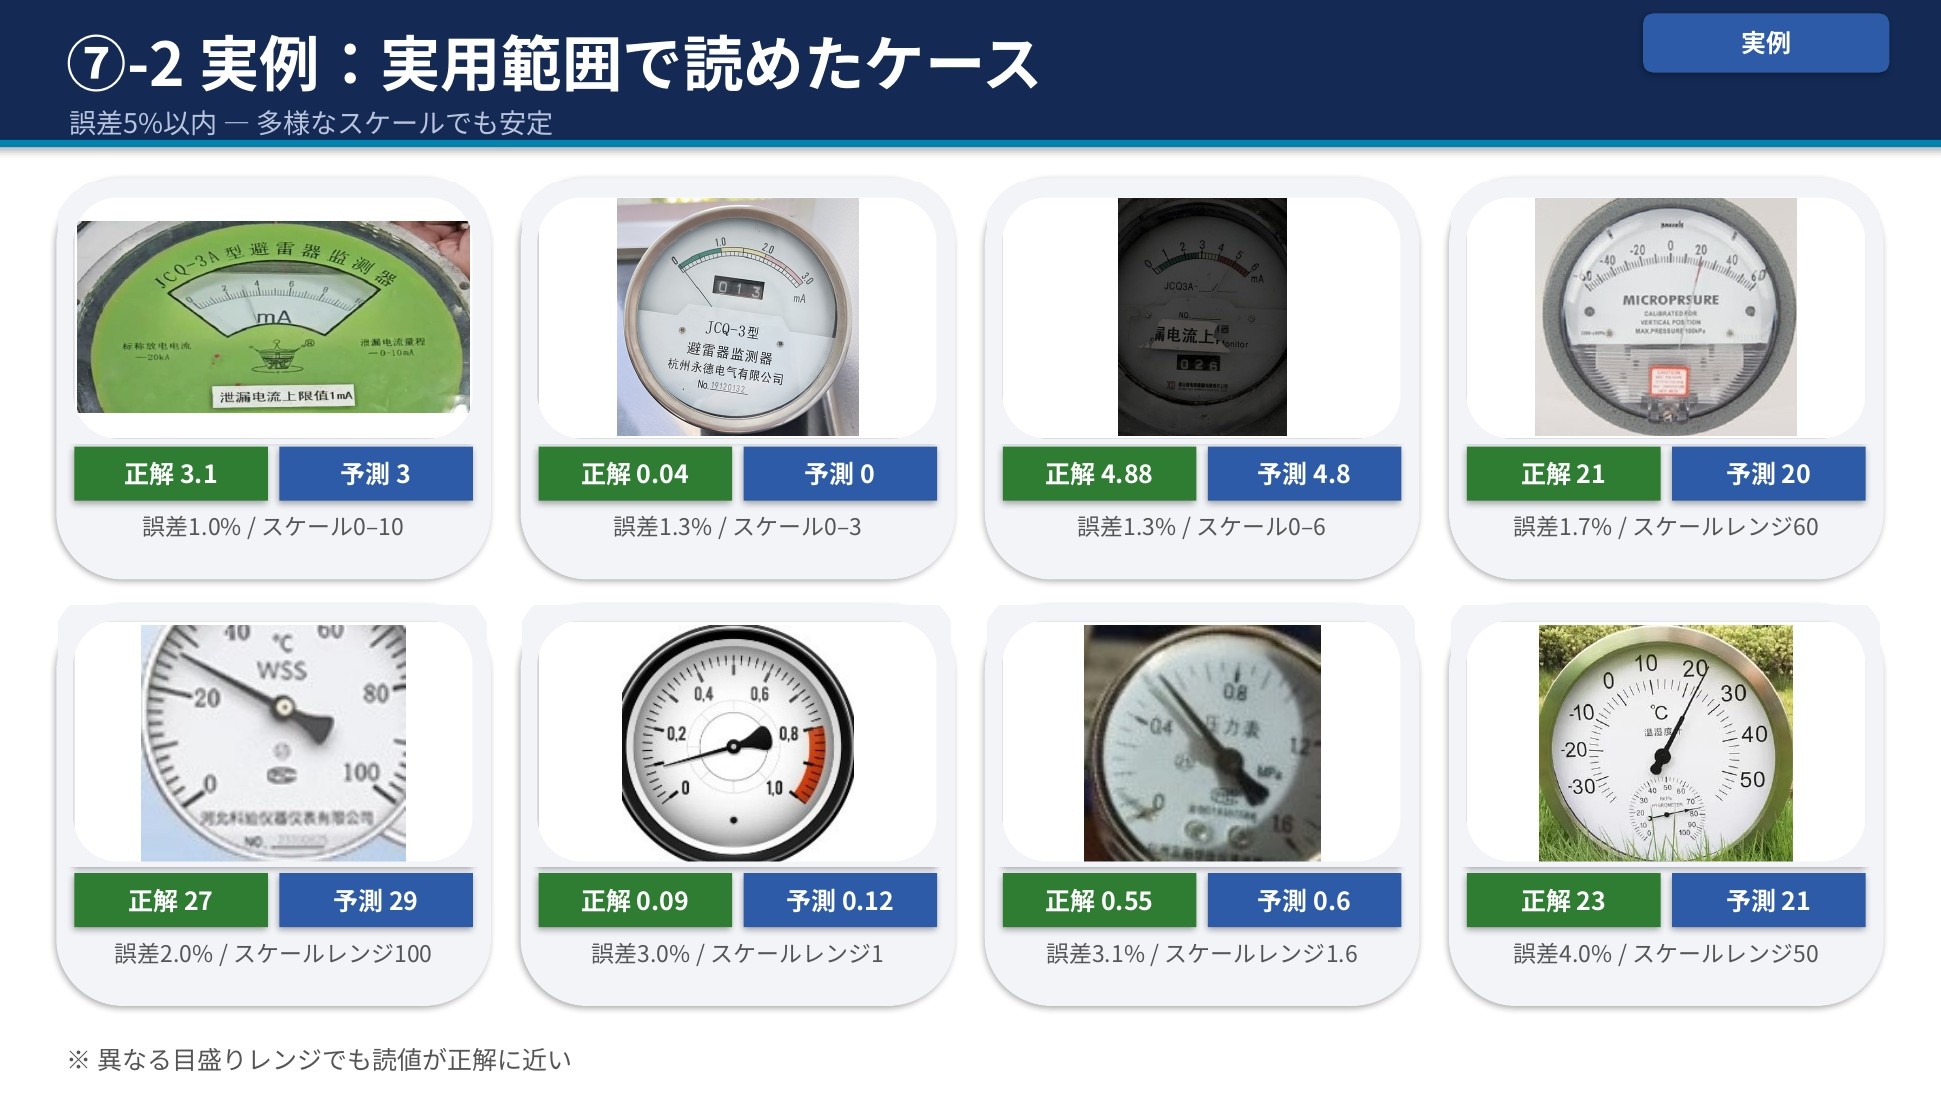
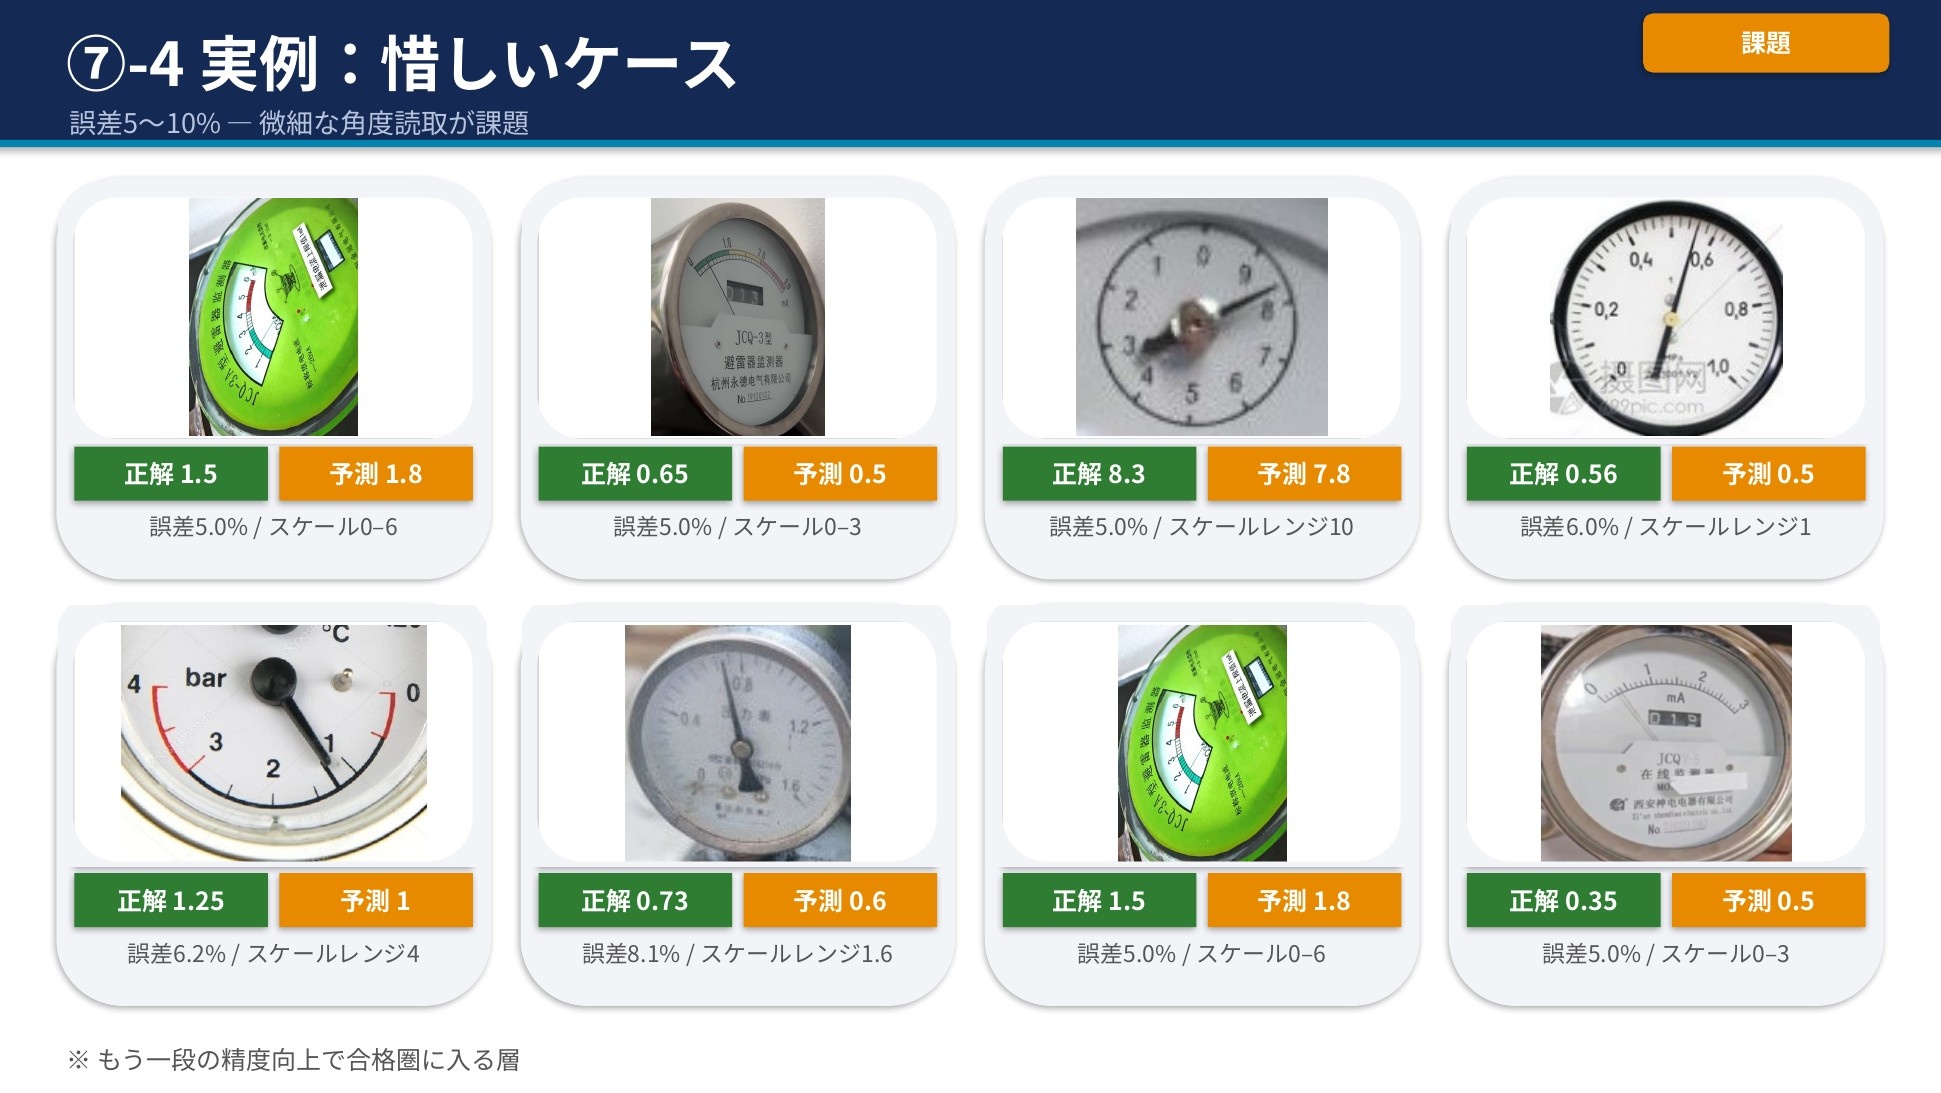
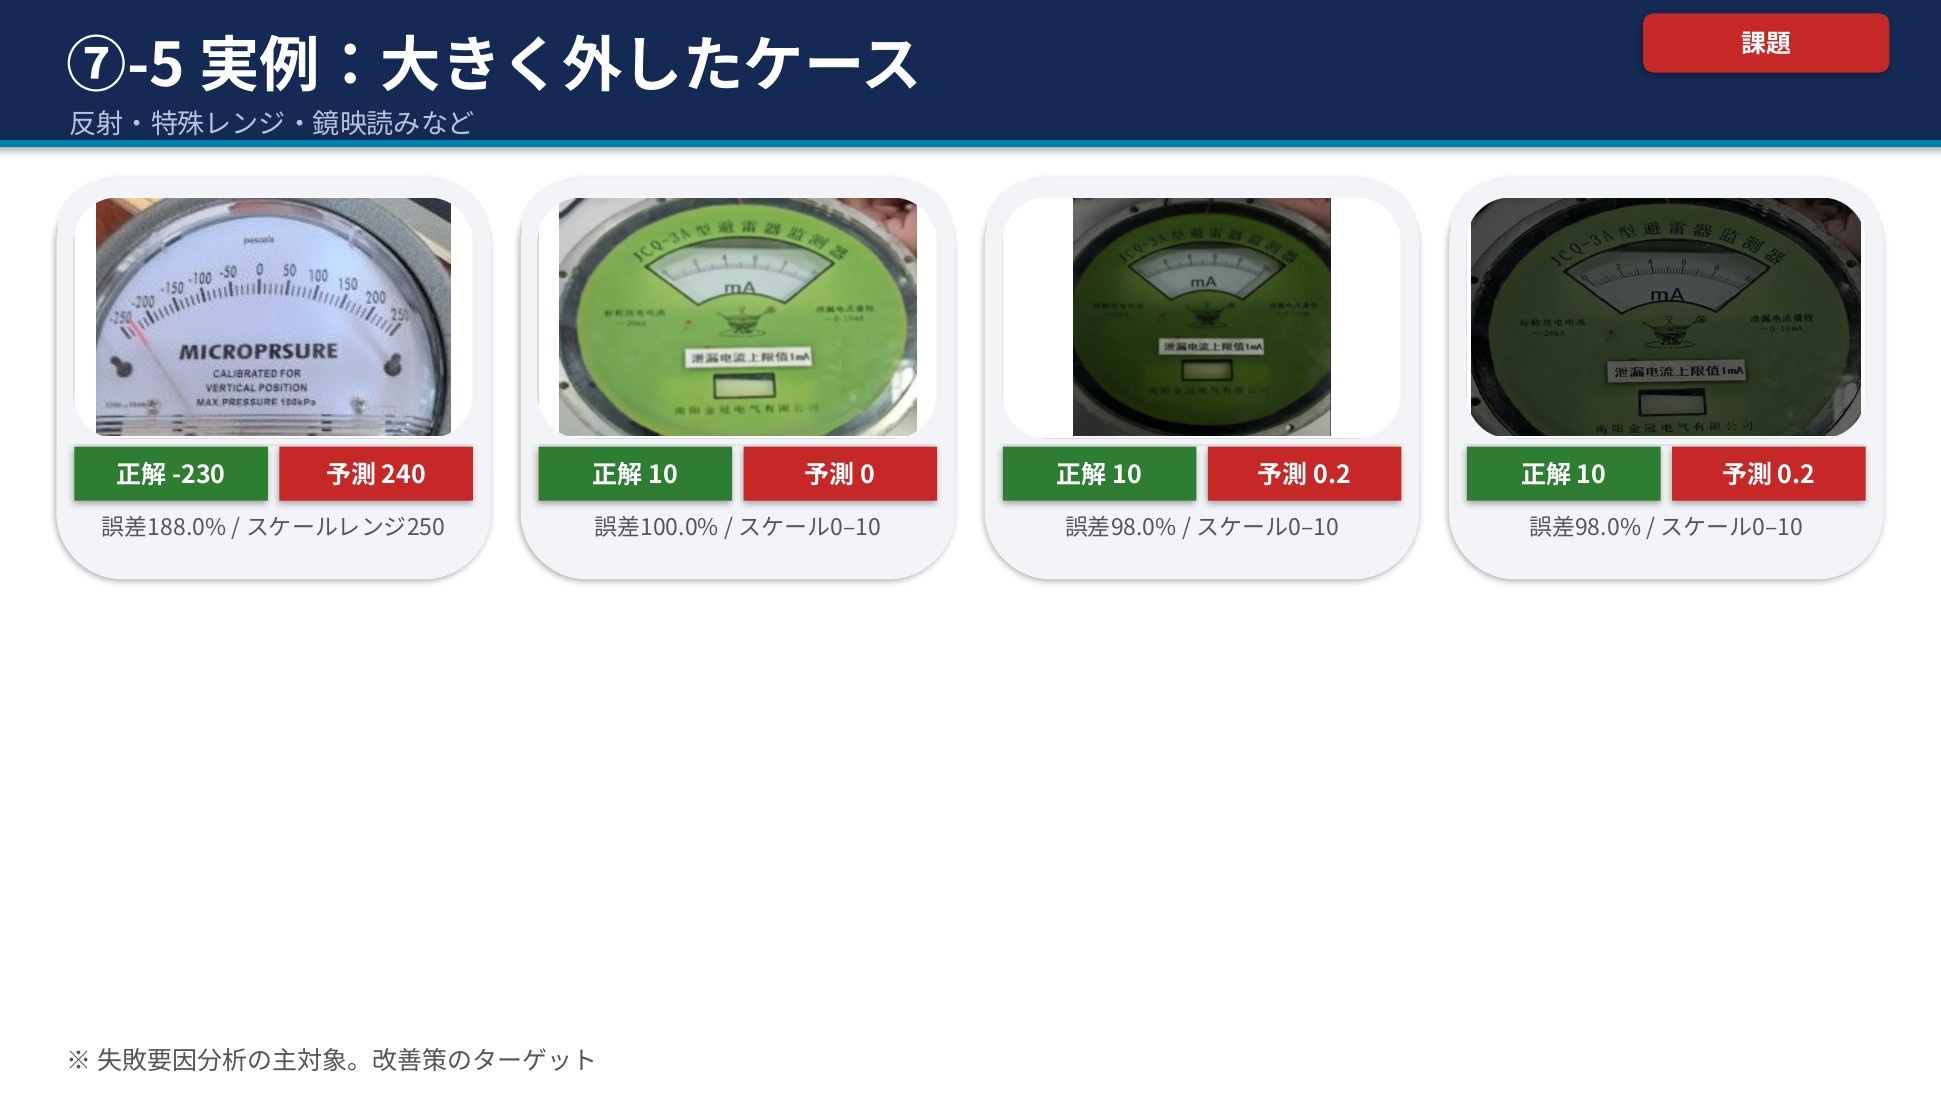
言葉より、実例です。すべて実写テストからの実サンプル(正解=人手ラベル/予測=AIの読値)です。
ピタリと読めたケース(誤差ほぼ0%)
実用範囲で読めたケース(誤差5%以内)
惜しいケース(誤差5〜10%)
大きく外したケース(失敗分析の主対象)
⑧ 失敗要因の分析と今後
残る誤差がどこから来るのかも、正直に切り分けています。
できていること ― スケール(目盛り最小/最大)の認識はほぼ正解、JSON構造の妥当率もほぼ100%。つまり「文字盤の数字」は読めており、誤差は指針角度 → 数値の変換に集中しています。
主な失敗パターン
- 針角度の微細読取不足(最多) ― 細かい目盛りの分解が難しい(0–10 レンジで顕著)。
- 頻出値への当てずっぽう ― 不確かなときに学習頻出値を出す(分布バイアス)。
- 系統的誤読 ― 桁ズレ・鏡映読み(左右反転)・端点吸着が、失敗の約3割。
- 高読値域の学習不足 ― 針が文字盤後半にある画像で精度が低下。
累積誤差分布(実写1,007件): 誤差1%以内 38.7% / 5%以内 79.0% / 10%以内 90.0% / 20%以内 94.6%。
今後は、① 合成データの増量と針位置分布の補正(高読値域・中間角度の底上げ)、② 学習量の増加(まだ収束余地あり)、③ 段階推論プロンプト(針角度→目盛り対応→数値の中間出力で系統誤りを抑制)、④ 重要メーターは従来型校正を併用可能な設計(フェイルセーフ思想)で伸ばしていきます。
まとめ
- 仕組み ― 実写画像から読値・単位・スケールを構造化JSONで安定出力(妥当率 99.8%)。
- 精度 ― 誤差5%以内で読める率は約8割、ピタリ(1%以内)も約4割。アナログ計器読取のSOTA水準に匹敵。
- 独自性 ― 高精度だけでなく、『間違いを検知して止められる』フェイルセーフ設計(検証層で誤読を棄却)。
- 残課題 ― 指針角度の微細読取。継続的な改善余地があります。
「AIを鵜呑みにしない」― 最新の VLM を活用しつつ、検証と運用様式で“確実に使える”状態に仕上げる。これが当社のメーター読値認識AIです。デモやご相談を承っています。