部屋のどこかで電話が鳴っている。ロボットは、カメラに映る景色と左右の耳で聞こえる音だけを頼りに、鳴っている場所(音源)まで移動して止まる ― これが音による目的地ナビゲーションです。見守り・救助・案内など、現実のロボットに近い難しい設定です。
この難タスクに対して、「ナビゲーションの強化学習エージェントに、自分の行動を言葉で説明させるという“宿題”を足すだけで、説明可能性だけでなくナビ性能そのものが上がる」と示したのが、本記事で扱う論文 "Embodied Navigation with Auxiliary Task of Action Description Prediction"(Haru Kondoh, Asako Kanezaki/Institute of Science Tokyo(東京科学大)・RIKEN AIP、ICCV 2025、CVF Open Access)です。本記事では、この手法を便宜上 DescRL と呼びます。
本記事は、当社の論文調査・先端技術の「手の内化」の一環として、この論文を読み解き、実際に自分たちの環境で動かして確認した記録です。論文が報告している数値と、当社が自分たちの環境で確認できたこと/まだ保留していることを、はっきり分けて書きます。
デモ映像
扱うタスク ― 音を頼りに目的地へ行く
論文が対象にするのは、マルチモーダル(映像+音)な屋内ナビゲーションです。難易度の違う2つの設定があります。
- AudioNav(音ナビ) ― 部屋のどこかで音が鳴り続けている(例:電話の着信音)。ロボットはカメラ映像と左右の耳で聞こえる音だけを手がかりに、音源まで移動して止まります。
- SAVNav(もっと難しい版) ― 音は途中で鳴り止みます(電話を取ったら静かになる、など)。音が消えた後は、見た景色と記憶だけで残りの道を推理して進まなければなりません。
音がずっと鳴っていれば「音の大きい方へ」で近づけますが、音が消えた瞬間に手がかりが激減するのが SAVNav の難しさです。現実の見守り・救助・案内ロボットに近い、意地悪で実践的な設定と言えます。
課題 ― 強いナビゲーションAIほど「理由が分からない」
近年のナビゲーションは強化学習(RL)が主流で、成功率は高い一方、実運用に向けては3つの困りごとがあります。
- ブラックボックス ― 「なぜ今そう動いたか」を人が説明できない。信頼性が求められる現場では、これが壁になります。
- 説明の教師データが無い ― では説明を学ばせたくても、「この場面での正解の説明文」というラベルが存在しません。人手で大量に書くのは非現実的(コスト膨大)です。
- 音が消えると迷子 ― SAVNav の後半のように、手がかりが減ると性能が落ちます。
そして厄介なことに、これまでは「説明できるシステムは、説明できないシステムほどの性能を出せない」というトレードオフがありました。説明可能性を足すと性能が落ちる、というのが従来の相場だったのです。DescRL は、このトレードオフ自体をひっくり返しにいきます。
手法 ― 行動を「言葉で説明」させる補助タスク
DescRL の核心アイデアは明快で、ナビの訓練に「説明する宿題」を足すだけです。
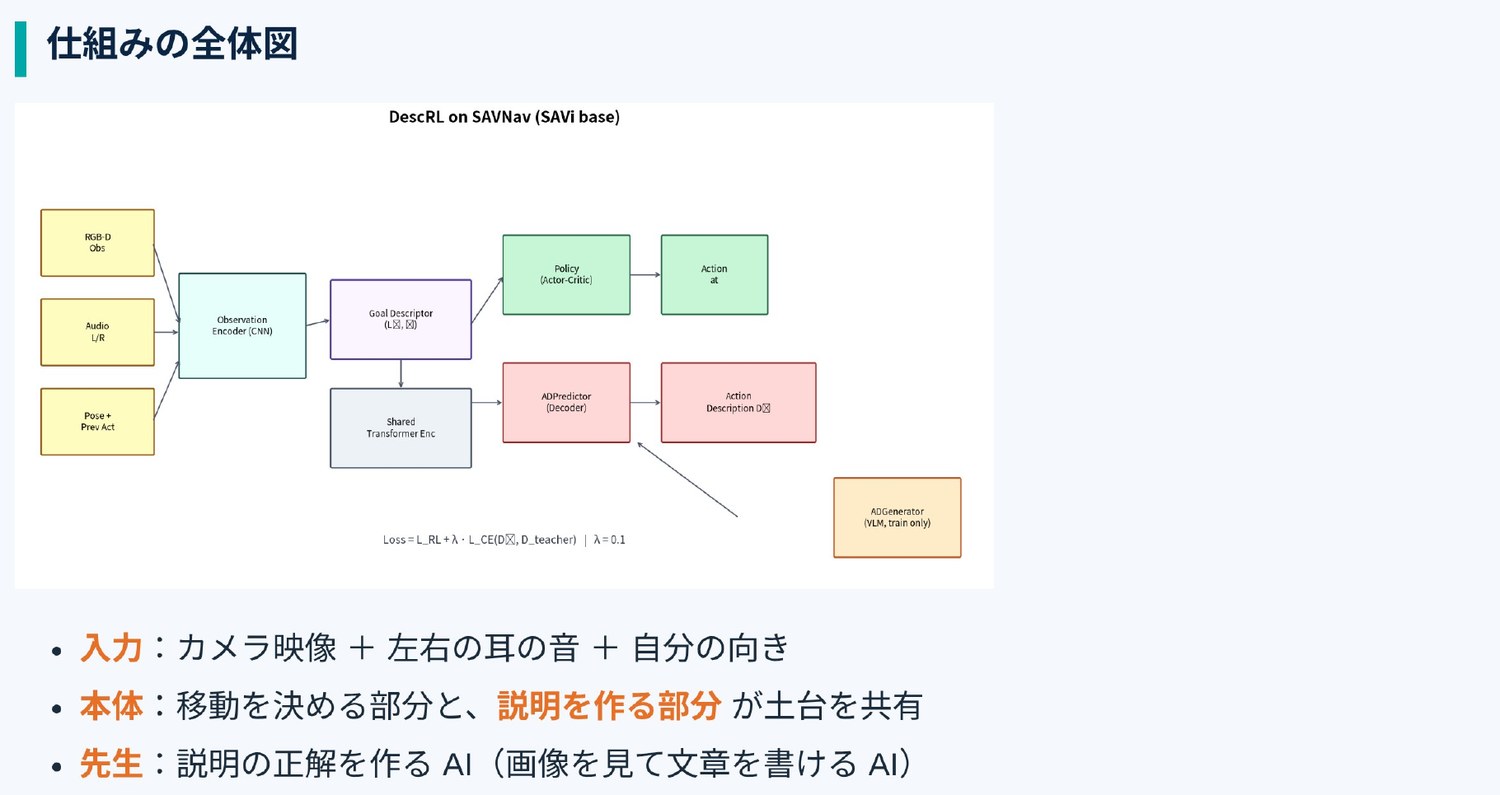
やっていることは、次の3ステップです。
- 先生役の AI が正解を用意する ― 画像を見て文章を書ける学習済み AI(VLM=視覚言語モデル)が、ロボットの行動を見て「いま何をしたか」の説明文を自動で生成します。人手ラベルの代わりに、AI が正解データを作るわけです。
- ロボットが自分でも説明できるよう練習する ― エージェントは移動しながら、その説明文を自分でも言えるように学習します。この「先生 AI の説明をマネして学ぶ」仕組みが、いわゆる知識蒸留(Knowledge Distillation)です。
- 説明の練習が“状況を理解する力”を鍛える ― 説明できるように訓練された結果として、ナビ性能も一緒に上がります。
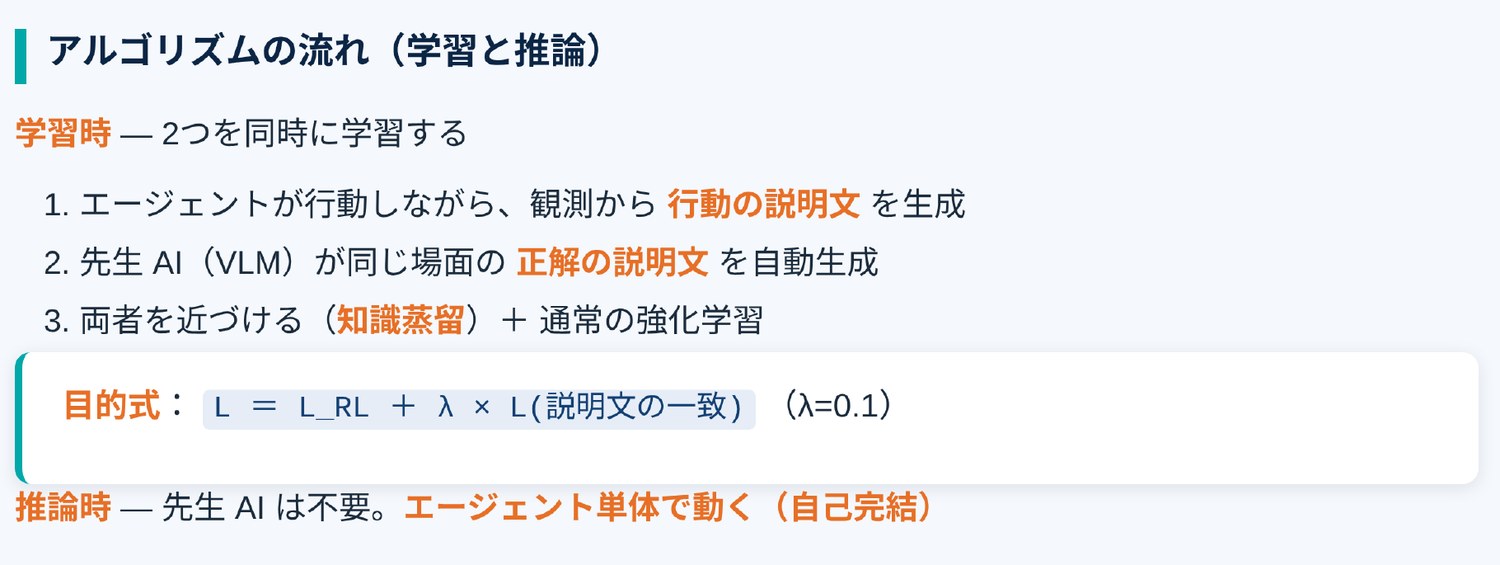
うまいのは、推論時には教師 VLM を一切使わない点です。VLM は学習の“先生”として正解の説明文を注入するためだけに使われ、実際に動くロボットは説明を作る能力ごと自分の中に取り込んだ状態になります。重い VLM を積まずに、その恩恵だけを受け取れる設計です。
説明には3種類ある ― どれを言わせるか
「説明させる」といっても、何を説明させるかで効き方が変わります。論文は3タイプを比較しています。

要点は、「過去の行動を振り返って説明させる(P-AD)」が一番よく効くこと。迷ったときに「今までこう動いてきた」と自分の来歴を言語で整理させると、次の判断が安定するイメージです。そして、この効果が最も大きく出るのが、音が消える SAVNavでした ― 手がかりが減る局面ほど、「記憶を言葉でまとめる」練習が効く、という直感に合う結果です。
効果 ― 説明を足したら、ナビ性能も上がった
論文は、最も難しい SAVNav(音が消える設定)で、従来手法に対する改善を報告しています。
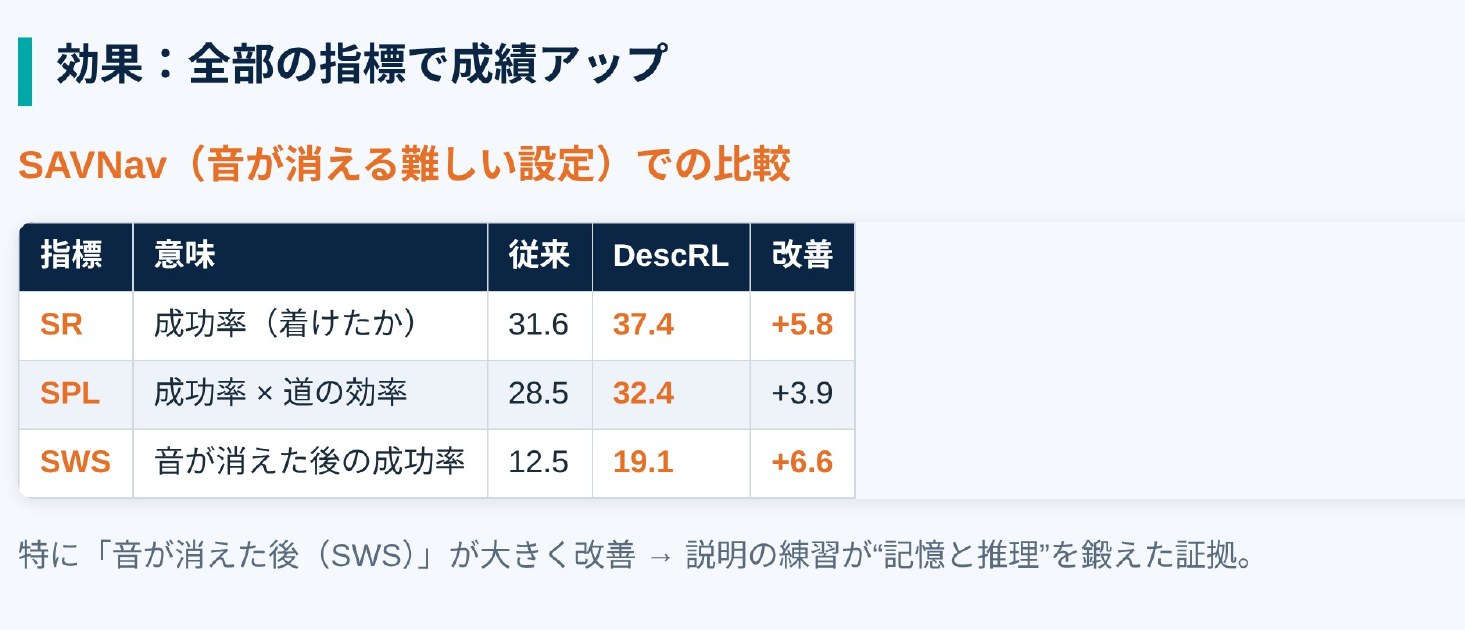
| 指標 | 意味 | 従来 | DescRL | 改善 |
|---|---|---|---|---|
| SR | 成功率(着けたか) | 31.6 | 37.4 | +5.8 |
| SPL | 成功率 × 道の効率 | 28.5 | 32.4 | +3.9 |
| SWS | 音が消えた後の成功率 | 12.5 | 19.1 | +6.6 |
※ 上表はいずれも論文が報告している数値です(当社の再現値ではありません)。特に「音が消えた後(SWS)」の伸びが大きく、説明の練習が“記憶と推理”を鍛えた証拠と読めます。
さらに“おまけ”として、「なぜ失敗したか」が説明文から読めるようになります。「まだゴール手前なのに止まった」=早すぎる停止、「似た別の物で止まった」=取り違え、といった失敗の理由が、エージェント自身が出力する説明文から検知できる ― 従来のブラックボックスでは闇の中だった“間違え方”に、言葉で光が当たるわけです。性能向上(課題③)と説明可能性(課題①)を同時に達成し、教師データ不足(課題②)は AI(VLM)が生成することで解いた ― これが論文のまとめです。
当社の取り組み ― 「論文を自分たちで動かせる」状態にする
論文を読むだけでは、本当に動くか・どこまで使えるかは分かりません。そこで当社では、シミュレータ環境を再構成し、公式の学習済みモデルを実際に動かして確認しました。実行環境はコンシューマ GPU 1枚です。
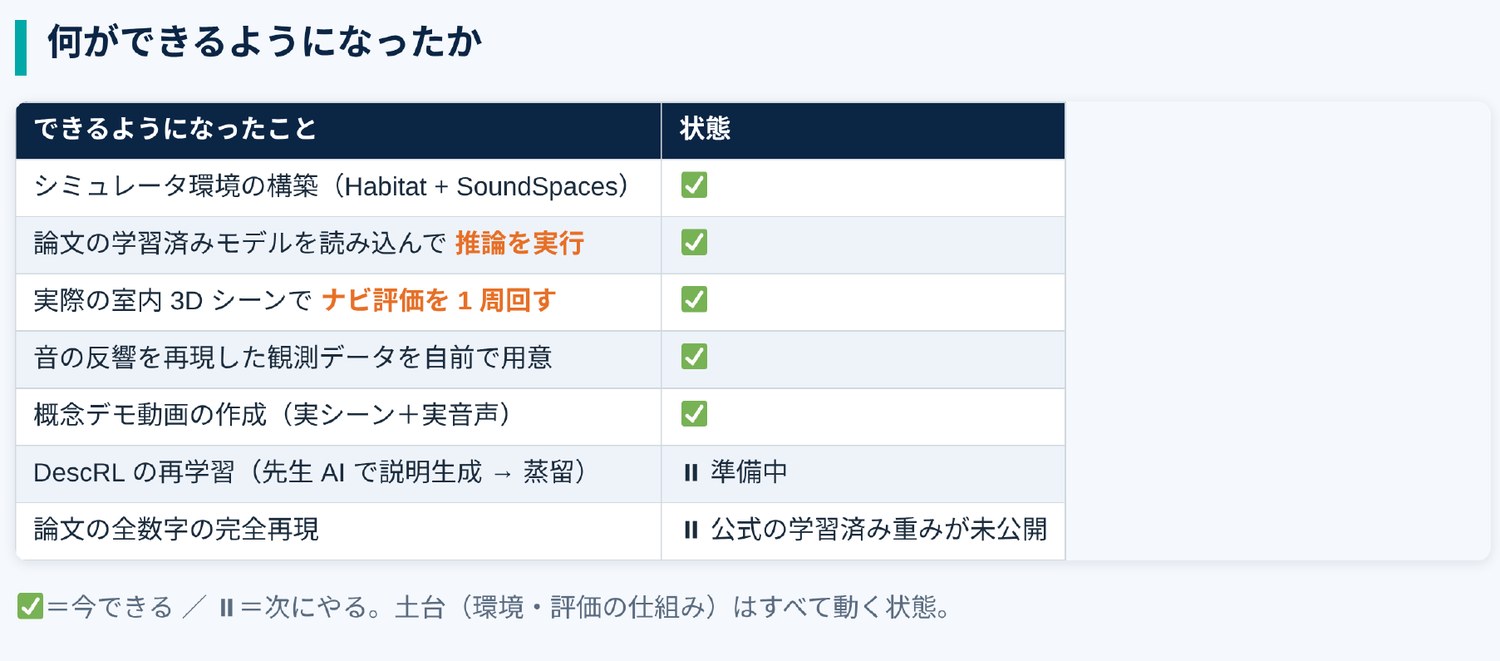
できたこと(当社環境で確認済み)
- シミュレータ環境の構築 ― Habitat + SoundSpaces(音の伝播を物理的に扱う音響シミュレータ)を組み上げ、映像と音の両方が出る評価環境を用意しました。
- 学習済みモデルで推論を実行 ― 論文の公開されている学習済みモデルを読み込み、推論を回せる状態にしました。
- 実際の室内3Dシーンでナビ評価を1周 ― 実空間をスキャンした室内データセット Replica の部屋で、音源に向かうナビゲーションを最後まで走らせました。
- 音の反響を再現した観測データを自前で用意 ― 距離や反射に応じた着信音の聞こえ方を再現し、観測として与えました。
- 概念デモ動画の作成 ― 実シーン(Replica)+実際の着信音を組み合わせた、動きの分かるデモを作りました。
次にやること(保留中・正直に)
- DescRL の完全な再学習は準備中 ― 「先生 AI で説明を生成 → 蒸留」まで含めたゼロからの学習パイプラインは、まだ組み立て途中です。
- 論文の全数値の完全再現は保留 ― 論文が報告する各ベンチマークの数字を突き合わせるには公式の学習済み重みが必要ですが、現時点で未公開のため、完全再現は保留にしています。
実データで動かした様子
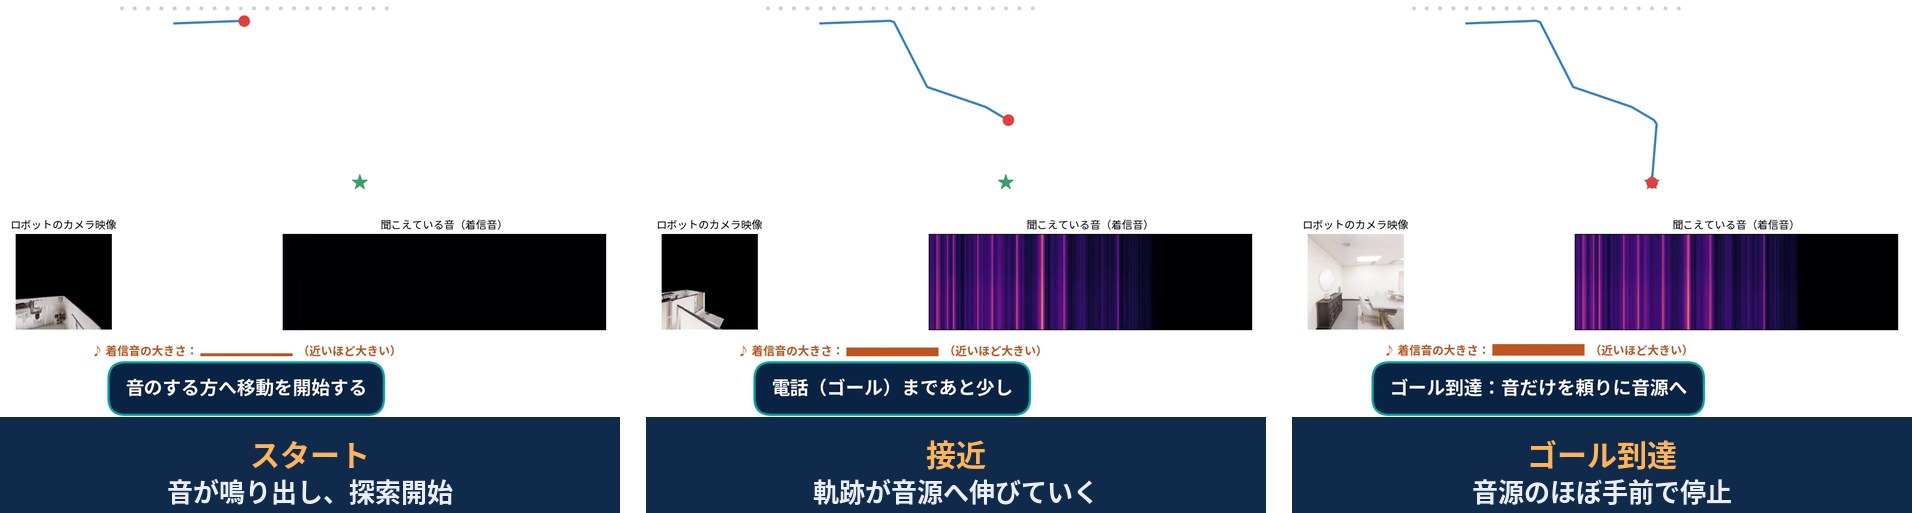
この1エピソードで当社が確認できたのは、次の通りです(論文の集計値とは別の、当社が実際に走らせて観測した値です)。
- ゴールのすぐ手前(約 1.0 m)まで正しく近づけた ― 学習済みモデルが、実際の部屋で音源へ到達。
- 道のりの効率も良好 ― その回の SPL(成功率×道の効率、0〜1)は約 0.8。まっすぐに近い経路で近づけました。
- 動作は安定 ― 32 ステップで、最後までふらつかずに移動しました。
「読む → 環境を組む → 学習済みモデルを実シーンで走らせる → 中身を理解して改造できる状態にする」までをやり切ることで、論文の主張がどこまで実用に効くかを、自分たちの目盛りで測れるようになります。これが当社の言う技術の「手の内化」です。数値の完全再現という“最後の一歩”は、公式重みの公開や再学習パイプラインの完成を待って詰めていきます。
まとめ
- 主張 ― ナビの強化学習に「行動を言葉で説明する」補助タスクを足すと、説明可能性だけでなくナビ性能そのものが上がる。従来の「説明できると性能が落ちる」トレードオフを覆した。
- 仕組み ― 説明の正解は学習済み VLM が自動生成し、エージェントはそれを知識蒸留で取り込む。目的式は L = LRL + λ × L(説明文の一致)(λ=0.1)。推論時は教師 VLM 不要で自己完結。
- 効き方 ― 過去の行動を説明させる(P-AD)が最も効果的で、音が消える SAVNav で最大の効果。論文の報告値では SR/SPL/SWS がいずれも改善(SWS は +6.6)。失敗理由(早すぎる停止・取り違え)も説明文から読める。
- 当社の到達点 ― シミュレータ環境(Habitat + SoundSpaces)を構築し、公式の学習済みモデルを実際の室内3Dシーン(Replica)で走らせてナビ評価まで実行。実シーンでゴール手前 約1.0 m まで到達を確認。完全な再学習と論文全数値の再現は、正直に次段階としています。
音を頼りに動くロボットは、見守り・救助・案内といった現場に直結します。当社は、こうした先端研究を継続的に調査し、自分たちの手で動かして検証(手の内化)することで、ロボティクスの現場に効く技術を見極めていきます。デモやご相談を承っています。
参考: Haru Kondoh, Asako Kanezaki, "Embodied Navigation with Auxiliary Task of Action Description Prediction," ICCV 2025(Institute of Science Tokyo / RIKEN AIP、CVF Open Access)。本記事は当社による論文調査・再現実装の記録であり、表中の数値は上記論文の報告値、図は当社が作成した解説図・当社環境での再現出力です(論文中の図は転載していません)。