動画生成AIは、いま「品質の競争」から「速度の競争」へと重心を移しつつあります。数十秒〜数分かけて高品質な映像をつくる方向とは別に、少ないステップ数で、数秒の映像を“ほぼリアルタイム”に生成する流れが立ち上がってきました。
その先にあるのが 「対話型映像生成」 ― 会話のたびに、顔と声のある短い映像をその場で生成して返すという使い方です。本記事はFSRの技術サーベイとして、この対話型映像生成(FastH3 / MiniMax H3 系の蒸留型モデル)を取り上げ、仕組みと速度、そしてロボットHRIへの示唆を整理します。ロボットの「見る・動く」(入力側)に対する、「見せる・話す」(出力側)の候補技術として観測する、という立場です。
紹介映像
なぜ「対話型映像生成」を追うのか
テキストで応答するLLMだけでは、対面のコミュニケーションとしては物足りない場面があります。表情・口形・短い発話映像は、対人/対ロボットの場での「社会的な存在感」を大きく左右します。
- 動画生成は品質競争から速度競争へ移りつつある。
- 少ないステップ(4-step など)で、数秒の発話クリップを準リアルタイムに出せるようになってきた。
- FSRはこれを、入力側の知覚(見る・動く)と対になる「出力側の顔と声(見せる・話す)」として観測している。
周辺技術マップ ― どこに位置する技術か
まず、この技術が技術地図のどこにあるかを押さえます。
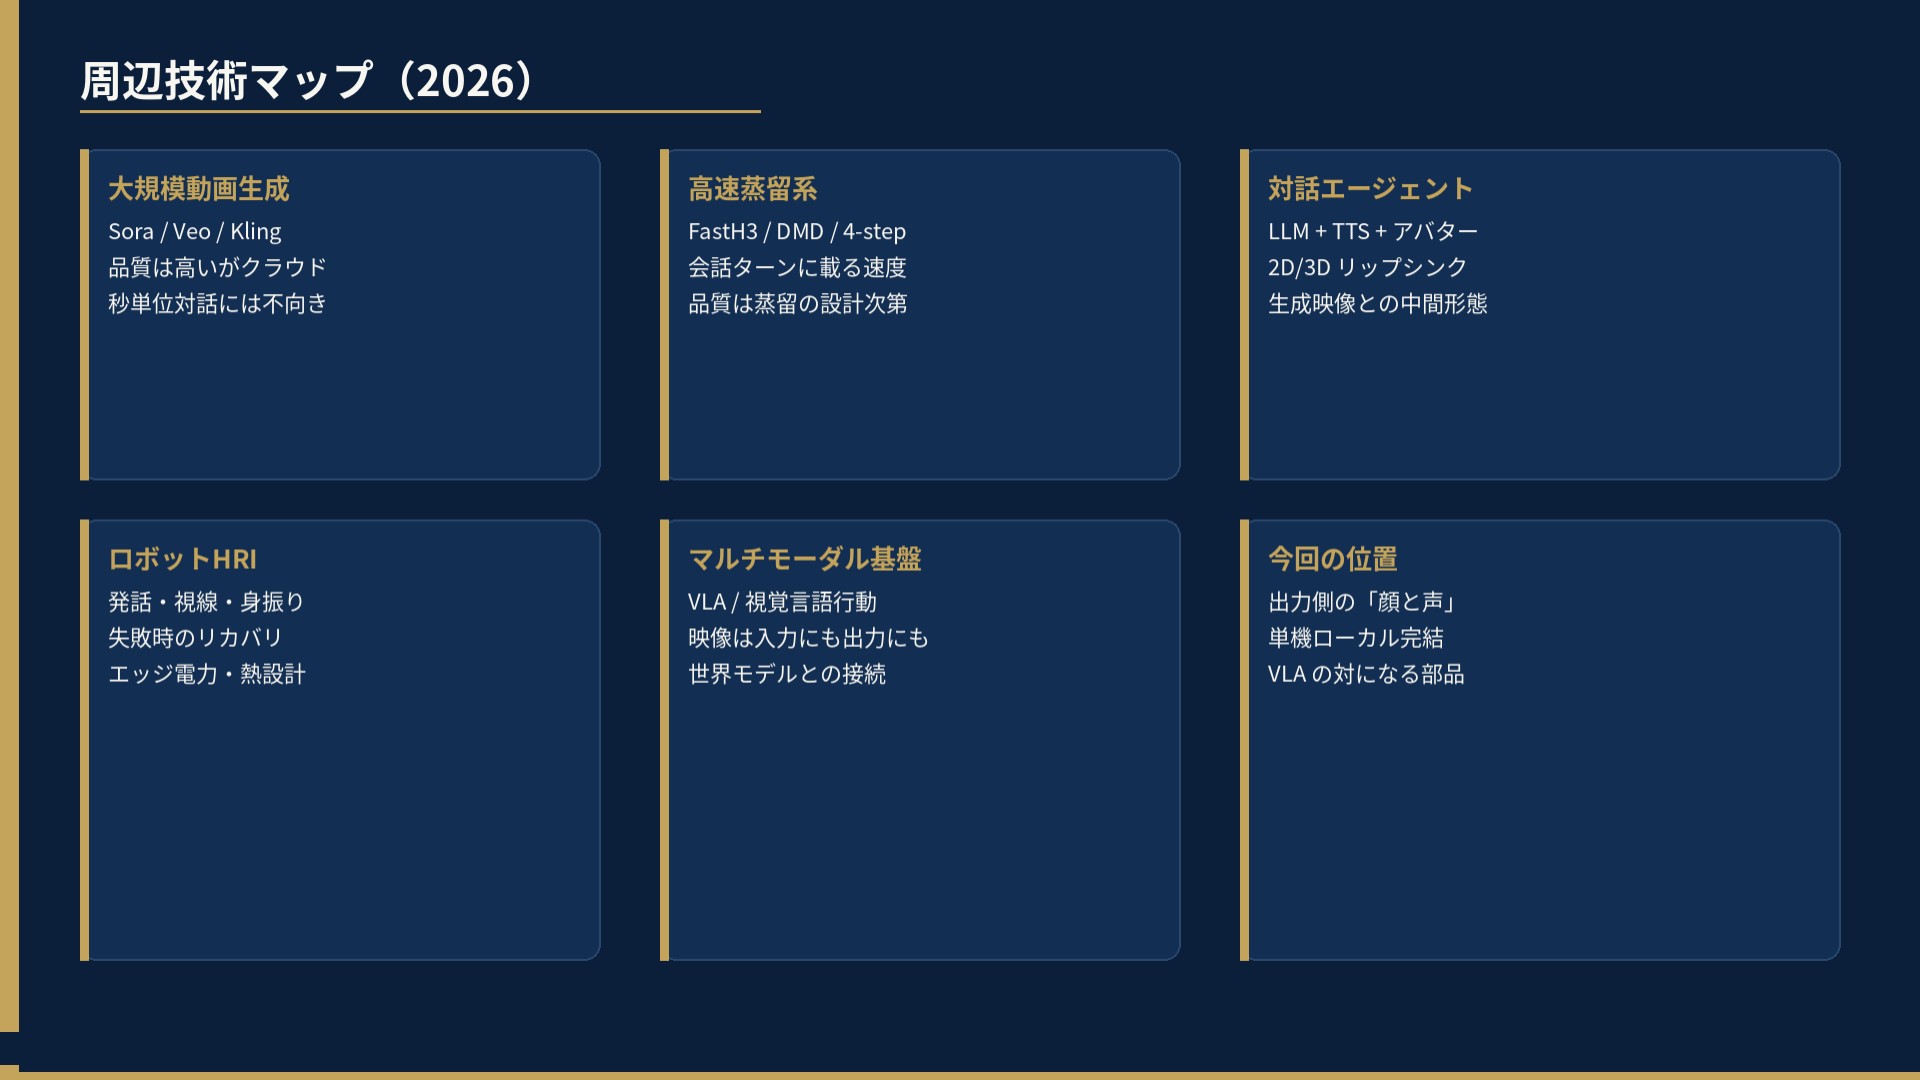
大規模クラウド生成が品質特化であるのに対し、対話型映像生成は「短く・速く・会話のリズムに乗る」ことを優先します。同じ動画生成でも、目指す地点が異なります。
処理パイプライン ― 会話からクリップまで
対話型映像生成は、発話 → 映像を一続きのパイプラインでつなぎます。
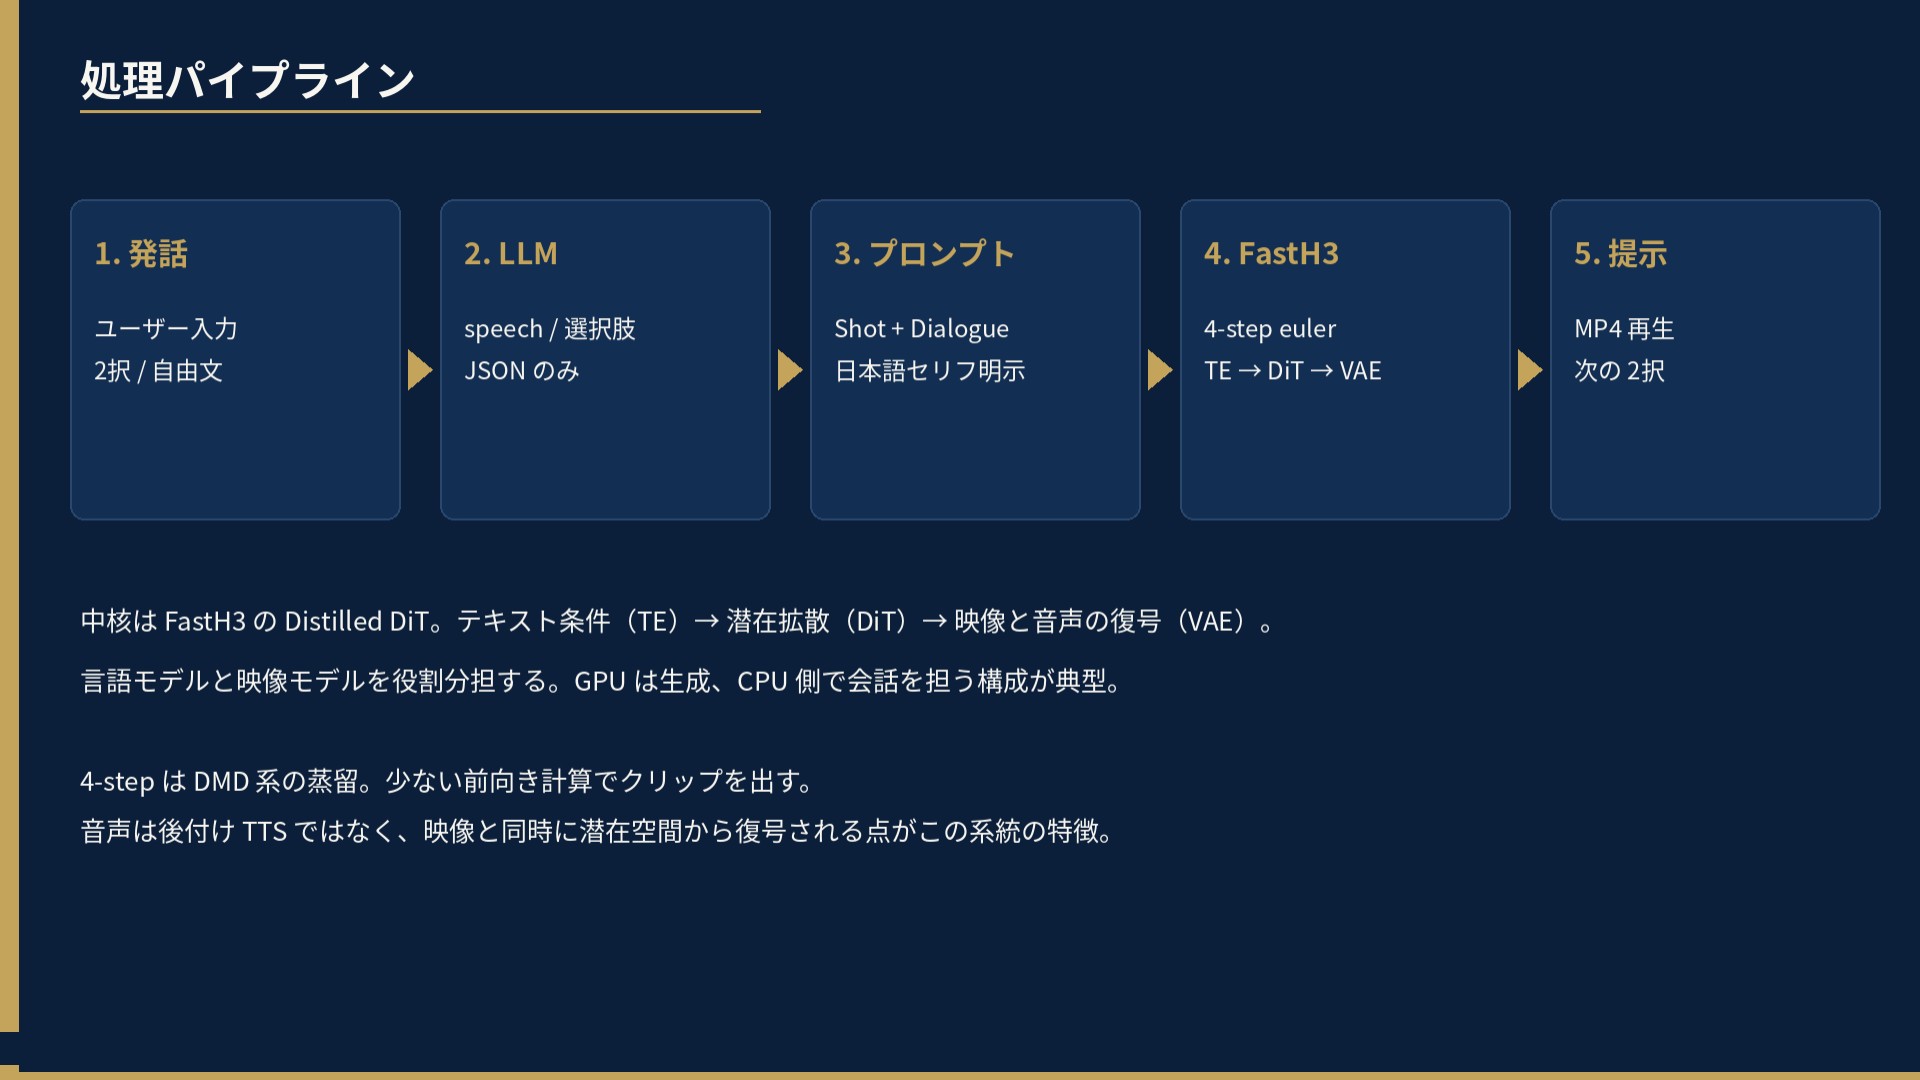
中核は、少ないステップで生成できるよう蒸留した拡散トランスフォーマ(Distilled DiT)です。フルステップの拡散を 4-step(DMD系の蒸留)に圧縮することで、少ない計算で短いクリップを出します。音声は後付けのTTSではなく、映像と同時に潜在空間から復元されるのが、この系統の特徴です。
速度の位置づけ
どのくらい速いのか。RTX 4090・320×320・5秒クリップという条件での目安です。
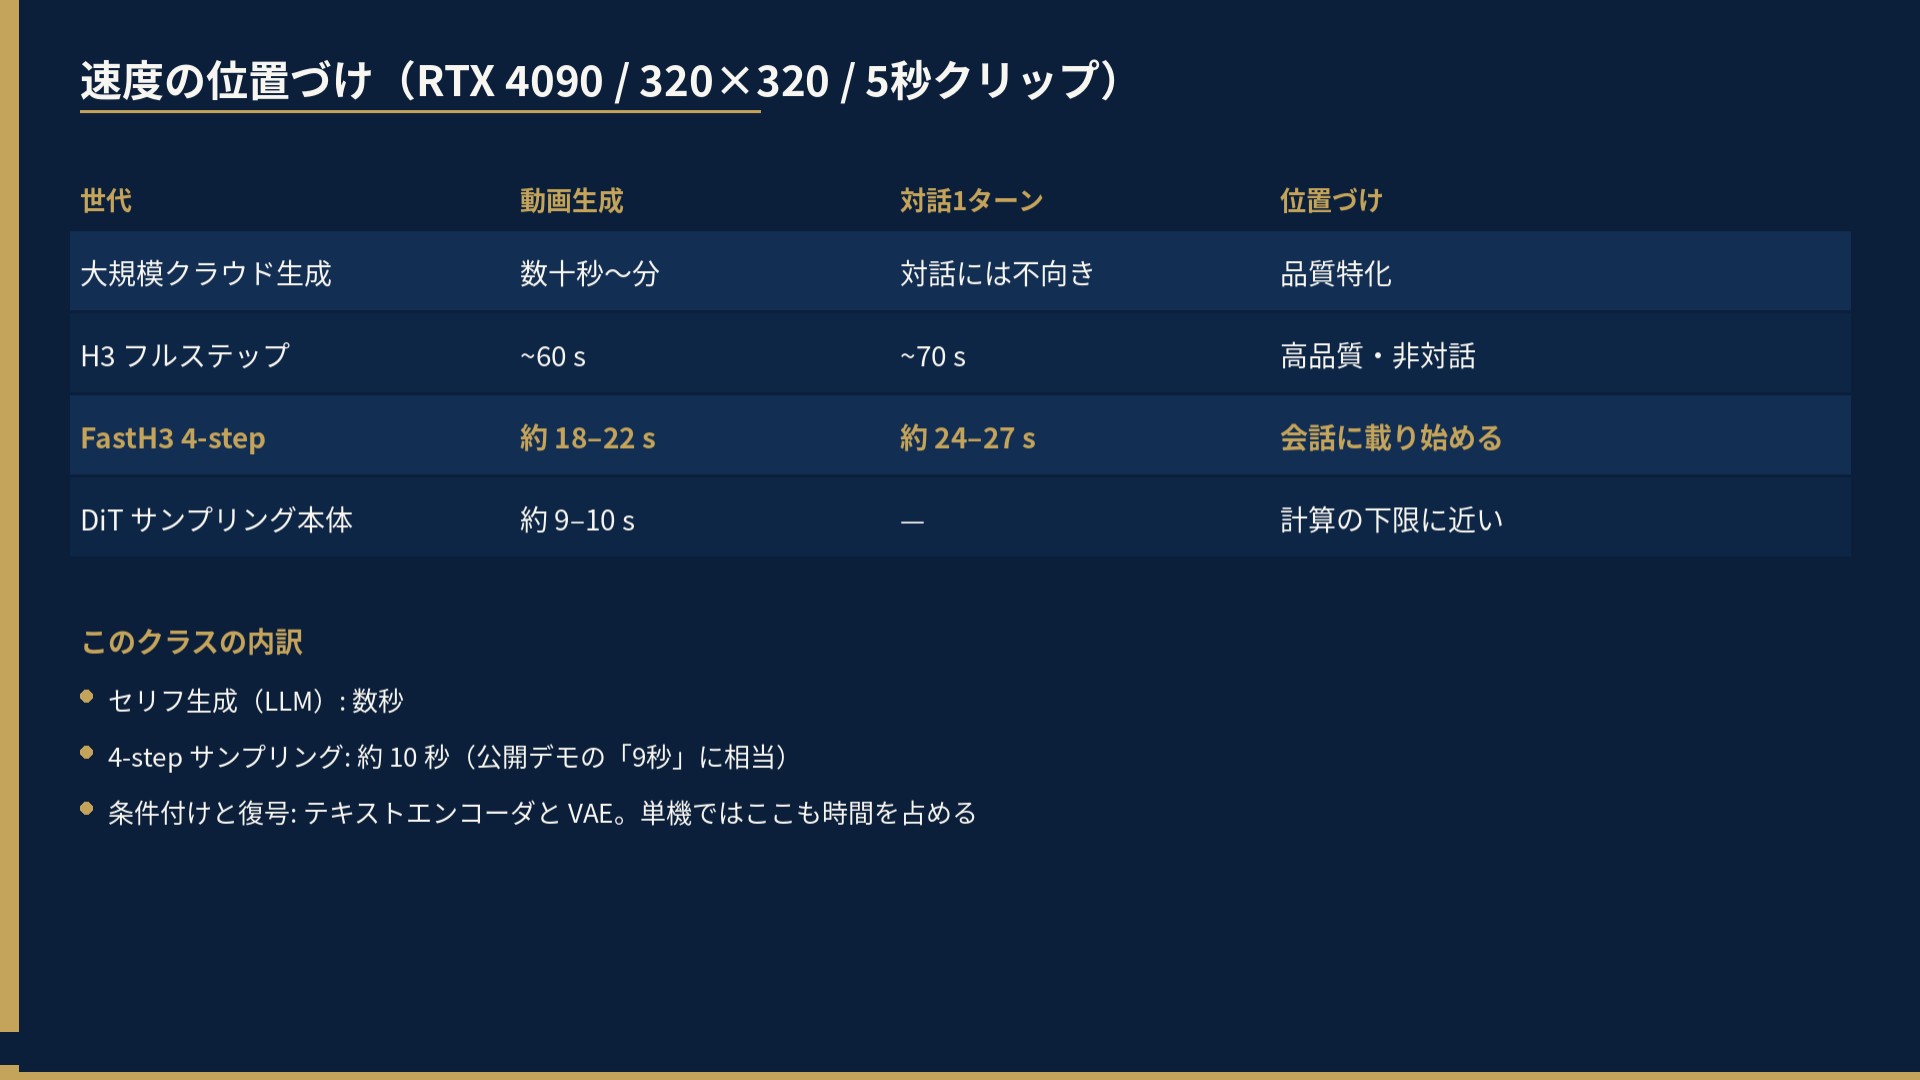
| 世代 | 5秒クリップ生成 | 対話1ターン | 位置づけ |
|---|---|---|---|
| 大規模クラウド生成 | 数十秒〜分 | 対話には不向き | 品質特化 |
| H3 フルステップ | 約60秒 | 約70秒 | 高品質・非対話 |
| FastH3 4-step | 約18〜22秒 | 約24〜27秒 | 会話に載り始める |
| DiT サンプリング本体 | 約9〜10秒 | — | 計算の下限に近い |
「対話1ターン」には、セリフ生成(LLM)とサンプリング、条件付けと復号が含まれます。まだ“会話のテンポ”には届きませんが、載り始めた、というのが現状の見立てです。
生成映像の例
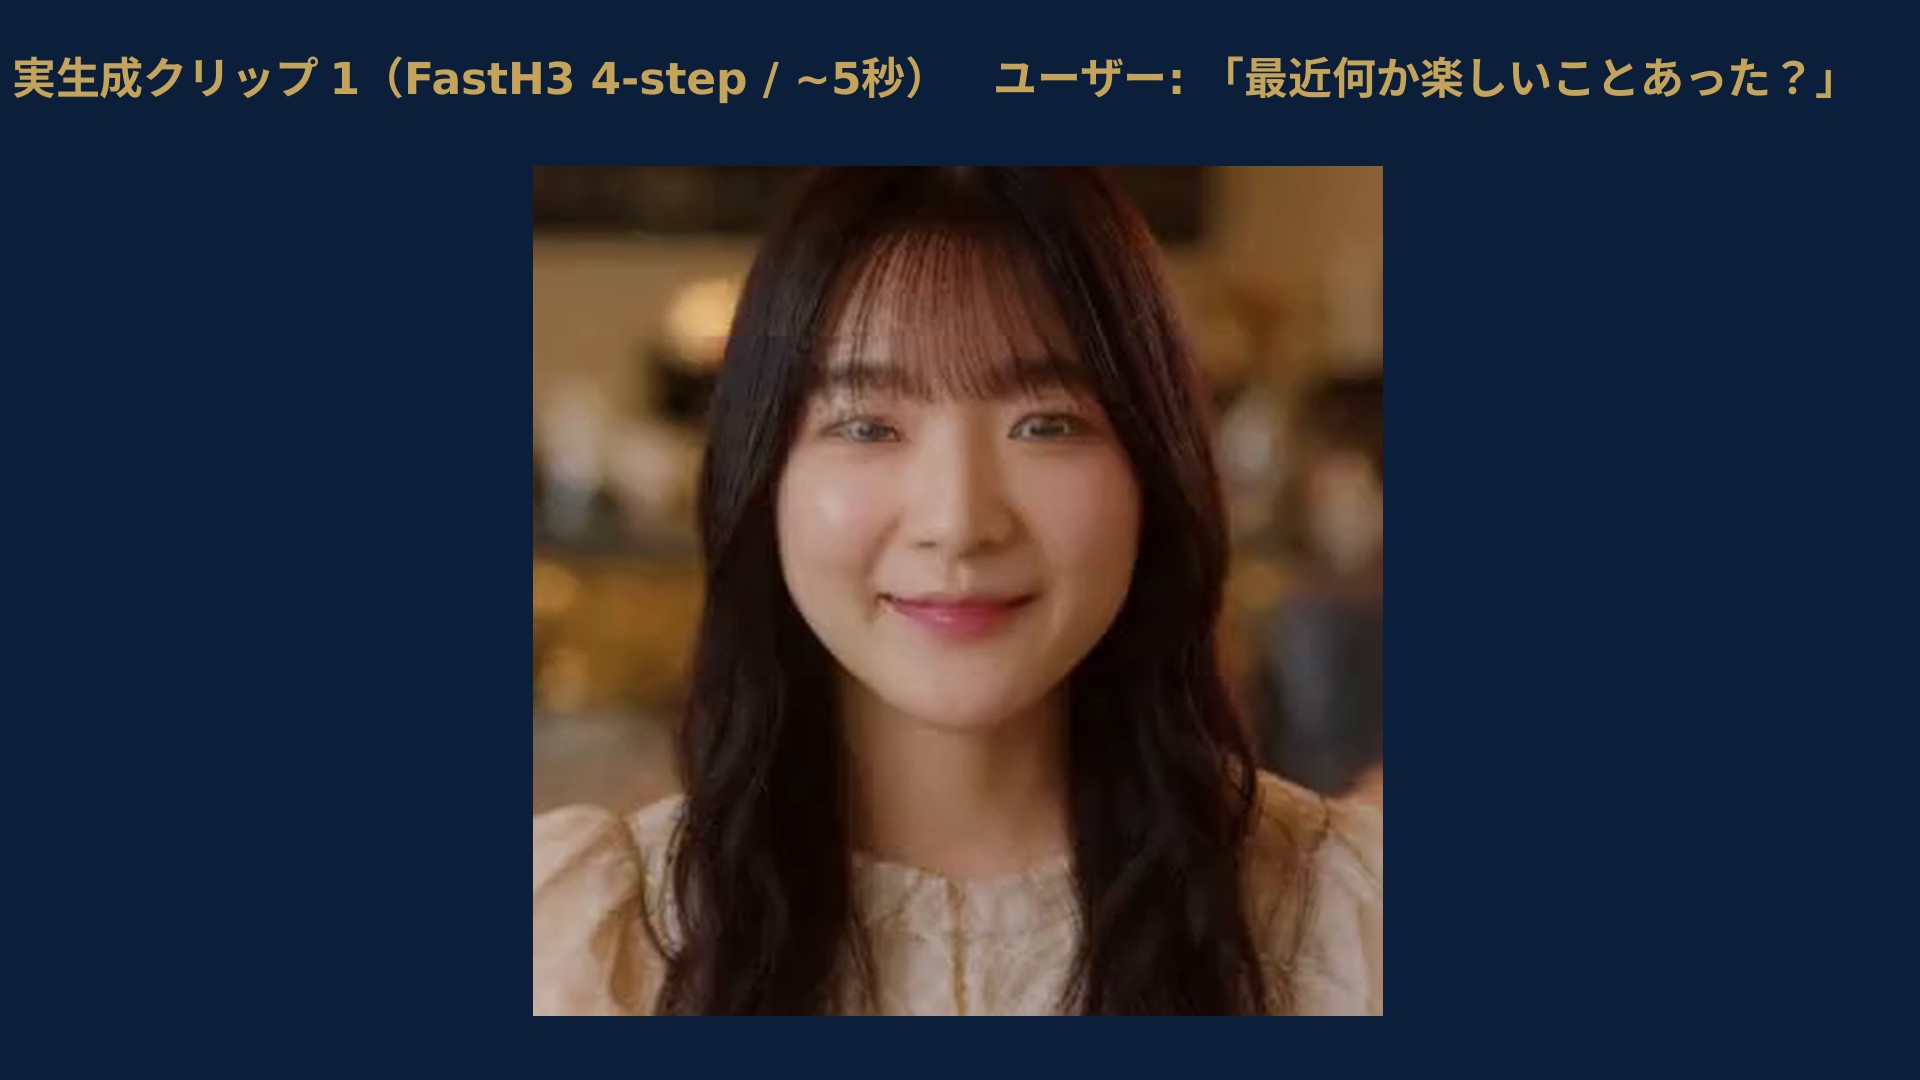
以下は、この技術が実際に出す生成クリップです(解像度 320×320・長さ 約5秒・映像と音声を同時生成)。会話の入力に対して、その場で人物の映像と音声が返ります。
技術の要点
サーベイとして押さえておきたい要点は4つです。
- Few-step 蒸留 ― フルステップの拡散を数ステップに蒸留し、対話クリップ向けの速度に寄せる。
- 映像と音声の同時生成 ― 口形と声を後付けで合わせるのではなく、生成過程で同時に出す。
- 参照条件付け(first frame) ― 参照画像で人物を固定し、ターンをまたいで同一人物として応答させる。
- ローカル完結 ― クラウドAPIに頼らず、単一GPUで対話ループを回せる方向。
ロボット/HRIへの示唆
FSRの視点で重要なのは、これがロボットの対話応答に「映像チャネル」を与えうる点です。いますぐ全機に載る技術ではありませんが、受付・案内・遠隔操作の“顔”や、ソーシャルロボットの短い応答クリップといった用途が視野に入ります。
ロボットの「見る・動く」(VLA=入力・行動)に対して、「見せる・話す」(出力・提示)を担う層。この対応づけで技術を観測しています。実装としては次の段階であり、まずは一貫性のある人物ID・低遅延・省電力が課題です。
技術サーベイの観点 ― 今後どこを見るか
継続してチェックしていく観点を、あらためて整理します。
| 観点 | 見るポイント |
|---|---|
| 遅延 | 発話開始までの時間。ターン全体か、サンプリングだけか |
| 一貫性 | 同一キャラが10ターン持つか。服装・声・顔のドリフト |
| 失敗 | 無言・破綻・遅延。ロボットは黙るより「待って」と言える方がよい |
| 電力 | 4090級は機体に載らない。蒸留と量子化で下限を追う |
| 倫理 | 実在人物の顔・なりすまし、低年齢向け利用への配慮 |
| 統合 | LLM・VLA・制御ループと“時計”を合わせられるか |
とりわけ倫理は外せません。顔つきの映像を生成する技術は、なりすまし(実在人物の顔の悪用)や利用者の年齢配慮といった論点と常に隣り合わせです。FSRとしては、AI生成であることの明示と用途の限定を前提に、慎重に扱う技術として位置づけています。
まとめ
- 対話型映像生成は、会話に「顔と声」の映像チャネルを載せる最初の実用帯に入りつつあります。
- FastH3 4-step は、RTX 4090で5秒クリップを約18〜24秒(サンプリング本体は約9〜10秒)。まだテンポには届かないが、載り始めた。
- いま見るべきは品質の極致ではなく、「対話のリズムに顔と声が乗る」こと。
- ロボットには遅延・一貫性・電力の課題が残るものの、出力層の候補として有望。
- FSRは、これを VLA(見る・動く)の対になる「見せる・話す」技術として、継続的にサーベイしていきます。
対話型映像生成の技術動向について、ご相談・情報交換を承っています。