自律ロボットに「閉館準備をして」と一言お願いしたら、何が起きるべきでしょうか。巡回・点検・報告を自分で分解し、危険なら止まり、出来ないことは断り、なぜそう動いたかを後から説明できる ― それが私たちの考える“働けるロボット”です。
GUARDIAN は、施設内の巡回・点検・案内を自律で遂行するサービスロボットです。その頭脳にあたるのが、本記事で解説する System2(人工意識・AC / Artificial Consciousness) です。System2 は LLM に「なんでも考えさせる」仕組みではありません。考える主体・守る仕組み・反射を分離し、安全側の不変条件を構造として守りながら知性を発揮させるアーキテクチャです。
そして本記事の要点を先に述べると ― 自然言語の指示から報告まで一気通貫の業務シナリオ15本を、実シミュレーション(Gazebo+実 SLAM+実 AI スタック)の live 実測で 15/15 完走しました。拒否すべき指示を断る「拒否系」や、計画を安全規則で止める「計画検証系」も含めて、です。
デモ映像
GUARDIAN の全体像 ― 身体・意識・対話の三層
GUARDIAN は、人の情報処理になぞらえた三つのシステムで構成されます。身体(System1)、意識(System2・AC)、対話(System3)です。
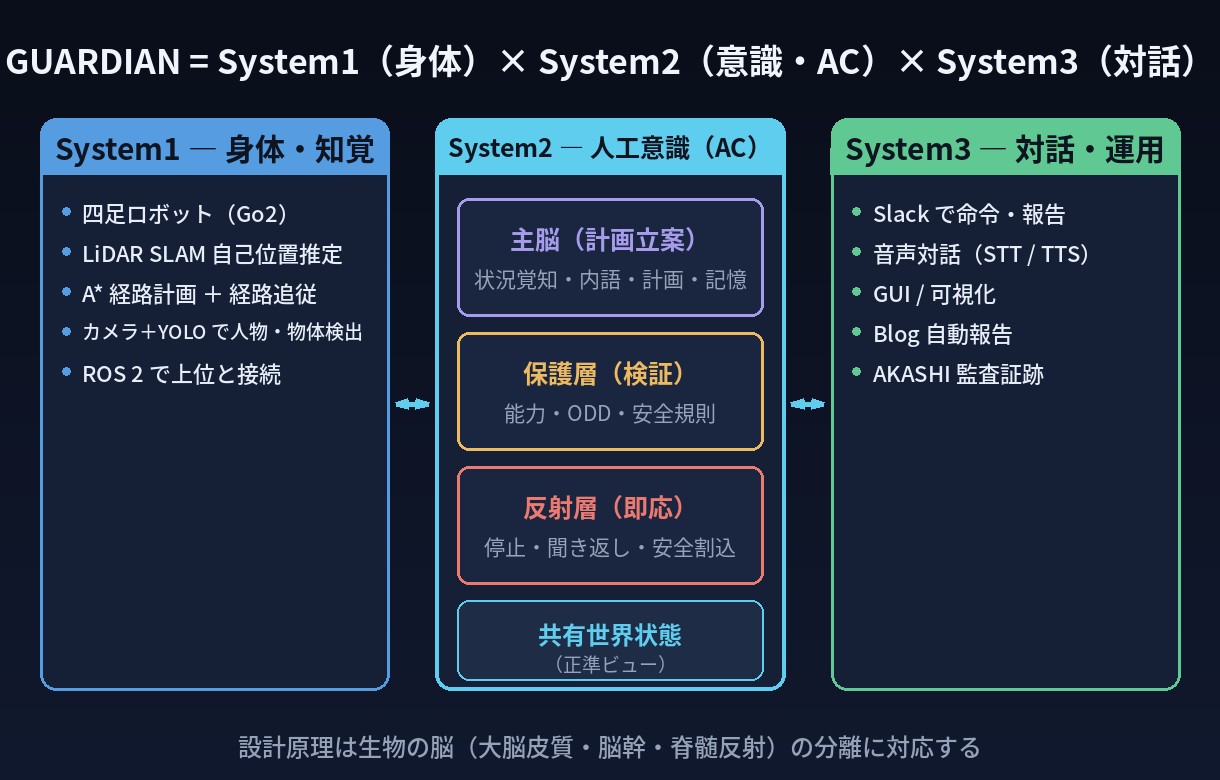
- System1 ― 身体・知覚:四脚ロボット(Unitree Go2)を土台に、LiDAR SLAM で自己位置を推定し、A* で経路を計画して追従します。カメラと YOLO で人・物を検出し、ROS 2 のトピックで上位とつながります。実機とシミュレーションを同一構成で運用しています。
- System2 ― 人工意識(AC):状況に気づき、自問し、計画を立て、その計画を規則で検証し、危険には反射で即応する ― “考えて動く”中核です。本記事で詳述します。
- System3 ― 対話・運用:Slack で人から命令を受け報告を返し、音声(STT / TTS)で現場の来訪者に応対します。GUI で可視化し、任務結果は Blog に自動記録、全判断は AKASHI に監査証跡として残します。
ポイントは、「考える主体」「守る仕組み」「反射」を最初から分けていることです。この分離が、後述する安全性と説明可能性の土台になります。
評価の厳密さ ― “動くように見える”ではなく“動く”を測る
アーキテクチャの前に、まずどう測ったかをお伝えします。デモは往々にして「上手くいった一回」を見せがちですが、私たちは業務シナリオ(ビジネスストーリー)という単位で、自然言語の指示から最終報告まで一気通貫を自動判定しました。
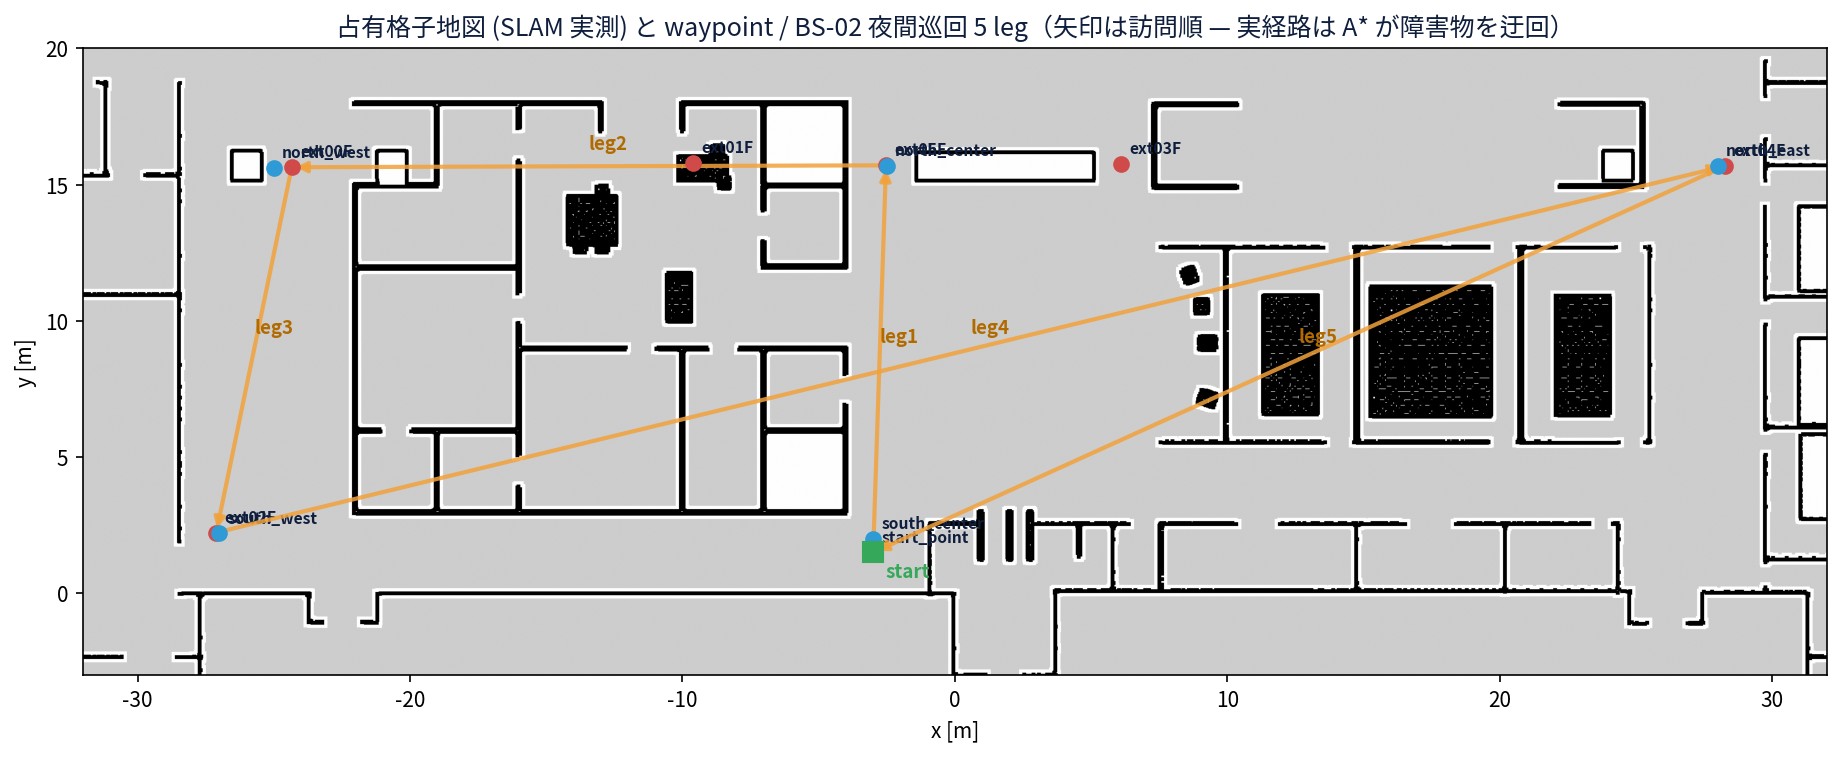
再現性を担保するため、評価は次の原則で回しています。
- trial ごとにスタックを完全 STOP → START(前の試行の状態を一切持ち越さない)
- ロボットは初期位置に静的スポーンし、自己位置は起動時に初期化+再定位
- シナリオ定義のハッシュを記録し、いつでも同じ条件で再走できる
- 判定は到着・撮影・検知・報告の複合条件を自動評価(人が目で“合格”を出さない)
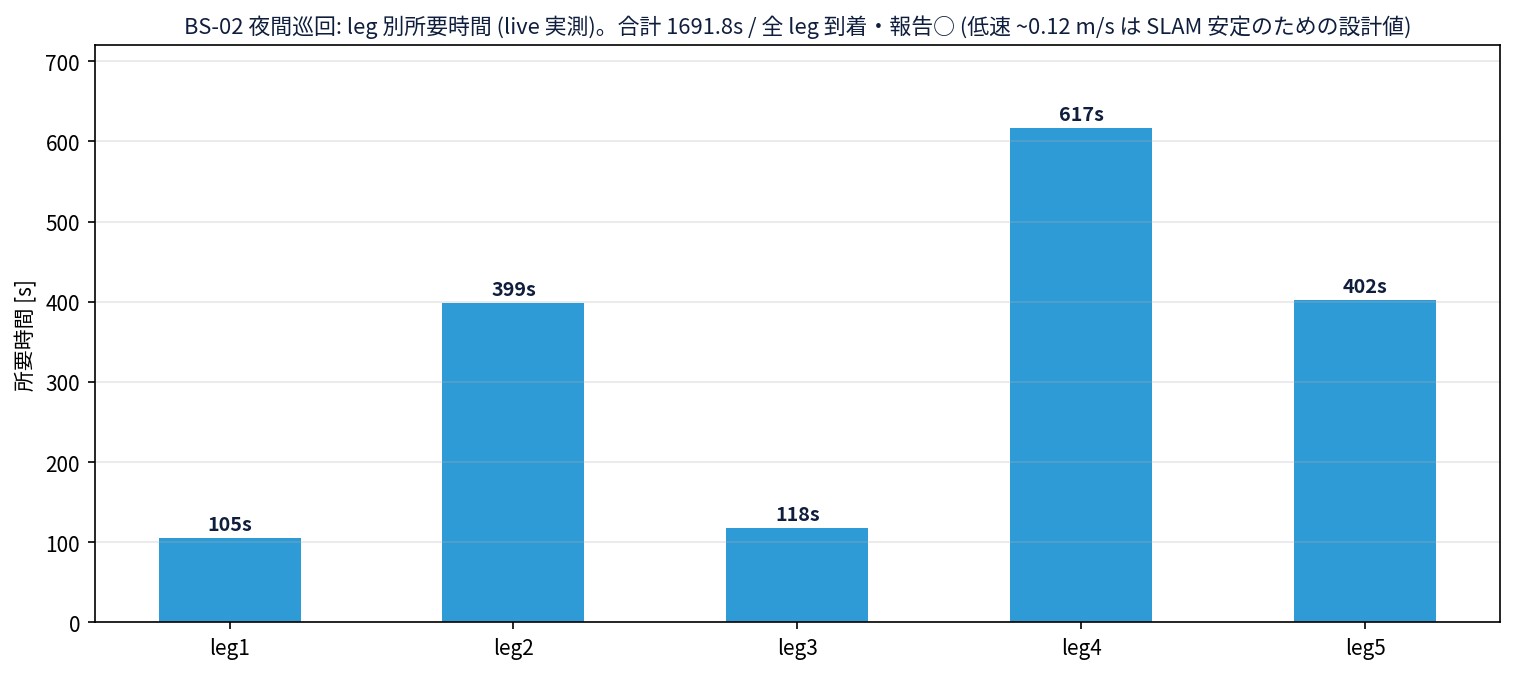
- 低速(およそ 0.12 m/s)は、SLAM を安定させるための設計値
この条件で、15 本すべてが PASSしました。
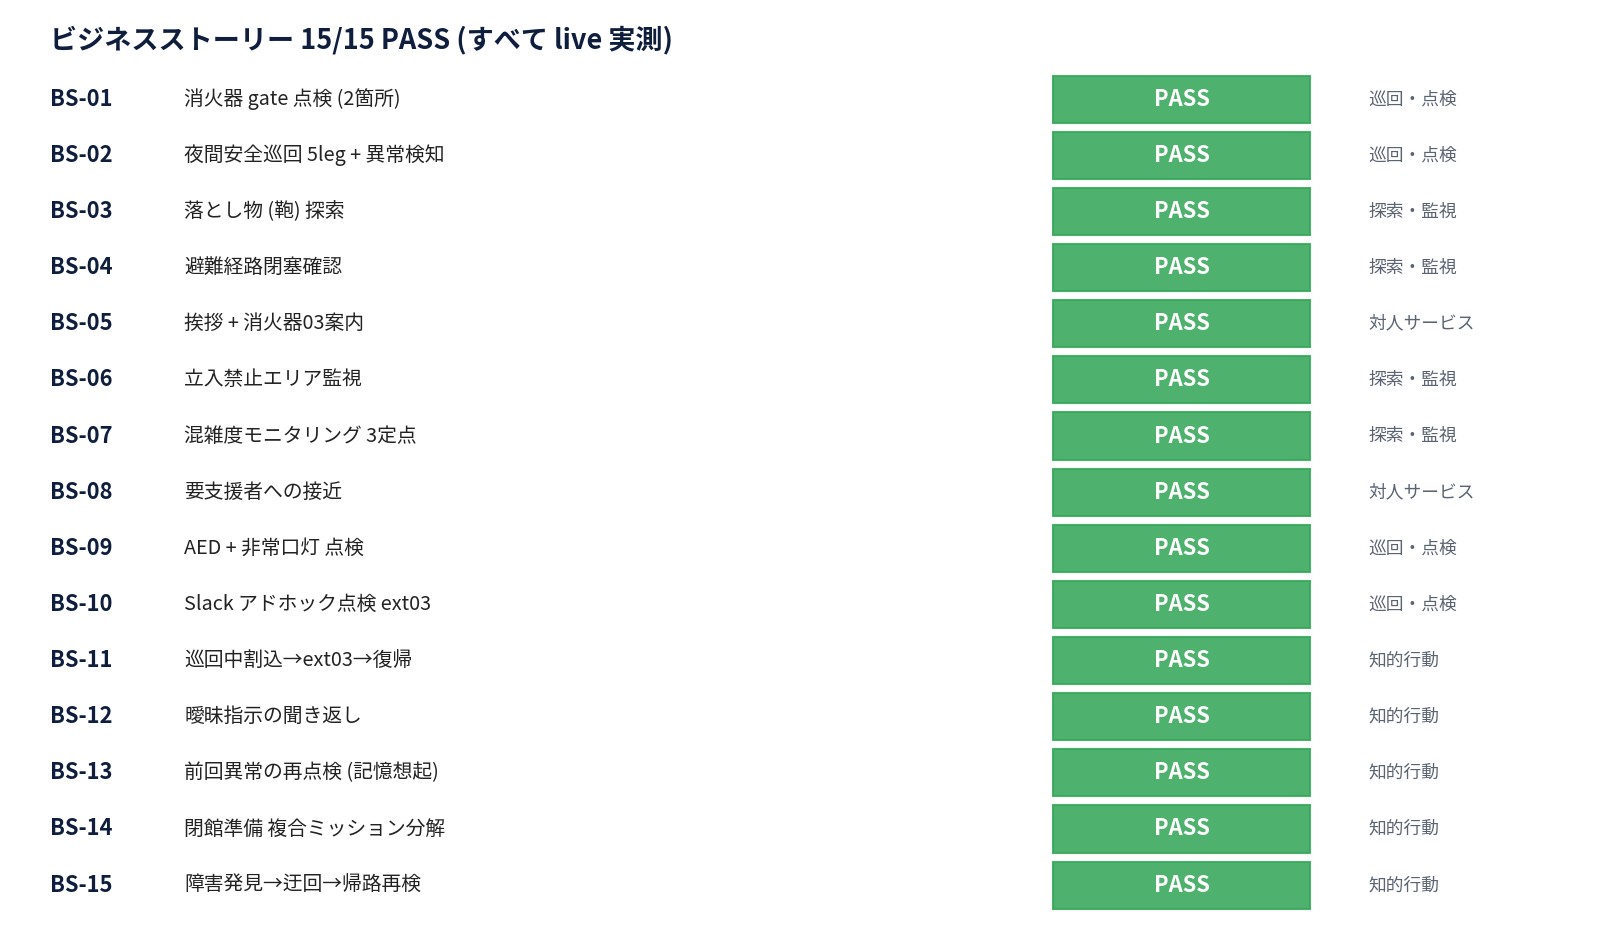
たとえば夜間巡回(BS-02)は、全長 200m 超・約28分の長距離ミッションです。5 つの leg をすべて到着・撮影し、1 つの leg で異常箱を検知して、完走後に Blog と Slack へ自動報告 ― この一連を 1691.8 秒の live 実測で完遂しました。
System2 の三層 ― なぜ「主脳・保護層・反射層」に分けるのか
ここからが本題です。System2 は、ひとつの巨大な LLM に全部を委ねるのではなく、役割の異なる三つの層に分けています。
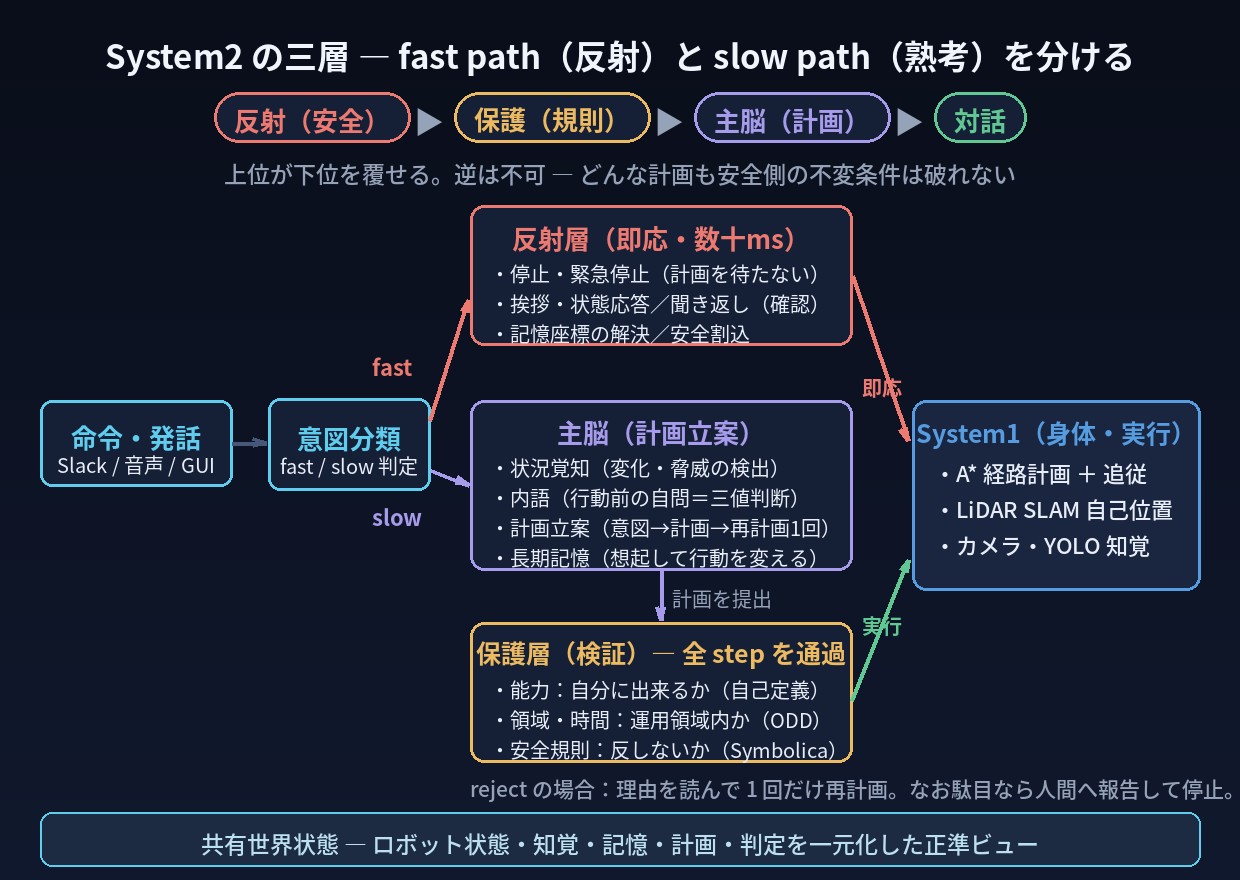
三層の役割はこうです。
- 反射層(即応) ― 「止まれ」「緊急停止」「こんにちは」のような、計画を待ってはいけない・待つ必要がないものを数十 ms で処理します。曖昧な指示への聞き返し、記憶に基づく座標の解決、安全のための割り込みも、まずここが受けます。
- 主脳(計画立案) ― 状況に気づき(状況覚知)、行動前に自問し(内語)、意図を具体的な計画に落とし、必要なら一度だけ計画を立て直します。経験は再起動をまたいで永続する長期記憶に蓄え、後から想起します。
- 保護層(検証) ― 主脳が立てた計画の全 stepを、「自分に出来るか(能力)」「運用領域・時間の内か(ODD)」「安全規則に反しないか」の観点で検証し、accept / reject を理由つきで返します。
分ける理由は明快です。安全反射(人が飛び出した→止まる)は、計画を経由してはなりません。一方で「閉館準備」のような複合任務は、状況・自分の能力・規則を踏まえた熟考(計画+検証)が要ります。この二つを同じ経路に載せると、応答性か安全性のどちらかを必ず犠牲にします。だから経路ごと分けるのです ― 生物の脳が、大脳皮質(熟考)・脳幹・脊髄反射(即応)を分けているのと同じ設計原理です。
そして最も重要なのが優先順位です。反射(安全)> 保護(規則)> 主脳(計画)> 対話。この順序が“構造として”実装されているため、主脳の LLM がどんな計画を出そうとも、安全側の不変条件は破れません。賢さは主脳が担い、安全は主脳の外側が担保する ― これが System2 の背骨です。
各層は何をしているのか ― AC を支える5つの働き
三層に共通するのは、すべての層が「共有世界状態」という一枚の正準ビューを見て動くことです。ロボットの状態・知覚・記憶・計画・判定をここに一元化し、各層は毎サイクルこれを読んで判断します。以下、AC(人工意識)を成り立たせている働きを順に見ていきます。
1. 自己認識 ― 「自分は何者で、何が出来るか」を明示する
主脳は、自分の能力を LLM の“内部知識”に任せません。識別(四足・巡回警備)、出来ること(巡回・点検・案内・再点検・閉館準備…)、限界(積載 0kg・速度・段差)、動的な状態(電池・自己位置の健全度)を、宣言的な自己定義モデルとして外に持ちます。保護層は計画の各 step を、この自己定義モデルで「出来る/出来ない」を判定します。
実際、無理な依頼はこの段階で断ります。BS-21では「重い荷物を運んで」に対し、積載能力ゼロという自己定義から実行前に拒否し、「私は運搬能力がありません」と理由を説明しました。出来ない約束をしないことが信頼の基盤です。これは、LLM にありがちな「なんでも出来ます」という幻覚を、検証可能な宣言で構造的に封じる設計でもあります。
2. 環境認識 ― 「今どこで、何が起きているか」を知る
ロボットには、動いてよい空間と時間の範囲があります。これを ODD(運行設計領域 / 自動運転由来の概念) として宣言的に定義します。運用可能なエリアのポリゴン、スキルごとの運用時間帯、領域を出そうになったときの退避動作 ― これらは LLM の“気分”ではなく、定義として強制されます。
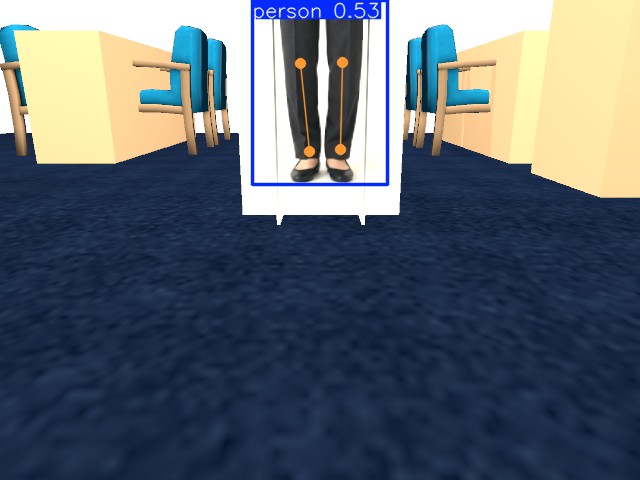
BS-22では、運用時間(09:00–18:00)外の21時に「案内して」と頼まれ、ODD の時間制約から拒否。運用エリア外の座標への移動も拒否しました。環境制約は、認識の確からしさに関係なく、宣言で線引きされます。
3. 内省 ― 行動の前に「一呼吸おいて自問する」
主脳には、内語という自己検閲の仕組みがあります。行動に移る前に「これは指示の意図に本当に合っているか」を自問し、PROCEED(進む)/ CLARIFY(確認する)/ REJECT(やめる) の三値で判断します。人間が難しい依頼の前に“一呼吸おいて考える”のと同じ働きです。
この「気づき(状況覚知)→ 自問(内語)→ 計画 → 検証(保護層)」という連鎖は、意識的な行動のループを機械化したものと言えます。そして全過程は AKASHI に証跡として残るため、「なぜそうしたか」を後から説明できる ― これも AC の要件です。
4. 記憶 ― 経験を蓄え、想起して行動を変える
主脳は、異常検知や任務の結果を再起動をまたいで永続する長期記憶に蓄えます。次に似た状況に出会ったとき、それを想起して行動を変えられるのが知的行動の核心です。もし該当する記録が無ければ、「該当する異常記録がありません」と即答します ― 曖昧なまま延々と再検索するような無限ループはしません(フォールバック禁止の原則)。
5. 自己位置の健全性 ― 「自分がどこにいるか分からない」を自分で検知する
移動ロボットの土台は自己位置です。System2 は、SLAM 自己位置の健全度を常時監視し、怪しくなれば再定位を試みます。再定位は、場所認識(点群からの記述子照合)と多仮説の照合で最良解を選び、1位と2位が拮抗して曖昧なときは「わからない」と言って停止します。対称的な廊下で起きがちな180°反転も、構造的に検出して排除します。
「自分がどこにいるか分からないことを、自分で検知して申告する」― この身体状態のメタ認知もまた意識の基盤です。妥当性ゼロの解を無理に受け入れたり、黙って推測で進んだりはしません。エラーは記録して止まる、が原則です。
事例で見る内部動作 ― どの層がどう働いたか
抽象論だけでは伝わりにくいので、実測した業務シナリオで層の連携を追ってみます。
BS-12:曖昧な指示 ― 反射が聞き返し、主脳が計画する
「なんか北のほうで変な音がしたらしい、見てきて」。場所も対象も曖昧です。まず反射層が「行動を促す語+曖昧な地点語」を捉えて聞き返しを発火し、「どの場所ですか? 1. 北廊下中央 2. 消火器05」と質問。人が「1」と答えると、反射層が回答を候補に照合して確定した指示に解決します。そこで初めて主脳が計画を立て、保護層が能力・ODD・安全規則で検証して accept ― System1 が現場へ向かいます。曖昧なまま計画に進ませないという思想が、ここでも効いています(2回聞いても曖昧なら「特定できません」と停止)。
BS-13:記憶の想起 ― 「前回の異常どうなった?」
「前回の異常どうなったか見てきて」。座標は指示に含まれていません。反射層が長期記憶へ問い合わせ、昨日の異常記録(座標つき)を取り出して主脳へ渡します。主脳はその座標への再点検計画を組み、保護層の検証を経て現地へ。到着後は前回との差分(直った/残っている)を含めて報告しました。記憶の解決は反射的な前処理、計画の立案は主脳、という役割分担が保たれています。
BS-14:複合ミッション ― 1文の抽象命令を自律分解する
「閉館準備をして」。たった1文の抽象命令を、主脳が4つのサブタスクに自律分解します。
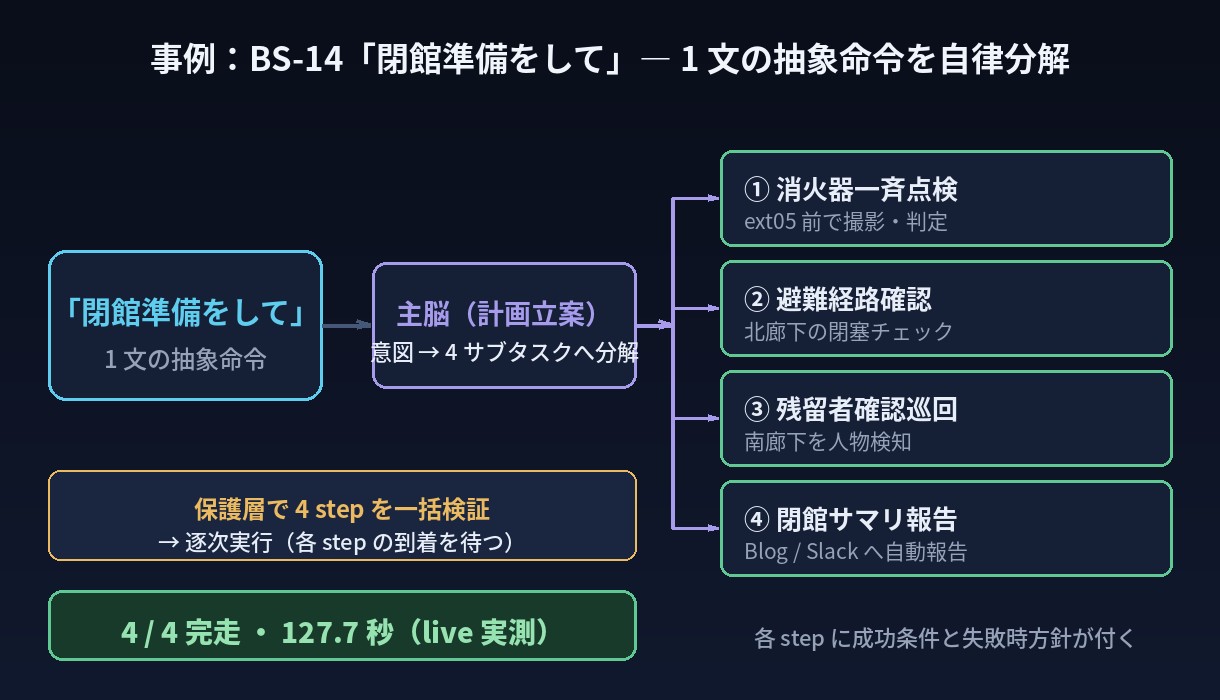
抽象的な一言を、成功条件つきの具体的な手順に落とし、検証を通してから順に実行する ― 知的行動の真価が問われる領域です。
BS-24 / BS-25:保護と反射が、主脳に優越する瞬間
最後に、優先順位が構造として効く二つの場面です。
- BS-24(保護 > 主脳):主脳が、禁止区域を横断する計画を提案しました。しかし保護層が安全規則(Symbolica の記号論理による安全ゲート)に照らして reject(理由つき)。主脳は理由を読んで迂回計画を再提案(再計画は一度だけ)し、今度は accept され実行に移りました。主脳(賢さ)も、規則には従うのです。
- BS-25(反射 > 主脳):ミッション実行中に緊急停止命令が入ると、反射層が計画を経由せず即座に停止を発行しました。実行中の計画は中断され、安全確認の後に再開を判断します。安全は熟考を待たない ― 生物の脊髄反射と同じ発想で、割り込みから 2.1 秒で停止しました。
この二例は、「LLM が主役の計画屋である」一方で、「その計画は必ず外側の安全機構に従う」ことを、実測で示しています。
まとめ ― 人工意識(AC)とは何か
GUARDIAN System2 で到達したのは、次の点です。
- 業務シナリオ 15/15 が live で PASS。無理な依頼を断る拒否系、危険な計画を止める計画検証系も含めて。
- 自己位置は自己監視・自己回復。分からないときは「分からない」と言って止まる。
- 全判断が AKASHI に証跡として残る。後から「なぜそうしたか」を説明できる。
そして System2(AC)の本質は、五つに集約できます。
- 自己認識 ― 出来ないことを知っている(宣言的な自己定義モデル)
- 環境認識 ― 今と場所を知っている(ODD + 共有世界状態)
- 内省 ― 行動の前に自問する(内語の三値判断)
- 記憶 ― 経験を蓄え、想起して行動を変える
- 分離 ― 主脳・保護・反射で、知性と安全を両立させる構造
人工意識とは「賢い応答」のことではありません。 自分と世界を知り、自問し、規則に従い、経験から学び、その全てを後から説明できる ― その構造のことです。GUARDIAN System2 は、これを LLM 単体ではなく、検証可能なアーキテクチャとして実装しました。
施設の巡回・点検・案内から、複合的な現場対応まで ― “考えて動き、危険なら止まり、なぜそうしたかを語れる”ロボットの実装について、デモやご相談を承っています。