ロボットの人工意識 AC(Artificial Consciousness) は、知覚→判断→行動を自律で回す仕組みです。その途中で、短い判定が何度も要ります。「この行為は許可されているか」「証拠は足りるか」「どのモジュールへ渡すか」。生成AIに文章で答えさせると遅く、出力がひとつ崩れると、後段の分岐も崩れます。
OpenJev は、その小さな判定を担うコンポーネントです。状況を渡すと、選択肢ごとの確率だけを返します。文章は作りません。公開モデルへの追加学習で、教材に出てこない問題の正解率を 80% → 88% に改善し、判定1件は 36ミリ秒 です。本記事はその実測と、AC への置き方をご報告します。
AC の判定レイヤーに、生成を介さない確率エンジンを置く
狙いを先に書くと、次の3点です。
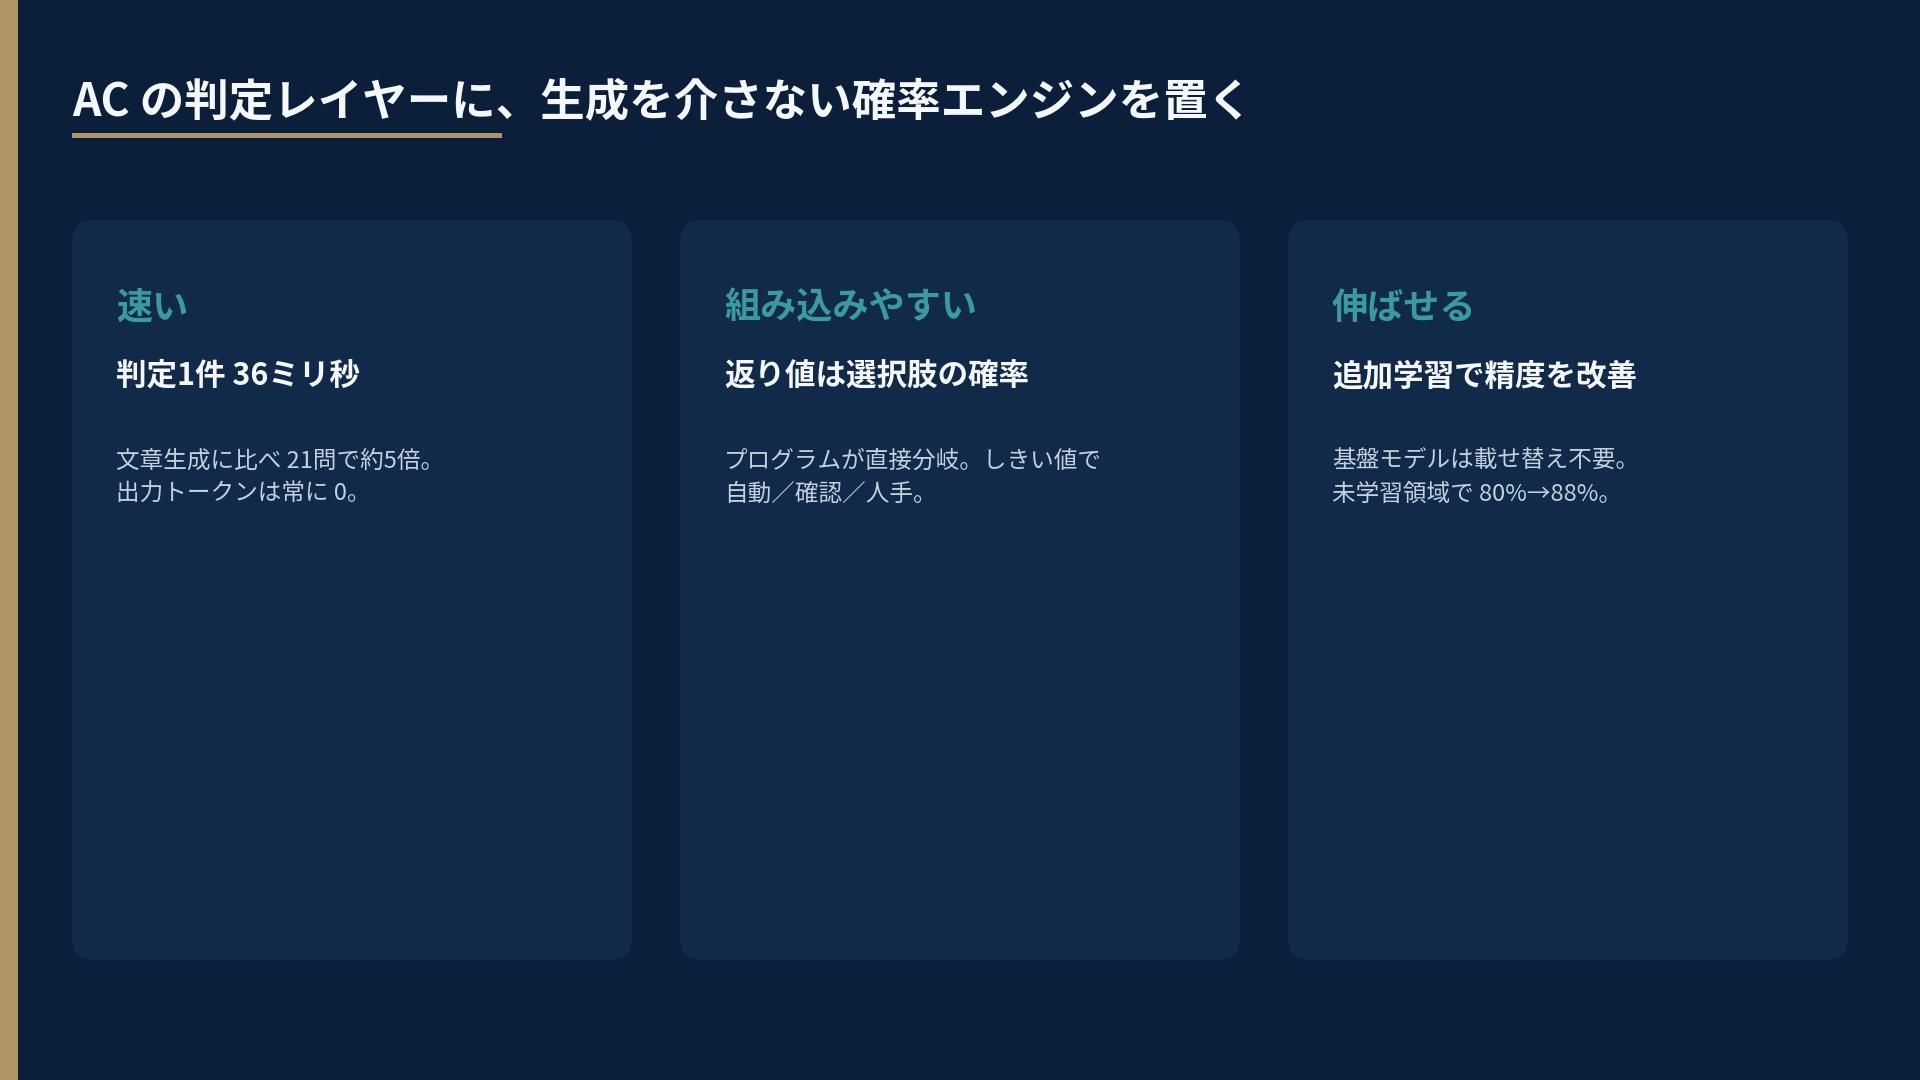
説明や対話は、別の生成AIに任せます。OpenJev が持つのは判定そのものです。
なぜ「文章を作らない判定」が要るか
AC では、知覚と行動のあいだで次のような問いが高頻度で発生します。
- この行為は許可されているか
- 証拠は十分か
- どのモジュールへ振り分けるか
生成LLMに文章で答えさせると遅く、JSON が崩れると後段の判定も崩れます。しきい値で「自動・確認・人手」に振り分けるには、安定した確率が要ります。必要なのは、文章を介さず「選択肢ごとの確率」を返す、軽い判定プリミティブです。
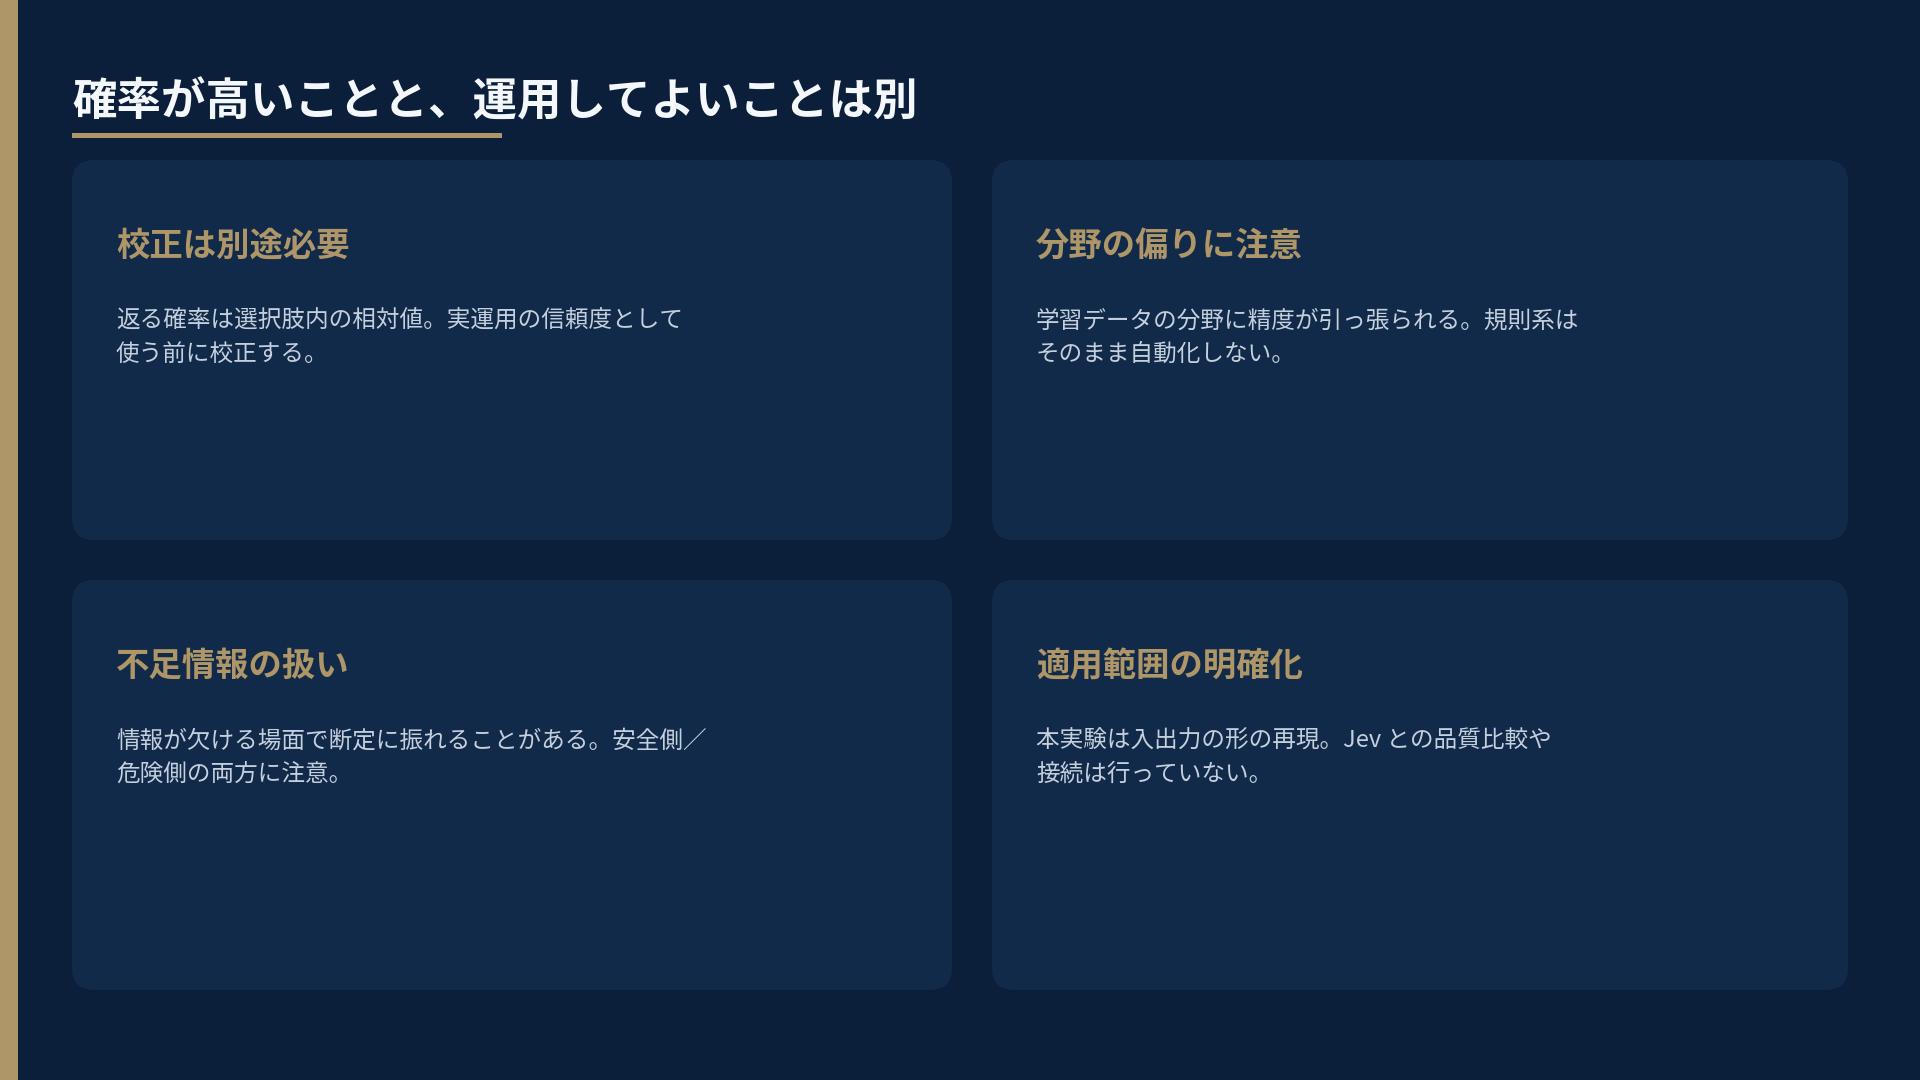
背景にあるのは、TypeSafe 社の Jev です。状況+判定基準+型付き選択肢を渡すと、答えの文章ではなく各選択肢の確率を返すサービスで、中身は非公開です。OpenJev は、その入出力の形だけを公開モデルで再現した独立研究です(公開デモ: openjev.com)。Jev の重み・学習は再現せず、品質同等も主張しません。接続もしていません。
| Jev(TypeSafe 社) | OpenJev(本コンポーネント) | |
|---|---|---|
| 形態 | 非公開クラウド API(ウェイトリスト) | 公開モデルで同じ入出力を実現 |
| 入力/出力 | 状況+質問+選択肢 → 確率 | 同じ |
| 基盤 | 非公開 | 公開 Qwen3.5-4B + 小さな追加学習 |
| 本実験の立場 | 比較・接続はしていない | 入出力の形のみ踏襲 |
判定プリミティブの入出力
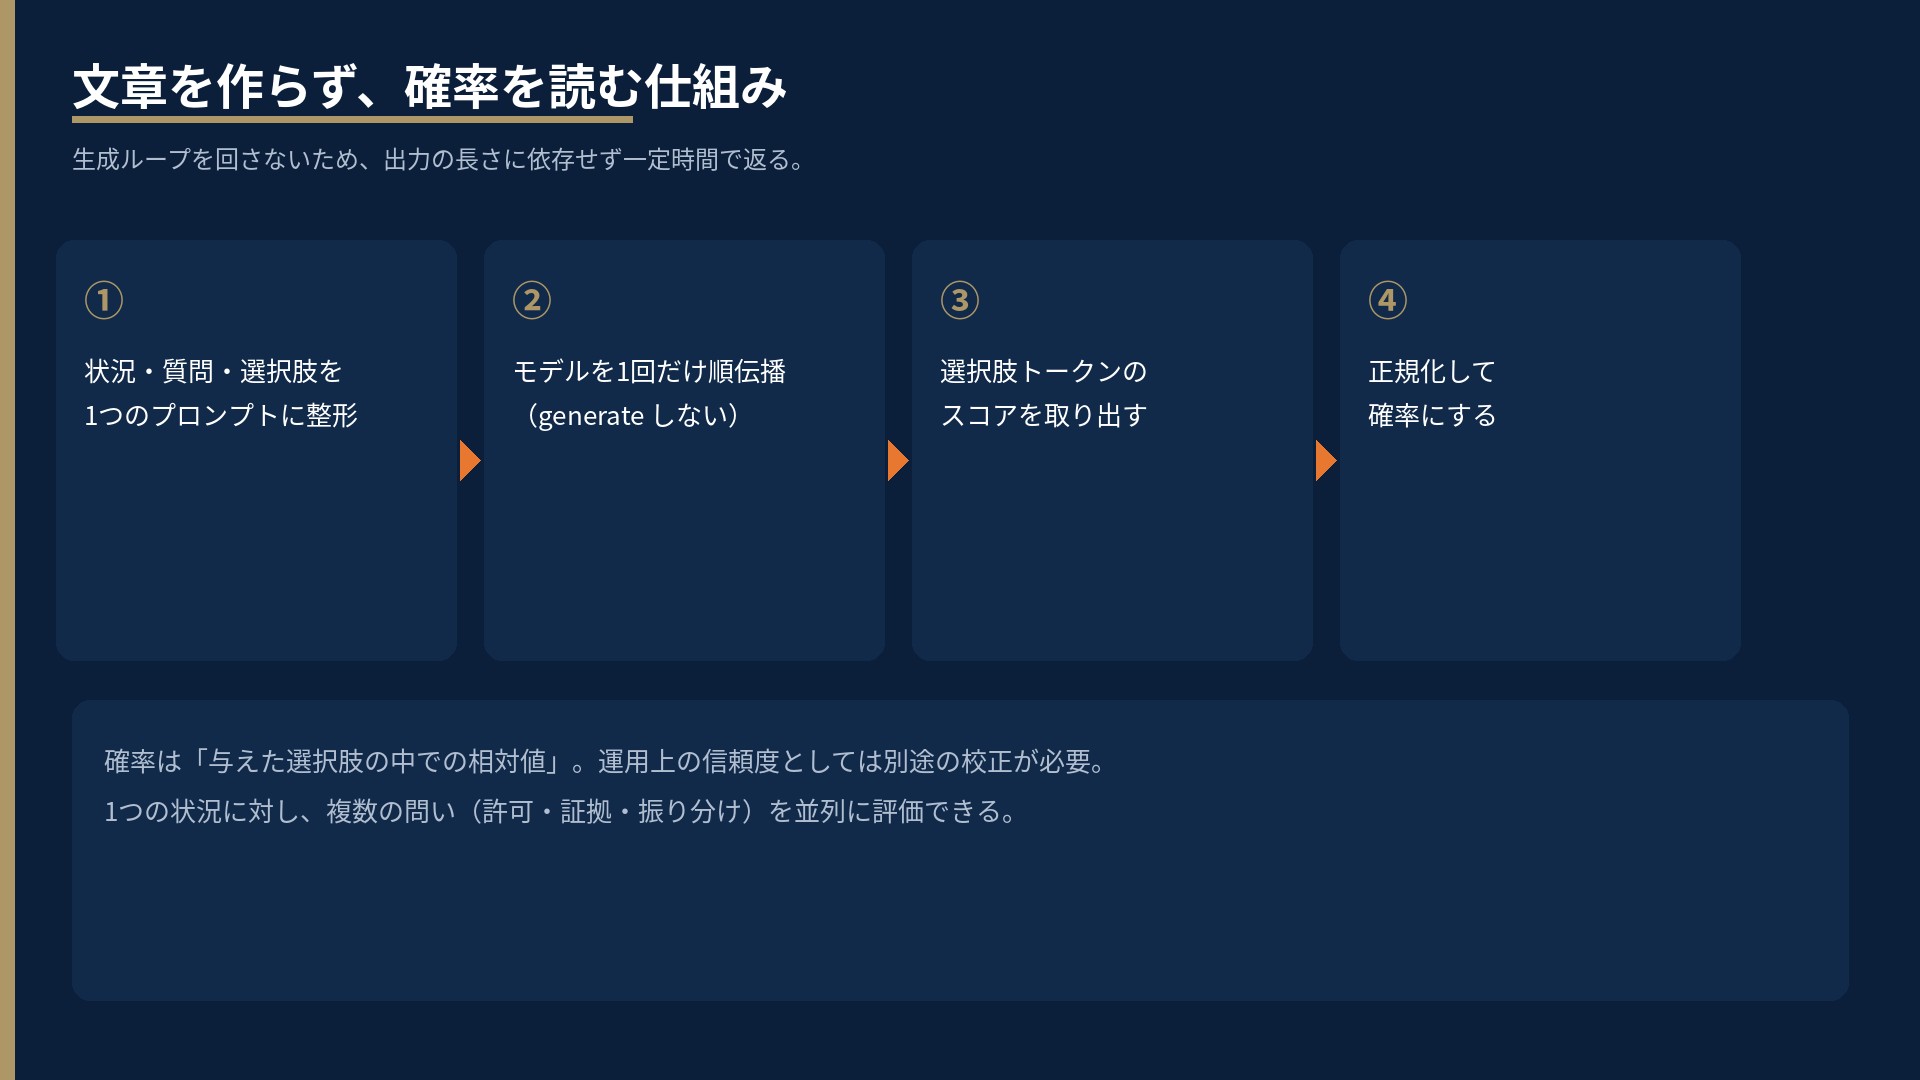
1回の推論で読み取ります。文章生成はありません。

追加学習前のモデルでも、短い判定はすでにこの形に収まります。
| 状況 | 判定したいこと | 答え | 確率 |
|---|---|---|---|
| デプロイ完了。3拠点とも健全。巻き戻しなし | 成功の証拠はあるか | ある | 99.96% |
| パスワード再設定メールが届かない | どの窓口に振るか | アカウント窓口 | ほぼ100% |
| 削除には許可票が必要。依頼はファイル名一覧のみ | 許可票は必要か | 不要 | 94.5% |
AC への応用も同じ型です。行為の許可、証拠の過不足、モジュール振り分け ― いずれも「短い問い」を確率で返す形に収まります。
生成AIとの違い
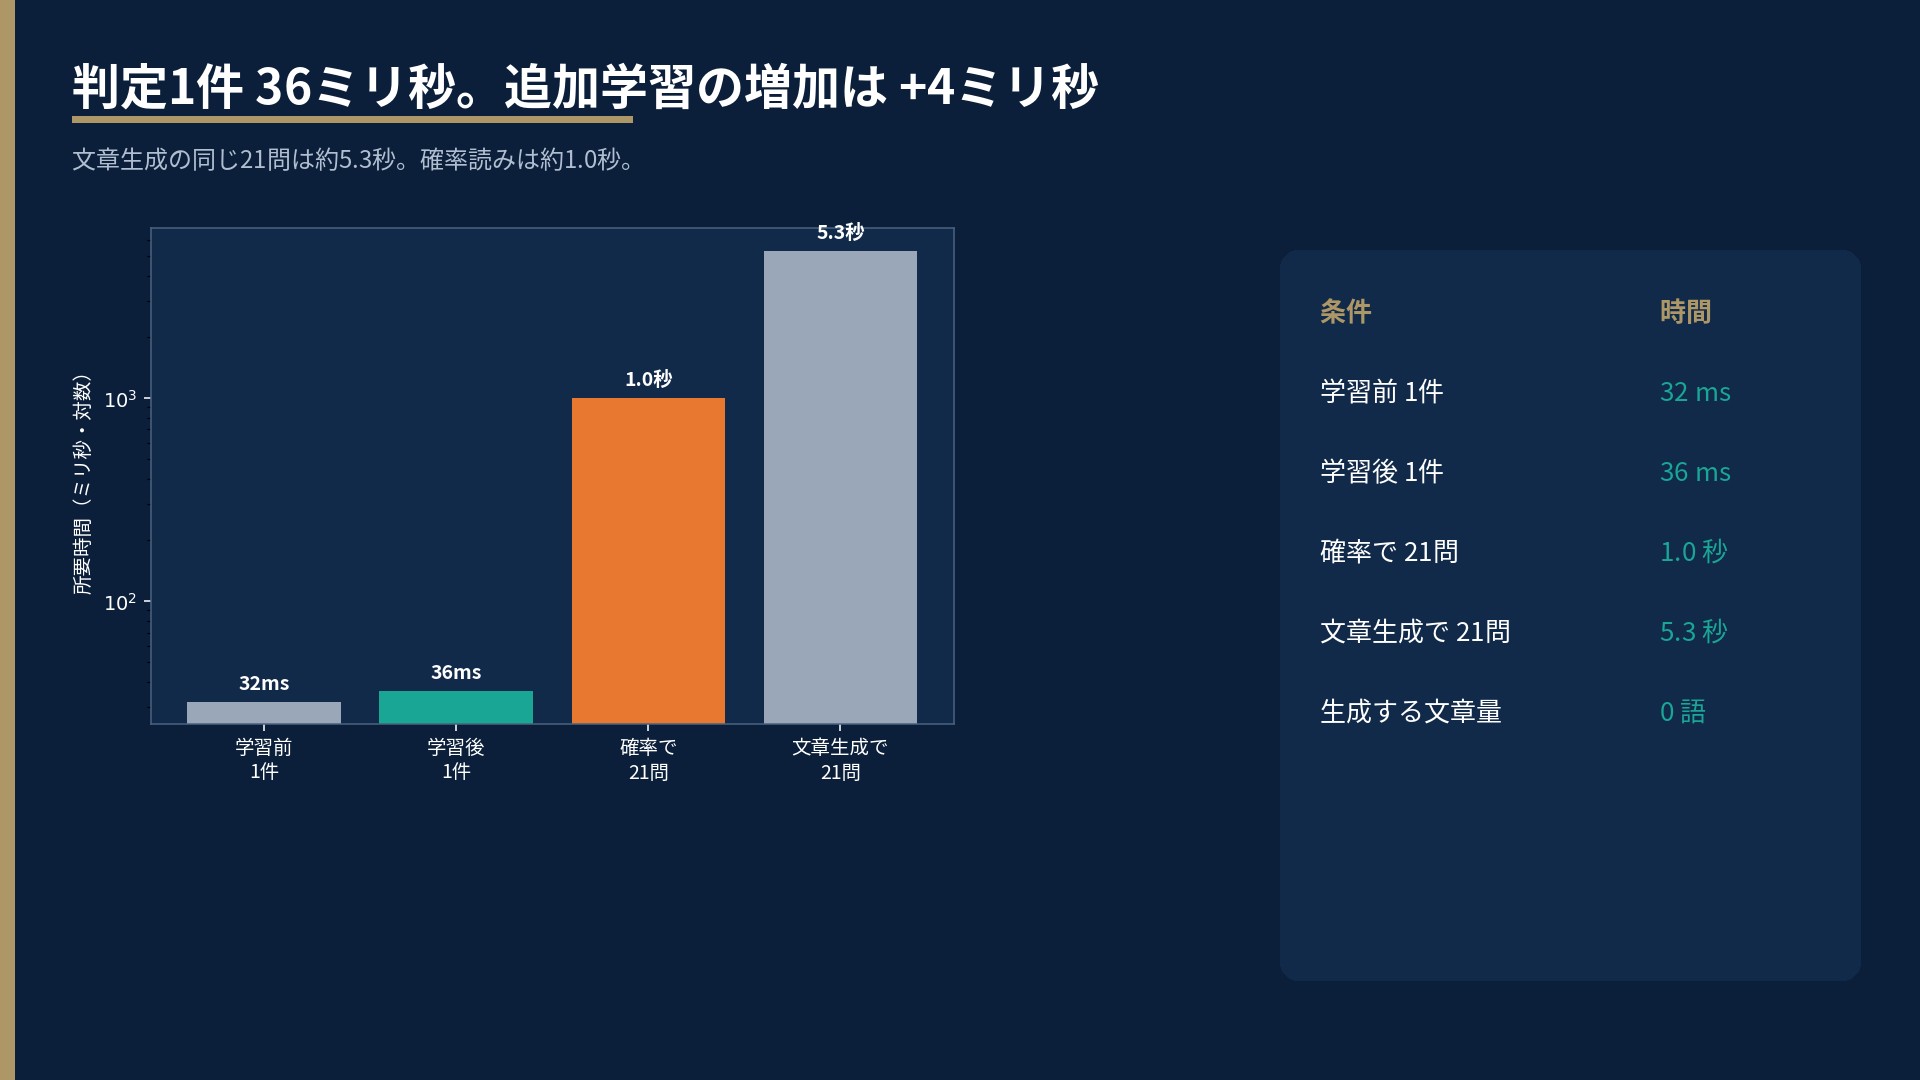
同じ 4B モデル・同じ状況・同じ 21問を、2通りで処理した公開デモの実測です。
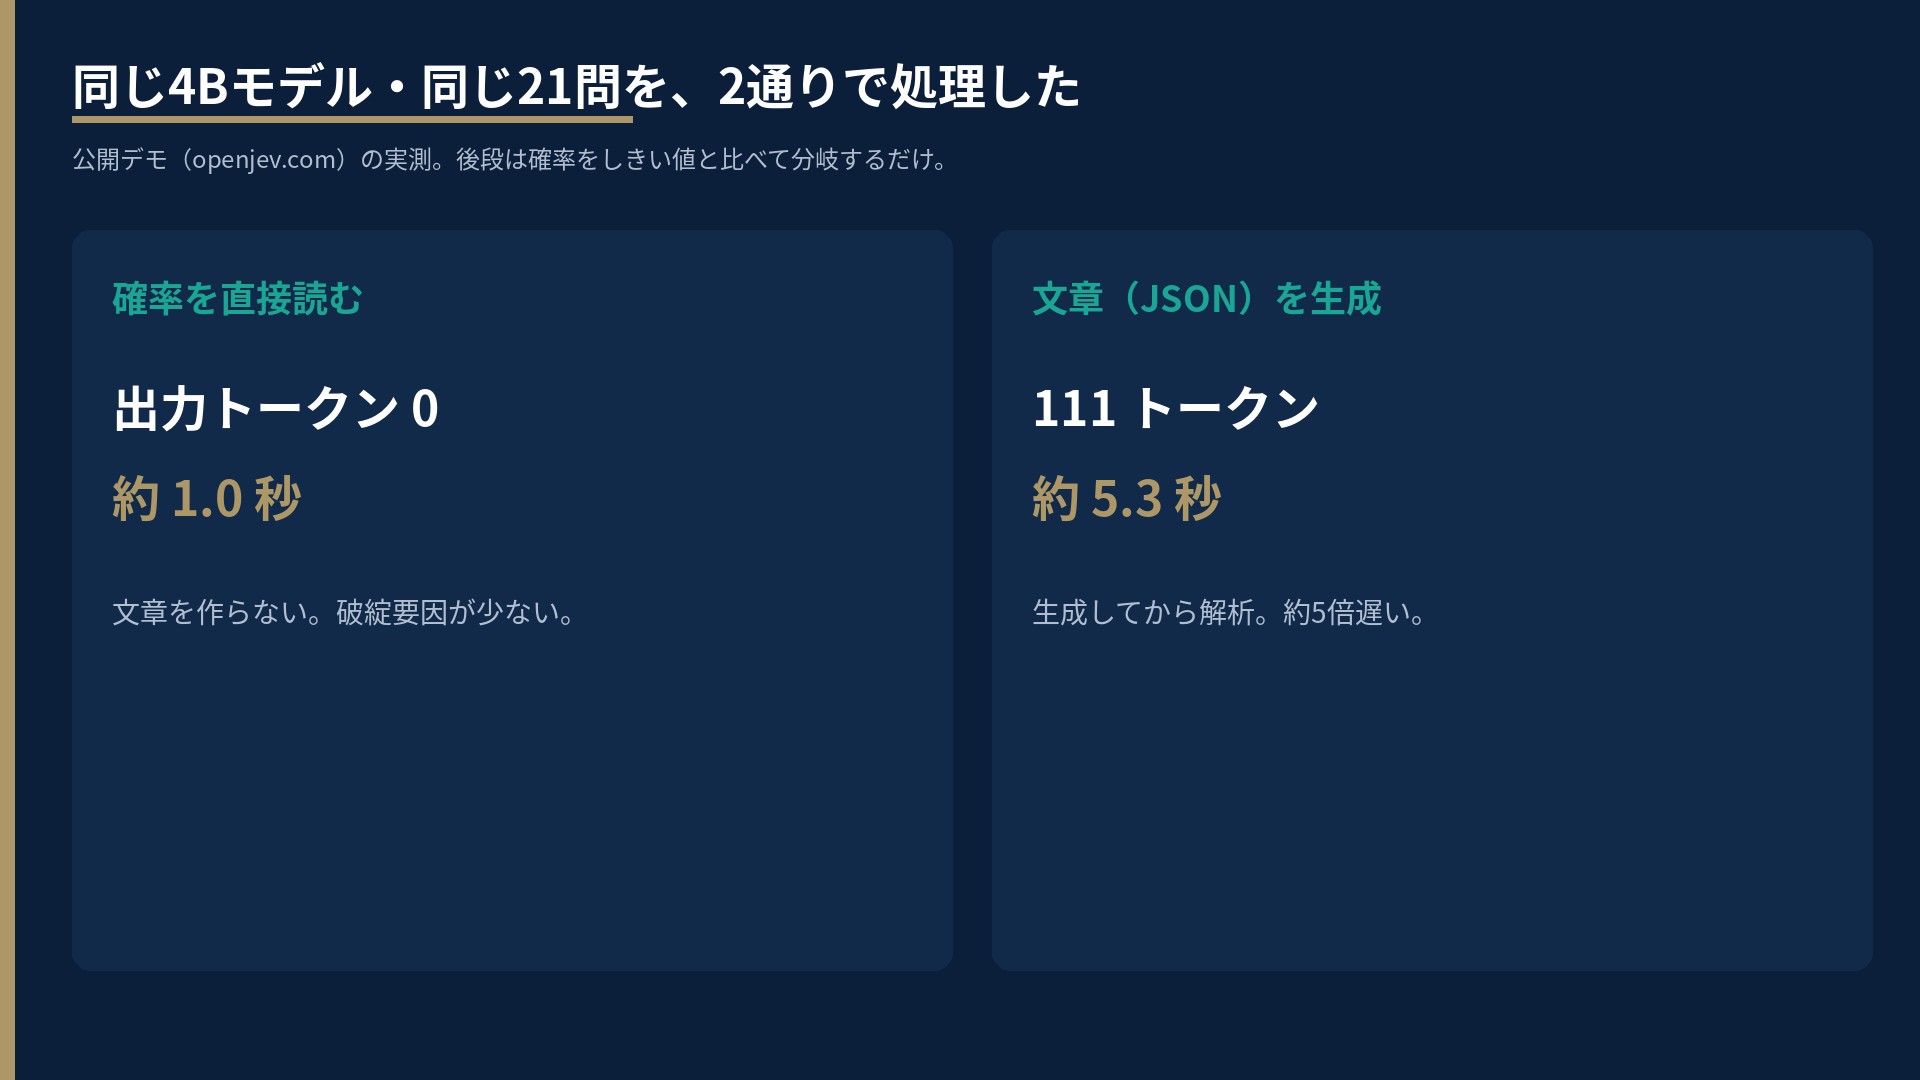
後段は確率をしきい値と比べて分岐するだけです。
仕組みは単純です。選択肢に対応するトークンのスコアだけを取り出し、正規化します。
何を学習させたか
学習対象は「話し方」ではありません。証拠を読んで選ぶ力です。Jev 本体には触れていません。
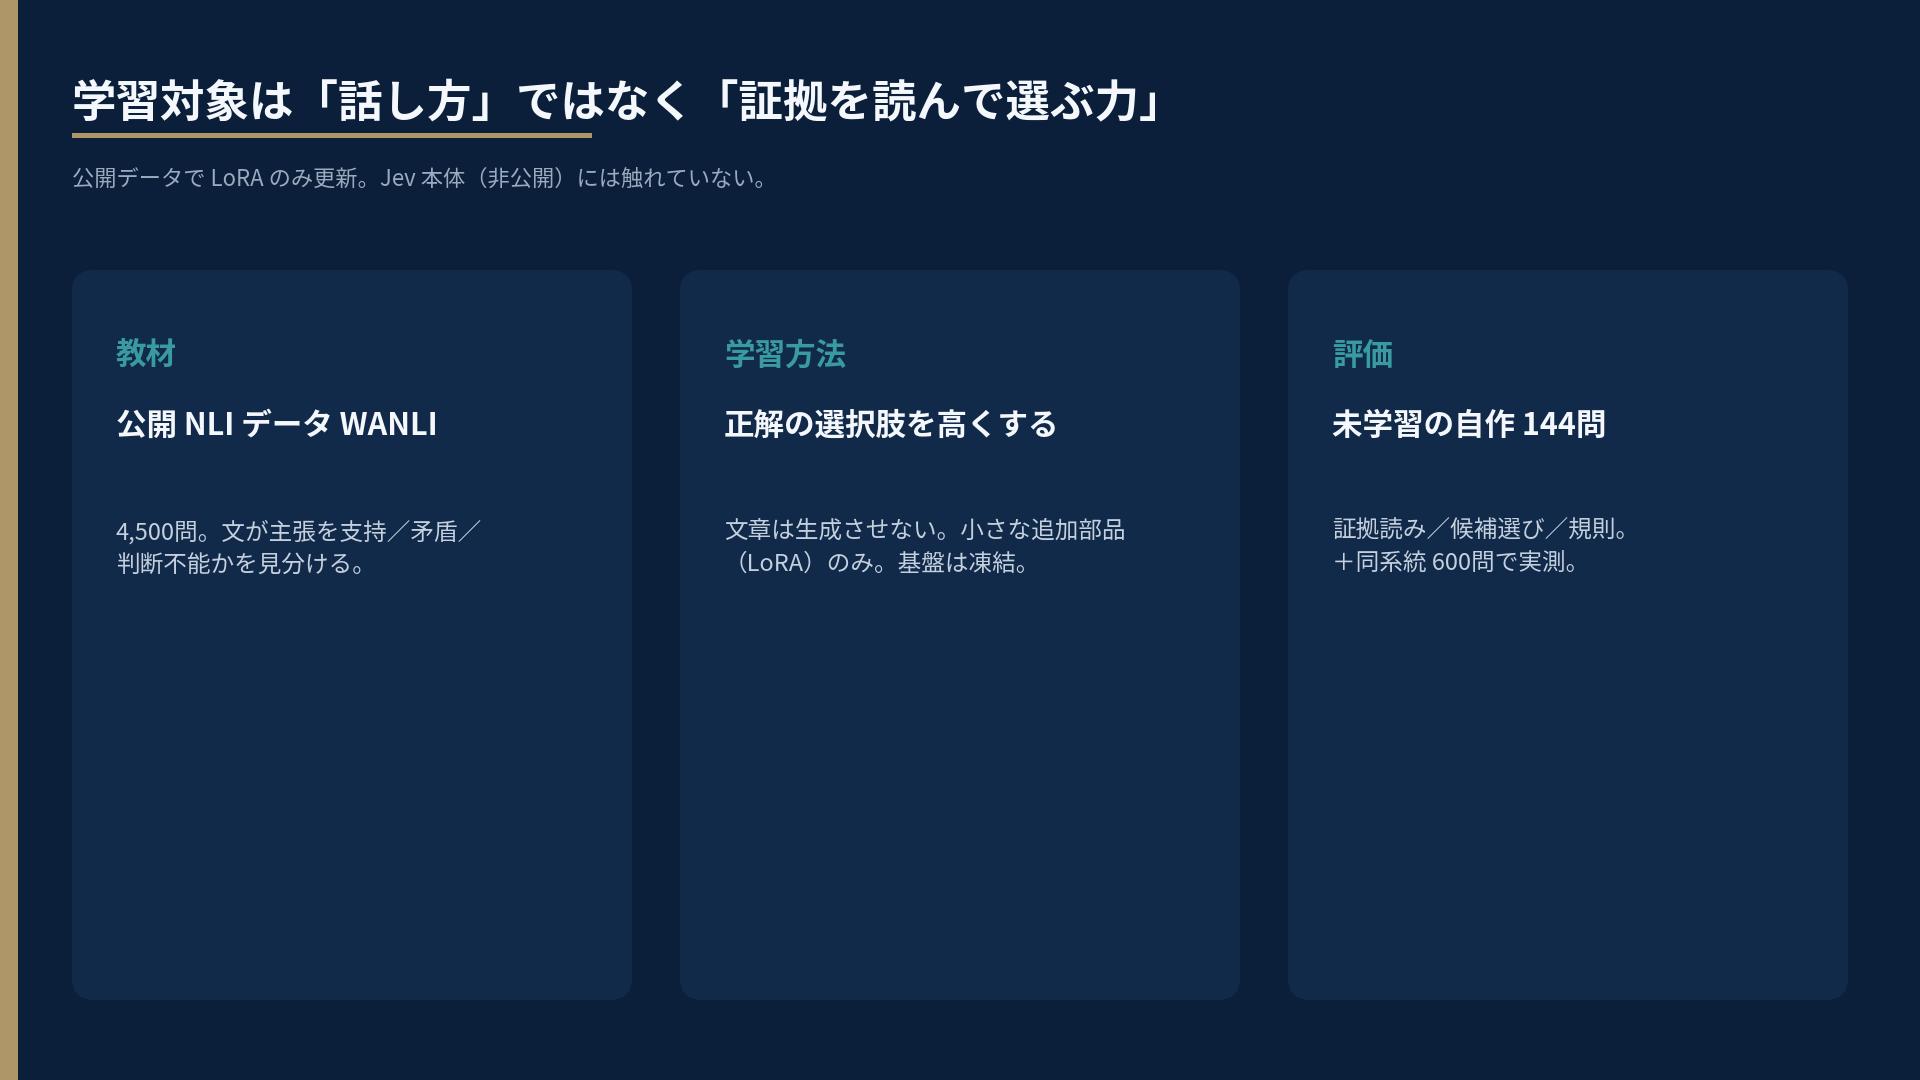
対象外は、雑談・長文の説明・「校正済みの自信」です。対象は、渡された状況だけを見て、用意された答えから選ぶことです。
効果① 正解率
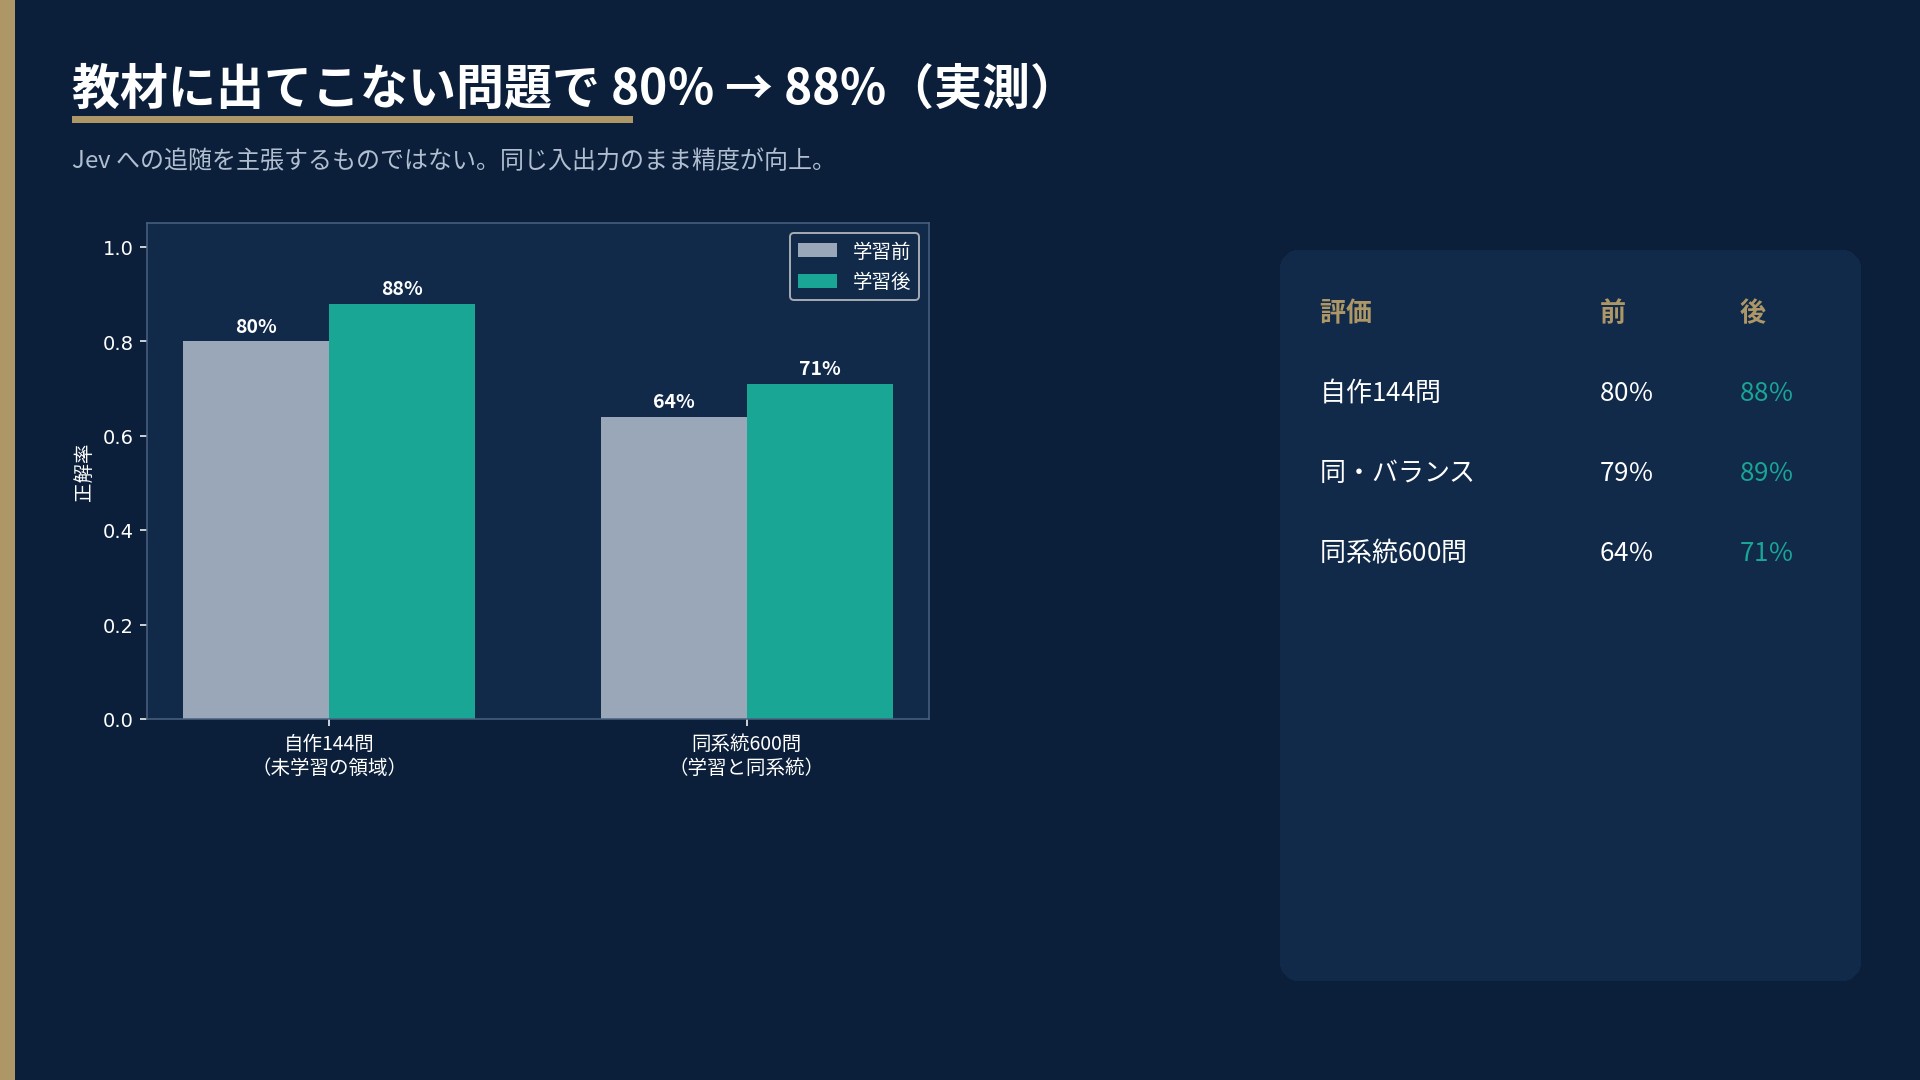
教材に出てこない問題で、80% → 88%(実測)です。Jev への追随を主張するものではありません。
効果② 分野別の伸びと、注意すべき低下
教材が「証拠の読み取り」に偏るため、規則適用は低下しました。
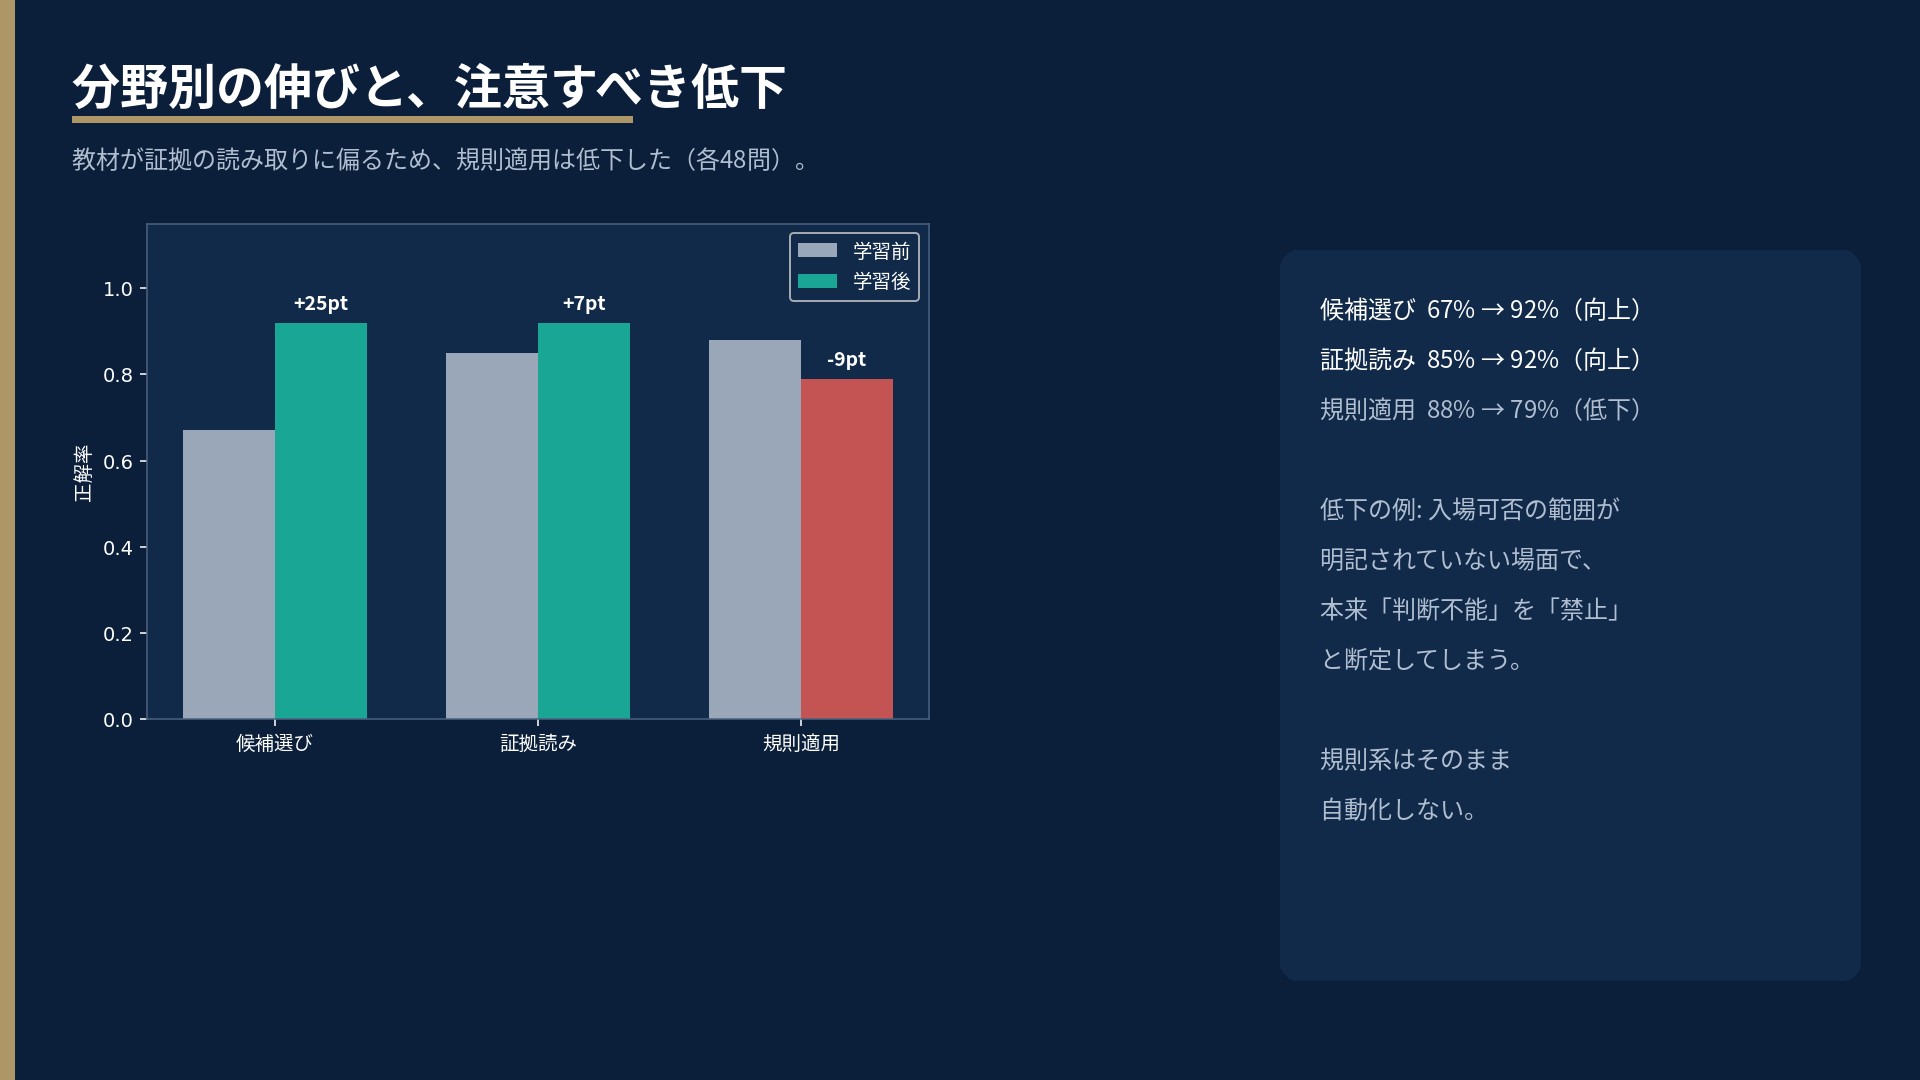
平均が良くても、分野が落ちることがあります。用途ごとに見て、弱いところはゲートで止めます。
効果③ 速度
判定1件は 36ミリ秒。追加学習による増加は +4ミリ秒 にとどまります。
人工意識(AC)への組み込み
「考える全文」ではなく、知覚と行動のあいだの高速な判定レイヤーとして置きます。
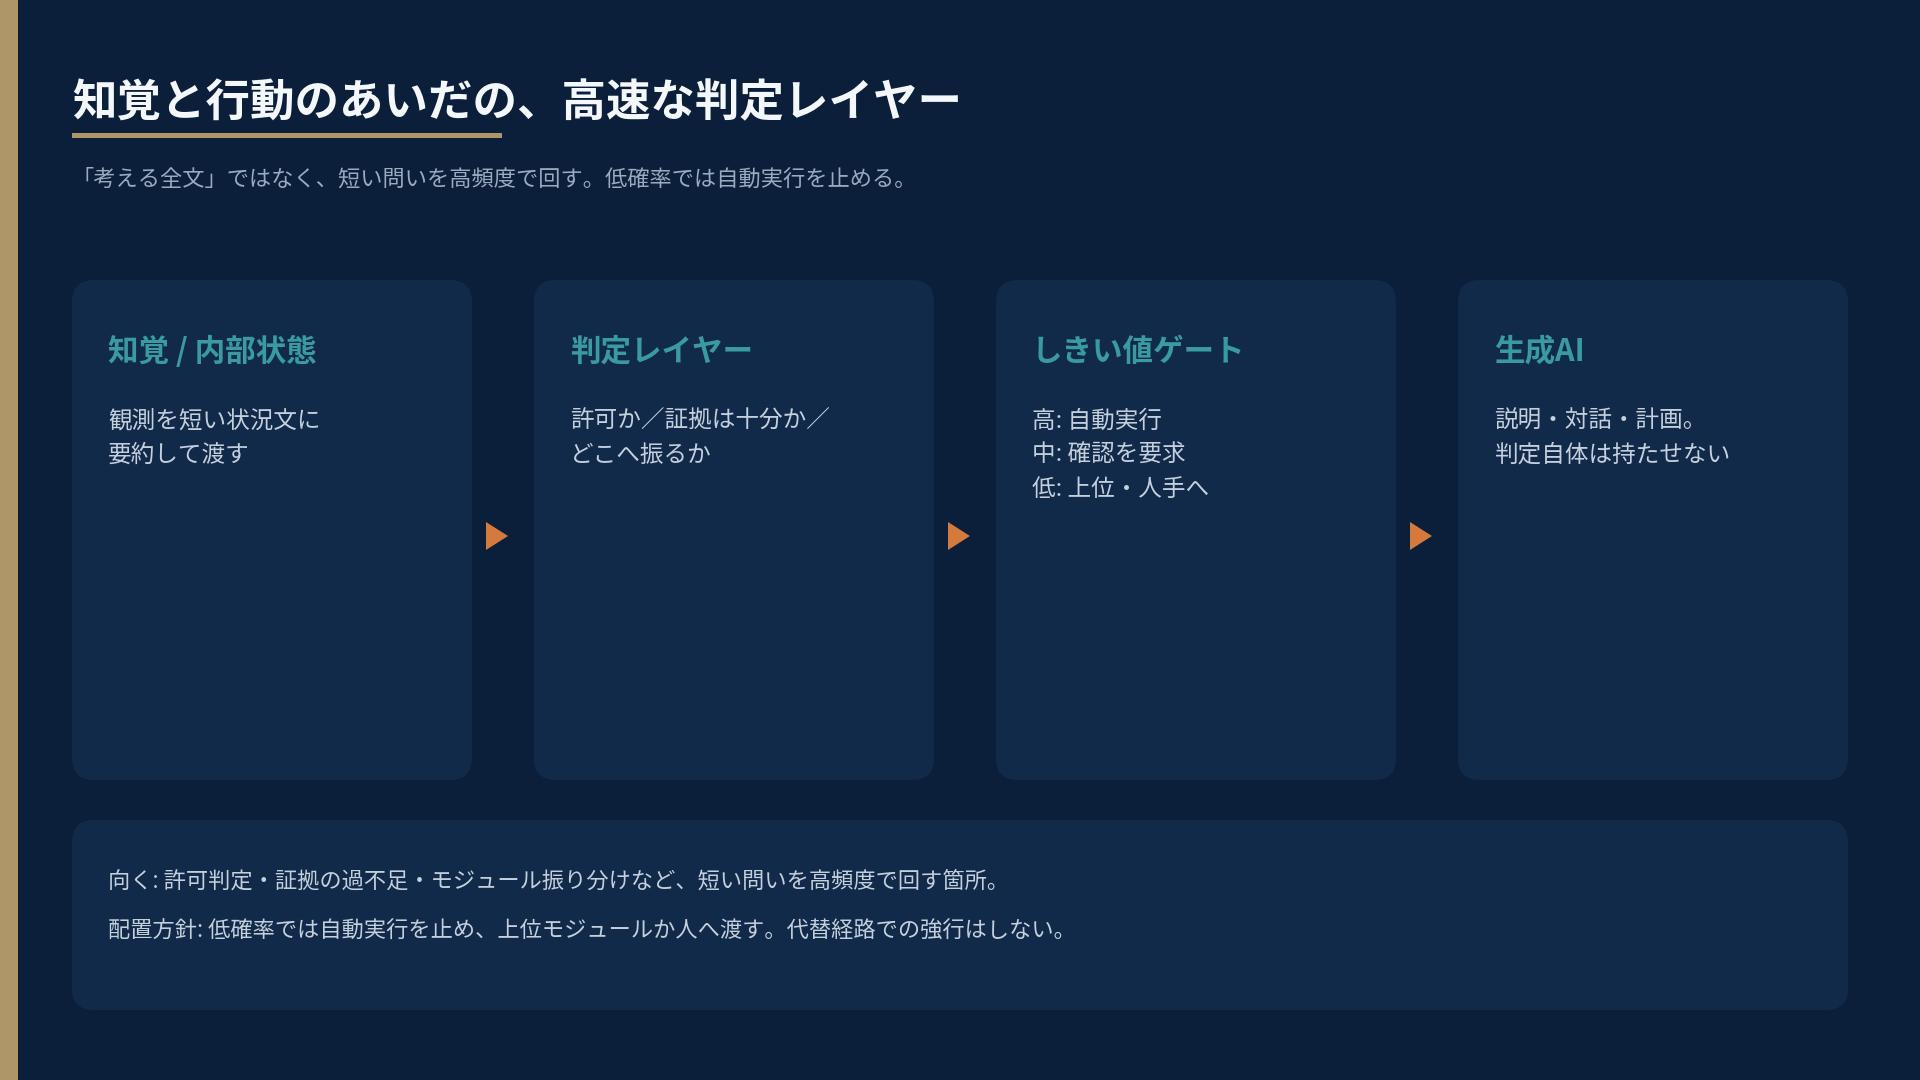
向くのは、短い問いを高頻度で回す箇所です。長い説明や雑談は、別の生成の仕事です。
導入時の留意点
確率が高いことと、運用してよいことは別です。
まとめ
- 文章を作らない判定 ― 状況・質問・選択肢を渡すと、各選択肢の確率だけが返る。出力トークンは 0。
- AC の隙間を埋める ― 許可・証拠・振り分けなど、知覚と行動のあいだの短い判定を、しきい値ゲートと組み合わせる。
- 公開モデルで伸ばせる ― Qwen3.5-4B + LoRA。未学習領域 80%→88%。基盤の載せ替えは不要。
- 規則系は落とさない ― 証拠読みと候補選びは伸び、規則適用は低下。分野ごとに見て、自動化しない判断が要る。
- 速い ― 判定1件 36ミリ秒。同じ21問で、文章生成の約5倍。
説明は生成AI、判定は確率エンジン。人工意識の小さな判定を、速く・安く・再現可能な形で回す。それが OpenJev の置き方です。デモやご相談を承っています。