Idol は、物体が写った画像を1枚入れると、写っていない側面や背面まで含めた3Dオブジェクトを生成する AI モデルです。Speridlabs が2026年10月30日に公開しました。重みとコードは Apache License 2.0 で公開されていて、出力は標準的な 3D Gaussian Splatting(3DGS)の .ply ファイルです。
当社の RTX 4090 で動かし、仕組み、生成例、速度とメモリ、導入のときにつまずいた点を確かめました。当社の環境は GPU をほかの処理と共有しているので、時間の数値は参考値として見てください。
何をするモデルか
入力は、物体が写った画像1枚です。写真、レンダリングした CG、画像生成 AI の出力のどれでも使えます。背景の除去、物体の切り抜き、3D の生成までを、まとめて自動で行います。入力に写っていない側面や背面は、学習した形状の知識から補って生成します。
出力は 3DGS の .ply ファイルで、ガウシアンの数は 32,768 から 1,048,576 まで選べます。一般的なビューアでそのまま開けます。重み(約3GB)は Hugging Face、推論のコードは GitHub で公開されています。
| 項目 | 内容 |
|---|---|
| 提供元 | Speridlabs(2026年10月30日公開) |
| 入力 | 物体が写った画像1枚 |
| 出力 | 3DGS の .ply(32,768〜1,048,576 個) |
| 生成モデル | DiT 370M + デコーダ 288M |
| 画像の条件付け | DINOv3 ViT-H+ + FLUX.2 VAE |
| 背景除去 | BiRefNet |
| ピーク VRAM | 7.2GB(公称) |
| ライセンス | Apache License 2.0 |
3D Gaussian Splatting は、半透明の楕円体の集まり
3DGS は、半透明の楕円体(ガウシアン)を大量に並べて、立体の形と見た目を表す方式です。1つのガウシアンは、位置(3次元)、各軸方向の大きさ(3次元)、向き(クォータニオンで4次元)、不透明度(1次元)、色(RGB の3次元)を持ちます。視点に合わせて高速に描画でき、細かな質感や毛並みの表現に向いています。メッシュ(ポリゴン)ではないので、編集や物理演算に使うには、変換や専用のツールが必要です。

Idol が出力するのは、このガウシアンの集合です。アンカー点を置き、1つのアンカーから32個のガウシアンを広げる構造になっています。262,144 個なら、8,192 アンカー × 32 です。物体は、1×1×1 の立方体の範囲に正規化して出力されます。
処理は4段階。時間の97%は3D潜在の生成
処理の流れは、前処理、画像のエンコード、3D 潜在表現の生成、デコードの4段階です。
前処理では、BiRefNet で背景を取り除き、物体を切り抜いて 1024×1024 に整えます。次に、DINOv3 と FLUX.2 VAE で、画像の意味の特徴と潜在表現を取り出し、生成の条件にします。3つ目の段階では、DiT(Flow ベース)が、ノイズから少しずつ3Dの潜在表現を作ります。既定は Euler 法の50ステップで、Classifier-free guidance の強さは3.0です。最後に、Octree と Gaussian のデコーダでアンカーを配置し、各アンカーを32個のガウシアンに広げて .ply にします。
裏側は、入力の画像から計算できません。学習した形状の知識に基づいて、補って生成しています。入力したときのカメラの角度(yaw、pitch、距離、画角)も同時に推定し、生成物と一緒に保存します。
処理時間の約97%は、3つ目の DiT のサンプリングです。前処理、エンコード、デコードは、合わせて1秒未満でした。
| 構成要素 | パラメータ数 | GPU での精度 | 重みの VRAM |
|---|---|---|---|
| DiT(デノイザ) | 370.6M | FP16(一部 FP32) | 約 0.8〜1.0 GB |
| Octree デコーダ | 50.8M | FP16(一部 FP32) | 約 0.1〜0.2 GB |
| Gaussian デコーダ | 237.3M | FP16(一部 FP32) | 約 0.5〜0.9 GB |
| BiRefNet(背景除去) | 220.7M | FP16 | 約 0.44 GB |
| DINOv3 ViT-H+/16 | 840.6M | bf16 | 約 1.68 GB |
| FLUX.2 VAE | 84.1M | bf16 | 約 0.17 GB |
| 合計 | 約 1.80B | 約 3.7〜4.4 GB |
全体では約18億パラメータですが、生成そのものに使うのは DiT と2つのデコーダの約6.6億です。数値は Speridlabs のモデルカードによるもので、DINOv3 と FLUX.2 VAE は外部で公開されているモデルを使っています。ピーク VRAM は公称で 7.2GB、当社の環境で測ったピークの割り当ては 5.0GiB でした。10GB クラスの GPU(RTX 3080 など)でも動きます。
生成の調整は、コマンドの引数で行う
3D 潜在表現は、ノイズから出発し、入力画像を条件にして、少しずつ変換していきます。ステップを減らすと速くなります。Classifier-free guidance は、「画像あり」と「画像なし」の予測を混ぜて、入力への忠実さを調整します。time shift を大きくすると、全体の形を決める序盤に多くのステップを割り振ります。seed を固定すれば同じ物体を再現でき、seed を変えれば別の解釈が得られます。
生成したあとは、潜在表現から好きな数のガウシアンを取り出せます。数を変えても、サンプリングをやり直す必要はありません。
| 引数 | 既定値 | 役割 |
|---|---|---|
| --steps | 50 | サンプリングの回数(速度と細かさ) |
| --cfg_strength | 3.0 | 入力画像への忠実さ |
| --rescale_t | 3.0 | 全体の形と細部への配分 |
| --num_gaussians | 262,144 | 出力するガウシアンの数(32の倍数) |
| --seed | 42 | 乱数のシード |
| --mode | synthetic | 入力の種類(real / synthetic) |
| --dinov3_dtype | bf16 | fp32 にすると精度を優先(+1.7GB) |
既定では torch.compile などの高速化が有効で、初回だけコンパイルが走ります。
入力は自動で切り抜かれる。モードは2つ
入力の画像は、背景を自動で取り除き、物体を中央に切り抜いてから使われます。
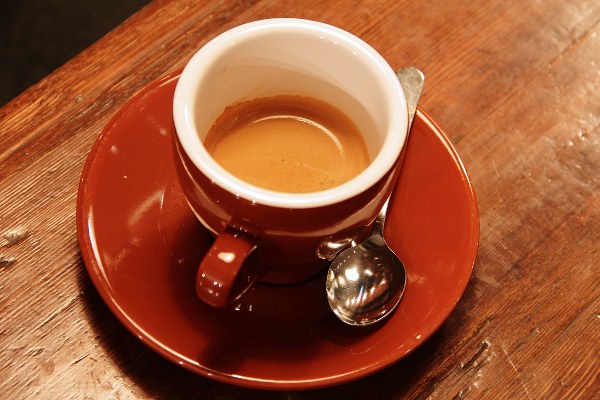
モードは2つです。CG、レンダリング、画像生成 AI の出力には synthetic(既定)を使い、物体の範囲の1.2倍で切り抜きます。実物の写真には real を使い、1.7倍で切り抜きます。余白は --crop_margin で個別に指定できます。
1枚の画像には1つの物体を写します。複数の物体は想定されていません。立体感のある向きや照明の画像の方が有利です。切り抜いたあとの画像は、モデルが実際に見ている入力で、生成結果と一緒に _input.png として出力されます。背景の除去に失敗すると、生成の品質に直結します。結果が不自然なときは、まずこの画像を確認するのが早道です。
生成例:画像生成 AI で作ったロボット
画像生成 AI で作ったロボットの画像から、3Dを生成しました。
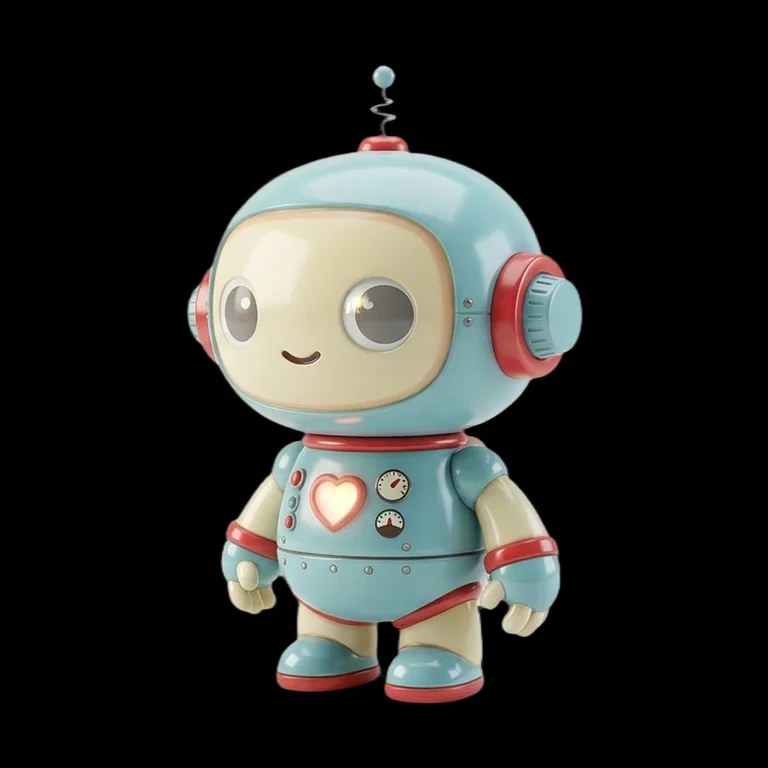
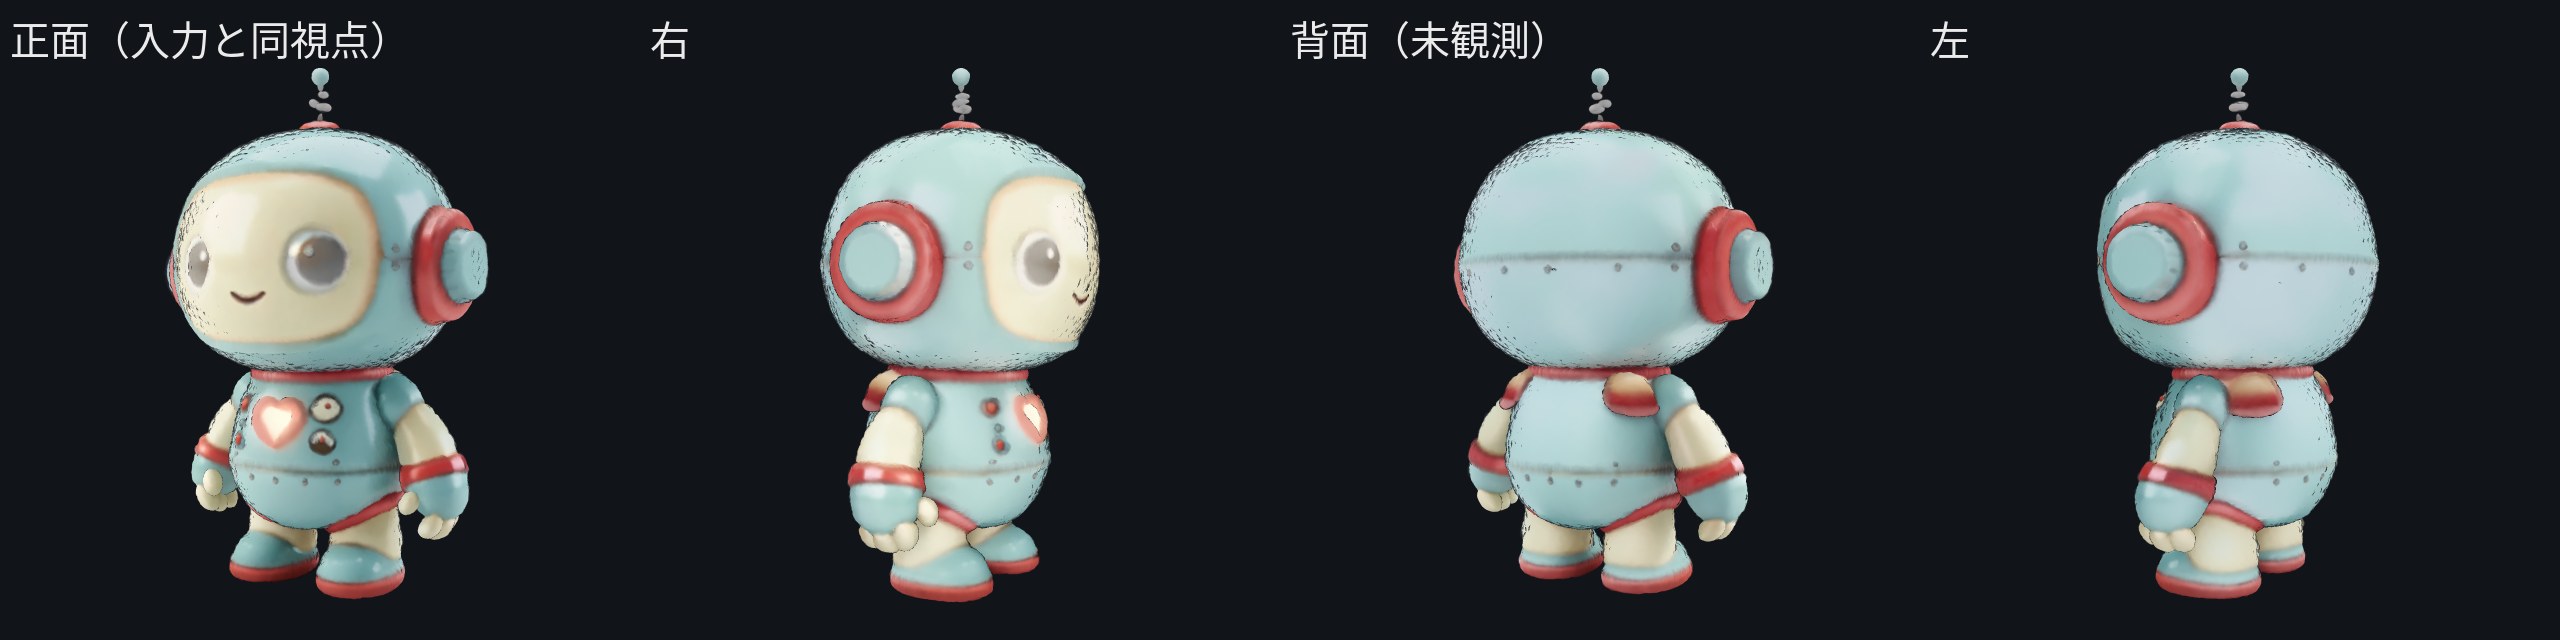
生成時間は 24.7 秒、ピークの VRAM は 5.0GiB、ガウシアンは 262,144 個で、.ply は 17.0MB でした。ヘッドホンの形、胸のハート、ネジや縫い目のような細部まで出ています。入力に写っていない背中側の質感も、自然に補われていました。
生成例:キツネ、カップケーキ、ナイト、パンダ
ほかに4つ、画像生成 AI の画像から生成しました。左が入力、右が生成した3Dの回転表示です。
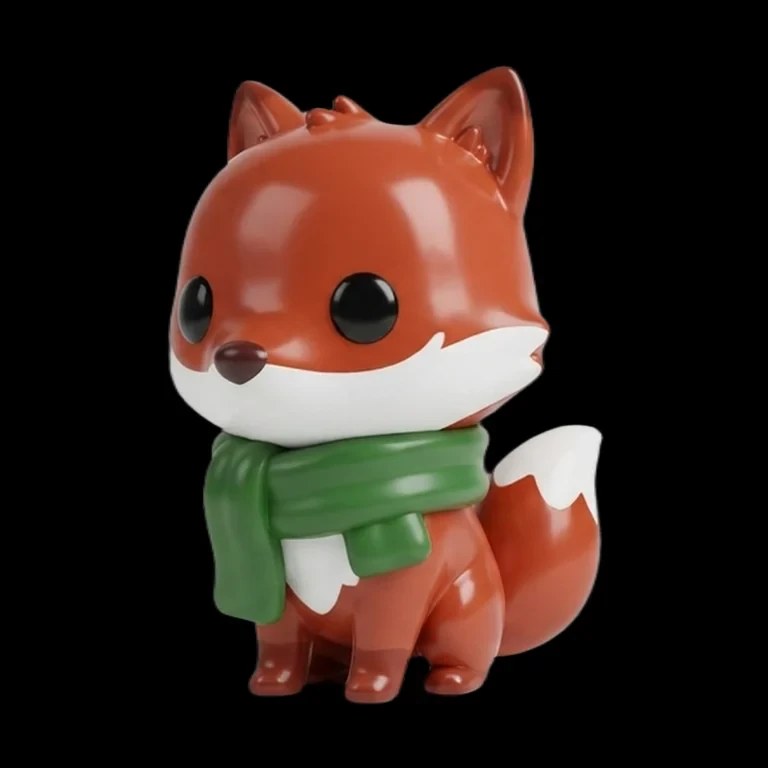
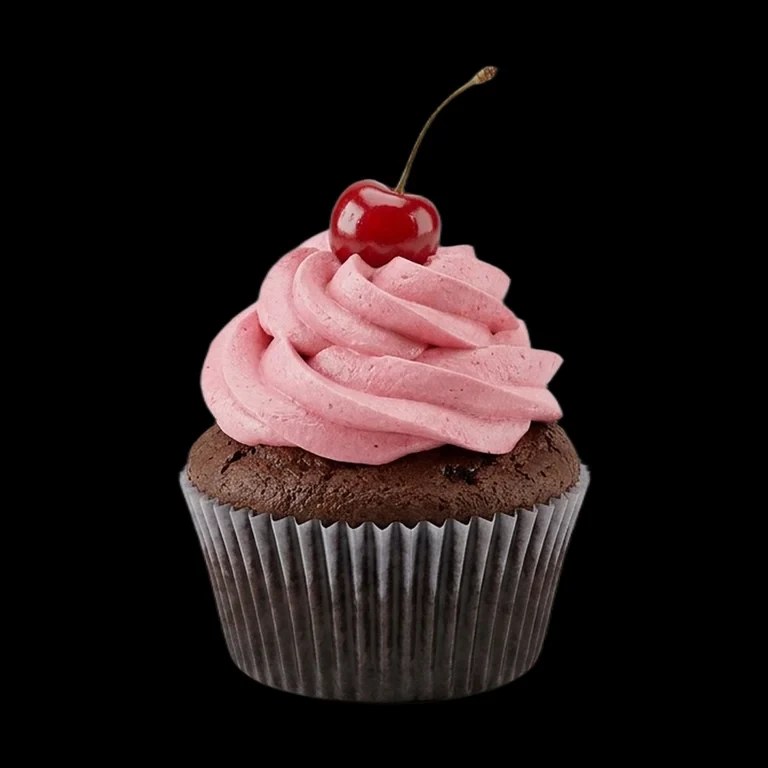
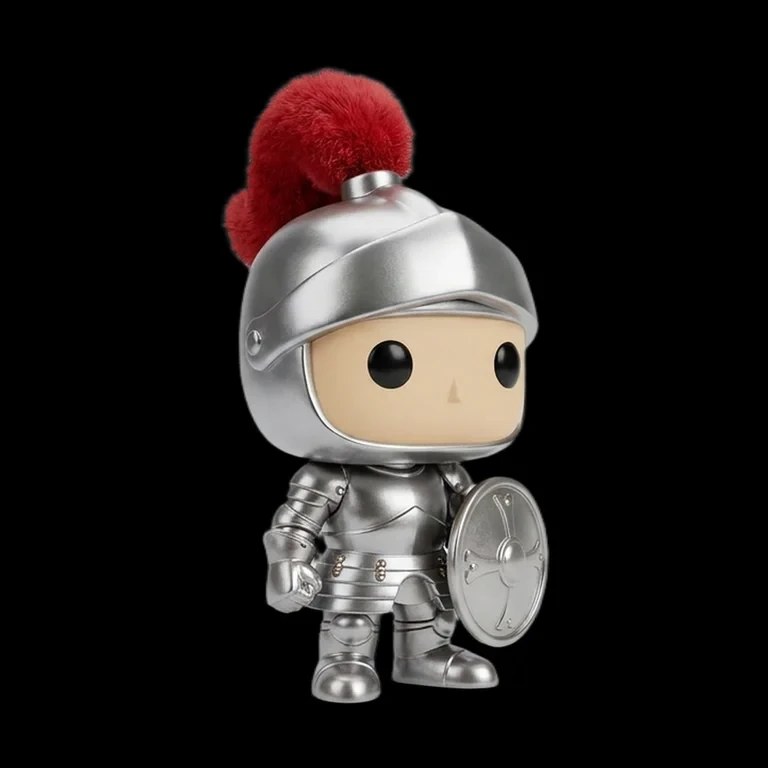
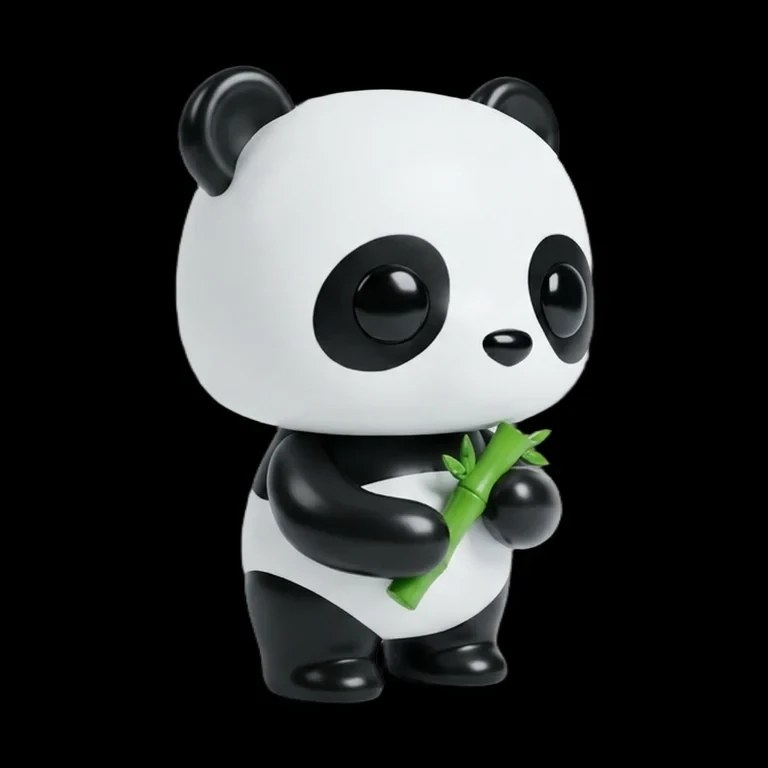
キツネとカップケーキとパンダが 24.5 秒、ナイトが 24.7 秒で、.ply はどれも 17MB でした。どの例も、背面を含む全周の形が生成されています。
生成例:実写のコーヒーカップ
最後は実写の写真で、モードは real にしました。
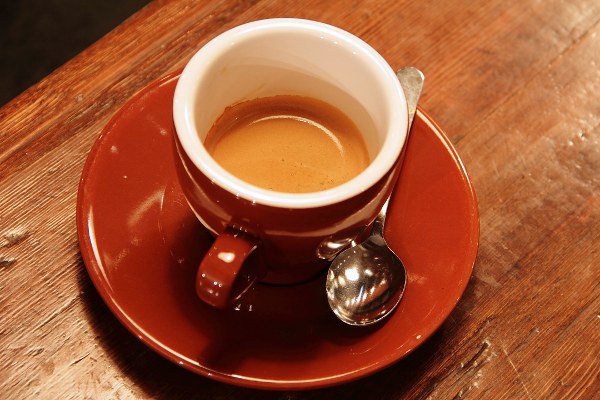
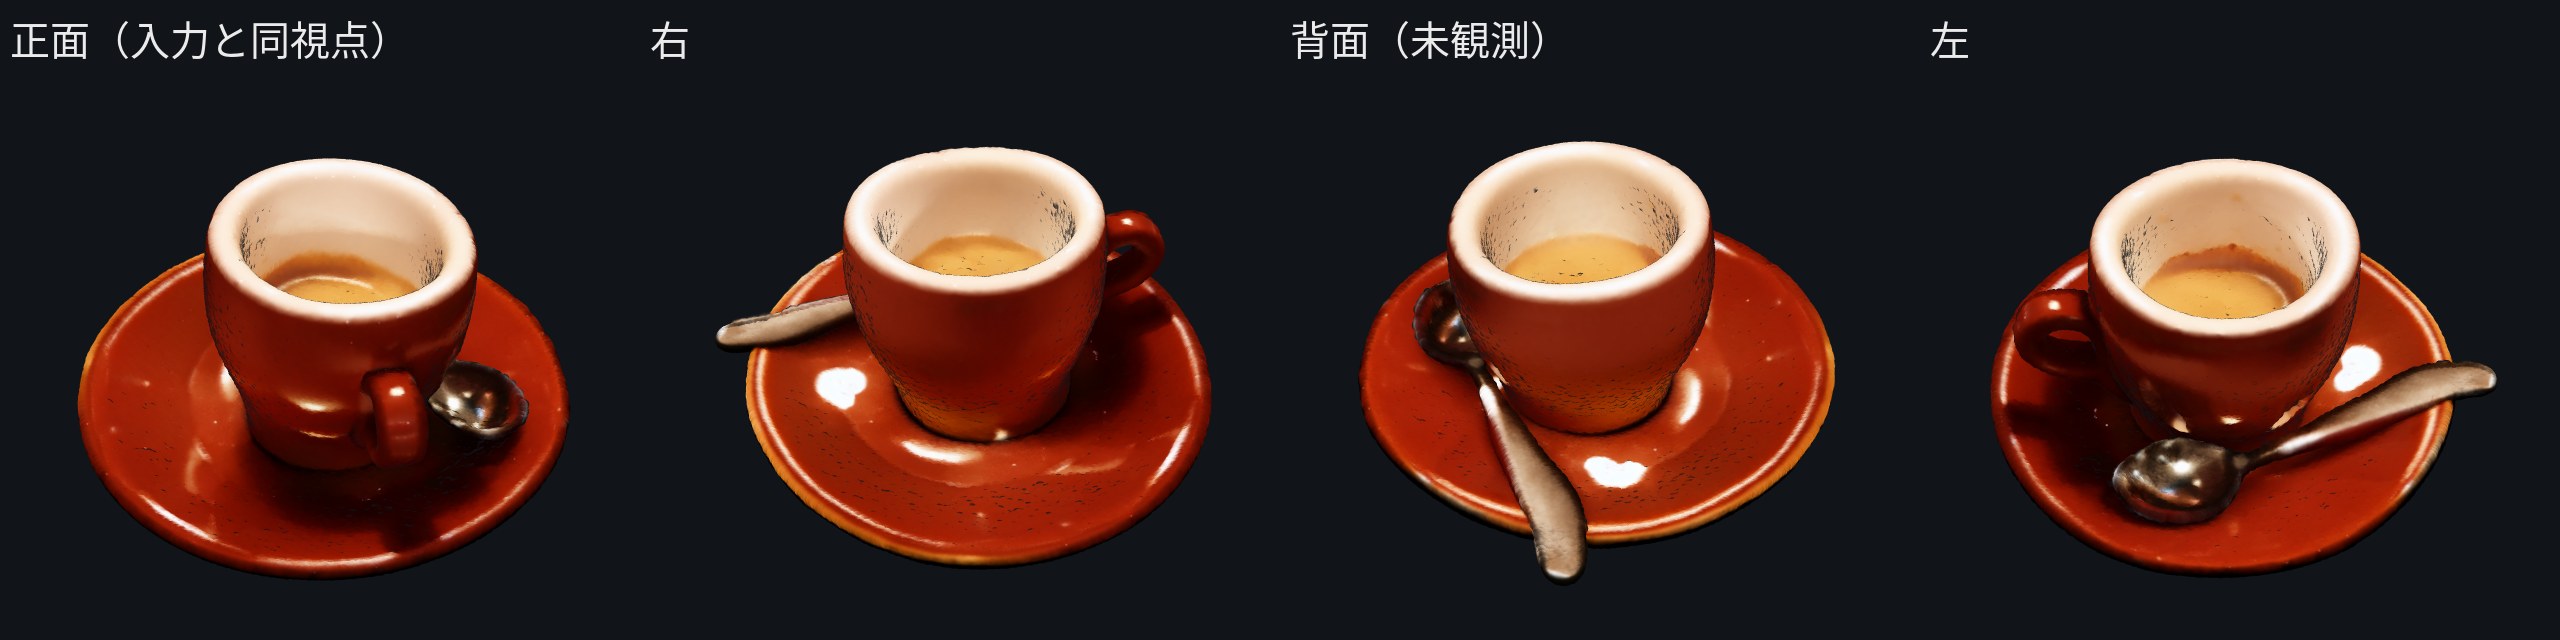
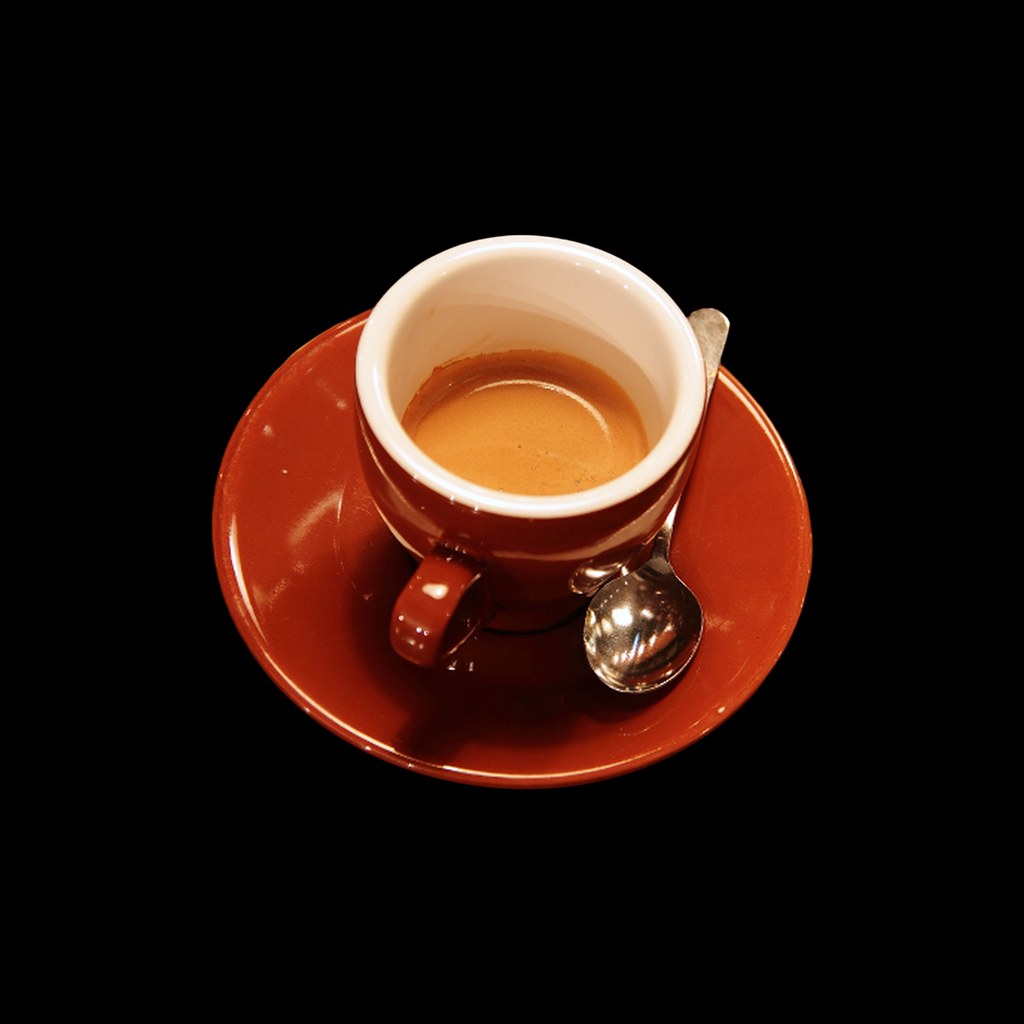
カップ、ソーサー、スプーンの形と色がよく出ていて、コーヒーの液面も再現されています。上から撮った写真ですが、全周の形に大きな崩れは見られませんでした。生成時間は 24.7 秒で、合成画像のときと変わりません。
ただし、写っていない側(スプーンの向きなど)は推測で補ったもので、実物と一致する保証はありません。所見は1枚で確かめたものです。報道でも、「立体感のない画像からは崩れる」「写っていない部分は手直しが必要」という指摘があります。
ガウシアンの数で、品質と容量を選ぶ


32,768 個(2.1MB)は、配信やプレビュー向けで、表面は粗くなります。262,144 個(17MB)が標準で、多くの用途で釣り合いがとれています。1,048,576 個(68MB)は高精細で、表面がなめらかです。ファイルサイズは数に比例して変わります。一方、ガウシアンを生成する段階の時間は、32,768 個の 0.09 秒から 1,048,576 個の 1.19 秒までで、全体の約25秒から見ればわずかです。品質を優先するなら、大きめの数を指定した方が得です。
生成時間とメモリ
標準の設定(262,144 ガウシアン、50ステップ)での、1枚あたりの生成時間です。
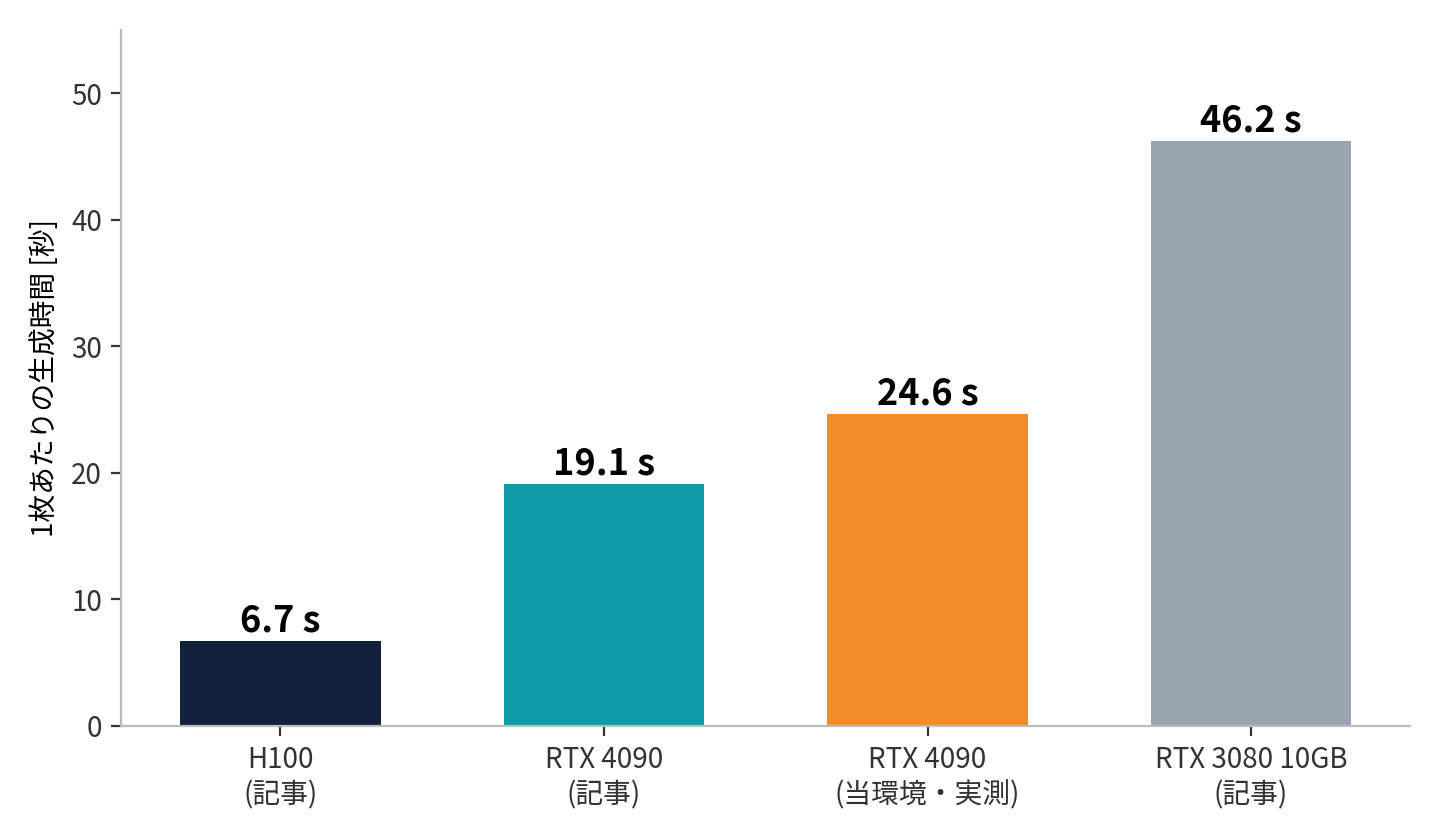
報道では、H100 で 6.7 秒、RTX 4090 で 19.1 秒、メモリ10GBの RTX 3080 でも 46.2 秒です。当社の RTX 4090 の実測は約25秒で、ほかの処理と GPU を共有しているぶん、報道より遅く出ています。
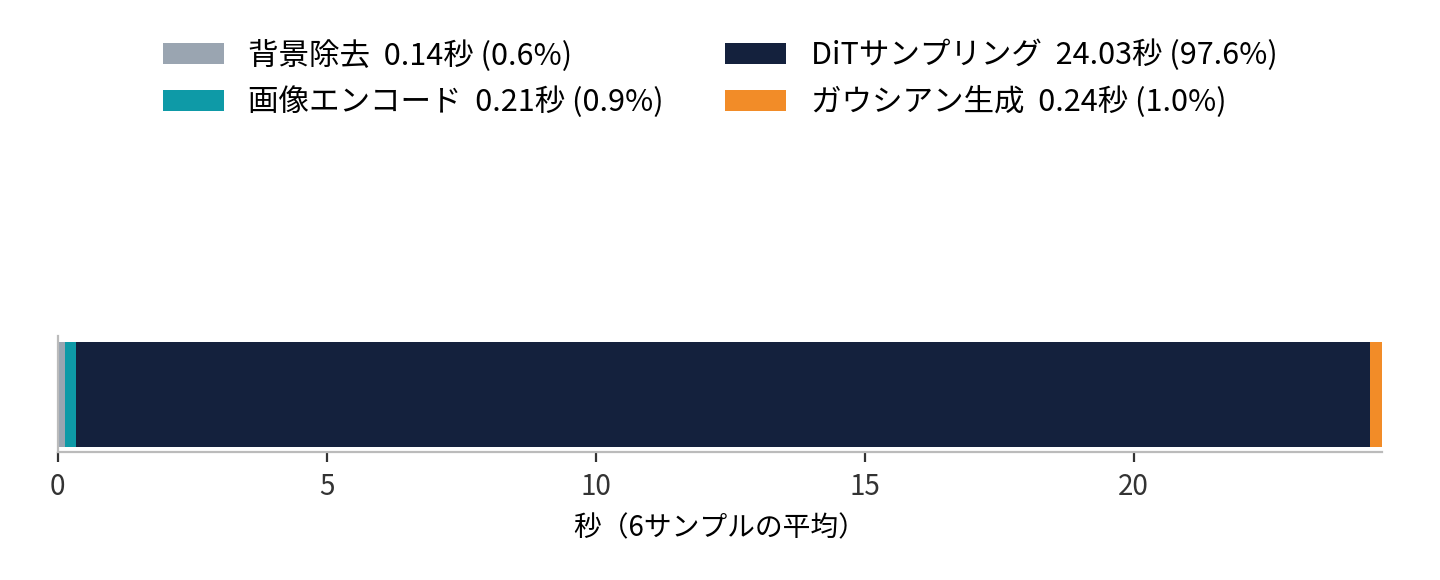
段階ごとに見ると、背景除去が 0.14 秒、画像のエンコードが 0.21 秒、DiT のサンプリングが 24.03 秒(97.6%)、ガウシアンの生成が 0.24 秒でした。サンプリングはステップ数で調整できます。標準の設定なら、1台の GPU で1時間に約146枚を作れる計算です(当社の環境の値)。
ステップ数を減らすと速くなる
同じ画像、同じ seed で、ステップ数だけを変えました(262,144 ガウシアン)。

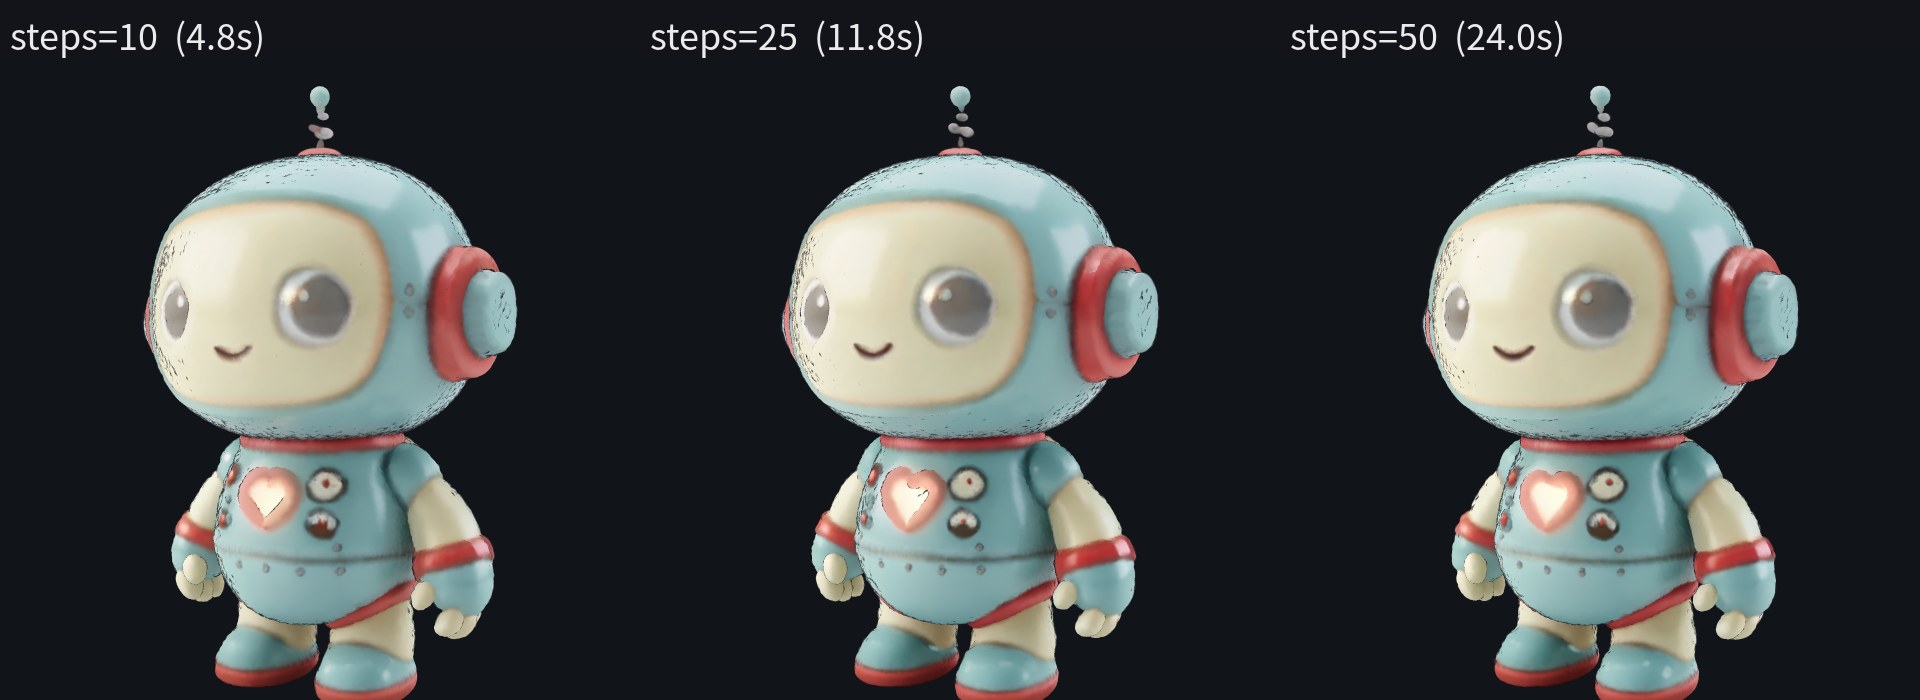
10 ステップで 5.4 秒、25 ステップで 12.4 秒、50 ステップで 24.6 秒でした。1ステップあたり約0.48秒です。10 ステップは標準のおよそ5分の1の時間で、全体の形は保たれますが、目やハートなどの輪郭がぼやけます。
形の確認や大量のふるい分けには、10〜25 ステップ(約5〜12秒)が向いています。最終の成果物には、既定の 50 ステップ(約25秒)を使います。まず少ないステップでたくさん作り、良いものだけを 50 ステップで作り直すのが効率的です。
導入の手順と、つまずいた点
導入は、Hugging Face での利用承認、SDK のインストール、生成の順です。Python 3.10 以上と PyTorch 2.5 以上が必要です。
# 1) Hugging Face で次の2つの利用承認を取得し、ログイン
#    facebook/dinov3-vith16plus-pretrain-lvd1689m
#    black-forest-labs/FLUX.2-dev
hf auth login

# 2) SDK の取得とインストール
git clone https://github.com/speridlabs/idol-sdk.git
cd idol-sdk && pip install -e .

# 3) 生成(初回のみ、約3GBの重みを自動でダウンロード)
python -m idol.sample --image photo.jpg --mode real
from idol import IdolPipeline

pipe = IdolPipeline.from_pretrained("speridlabs/idol")
out = pipe("photo.jpg", mode="real", seed=42, num_gaussians=1_048_576)
out.gaussian.save_ply("photo.ply")
当社の環境では、次の点でつまずきました。
利用承認が必要なモデルは、承認されるまで時間がかかります。承認の前に動かすと、実行したところで 403 エラーで止まります。PyTorch は、GPU ドライバに合った CUDA 版を選びます。ドライバが CUDA 12.8 までなら cu128 版です。新しすぎる版を入れると CUDA が使えず、CPU で動いてしまいます。初回は、重みのダウンロードとコンパイルで時間がかかります。flash-attn は入れなくても動きます。その場合は PyTorch 標準の注意機構を使い、結果は同じで、少し遅くなります。
ライセンスと利用条件
Idol の重みと SDK は Apache License 2.0 で、商用利用ができると公式に記載されています。背景除去の BiRefNet は、Idol の重みに同梱されています。
一方、画像のエンコーダに使う2つの外部モデル、DINOv3 ViT-H+ と FLUX.2 VAE は、それぞれ利用規約への同意が必要なゲート付きのモデルです。FLUX.2 VAE は black-forest-labs/FLUX.2-dev から VAE の部分だけを使っていて、商用で使えるかどうかは、そのライセンスを確かめる必要があります。入力する画像と生成物の権利は、使う側で確認します。第三者の著作物、肖像、商標を含む画像の扱いには注意してください。
商用で導入する前に、外部の2つのモデルの規約(商用利用、再配布、生成物の扱い)を、法務の担当と確認してください。この記事は法的な助言ではありません。
向いていること、気をつけること
向いているのは、立体感のある単体の物体です。フィギュア、食品、小物、キャラクターなどで、画像生成 AI やレンダリングの画像からの3D化(synthetic モード)に強みがあります。背面を含む全周の、それらしい形と色を補えます。1枚あたり約5〜25秒(ステップ数による)で量産でき、標準の .ply で出力するので、既存のビューアや処理の流れにつなげられます。
気をつけることもあります。写っていない部分は推測で、実物と一致する保証はありません。実写でも同じで、確認と手直しを前提にします。報道によれば、立体感のない画像(平面的、コントラストが低い)では崩れやすくなります。1枚の画像には1つの物体で、複数の物体やシーン全体は対象外です。出力は見た目のためのガウシアンなので、ポリゴン化、リグ、物理は別の工程になります。
使い道としては、EC やカタログで商品画像から回転表示できる3Dを短時間で作る、ゲームやメタバースの小物やキャラクターの素材案をたくさん作って選ぶ、AR・VR や展示の素材を写真1枚から用意する、企画や試作で AI が生成した画像を3Dにしてデザインの検討を早める、といった場面が考えられます。
試すなら、まず自社の代表的な画像10〜20枚で生成し、成功率と傾向を見ます。次に、用途ごとにガウシアン数、ステップ数、合格の基準を決めます。そのうえで、ノイズの除去やビューアへの組み込み、必要ならメッシュ化といった後処理を整え、バッチ処理と GPU の割り当てを決めて量産に移ります。当社の環境の値では、1台の GPU で1時間に約146枚です。