現場の作業、監視カメラ、社内の講義。動画は残っているのに、知識としては使えていません。 何十時間もの記録を人が見返すのは現実的ではなく、ファイル名と日付だけでは「あの作業のコツ」「あの時の状況」に辿り着けない。かといって、現場の映像をクラウドの動画AIへ送るわけにもいきません。
Video RAG は、その前提で作ったローカルの動画ナレッジ基盤です。動画を登録すると、映像理解と音声認識が「何が映り、何が話され、どんな手順か」を時刻付きの文章にし、キーワード・意味・画像の3方式で該当の場面まで探せます。処理は社内の GPU サーバ 1台です。動画も要約も索引も外に出しません。AIエージェント Luqua は要約を読み、必要な再生位置だけを人に渡せます。
紹介映像
見返せない、探せない、クラウドに出せない
モデルの精度以前に、見返しと検索と持ち出し先が揃っていない、という話です。
- 見返せない ― 何十時間もの記録を、人が全部見直すのは現実的ではない。撮った本人しか、どこに何があるか分からない。
- 探せない ― ファイル名と日付だけでは、「あの作業のコツ」に辿り着けない。
- クラウドに出せない ― 現場・監視・社内講義の映像は外に出せない。長さと本数に比例する従量課金も壁になる。
Video RAG では、登録した動画を社内のサーバで文章化し、場面まで検索できるようにします。
動画理解、動画 RAG、ナレッジベース
処理は次の3段です。
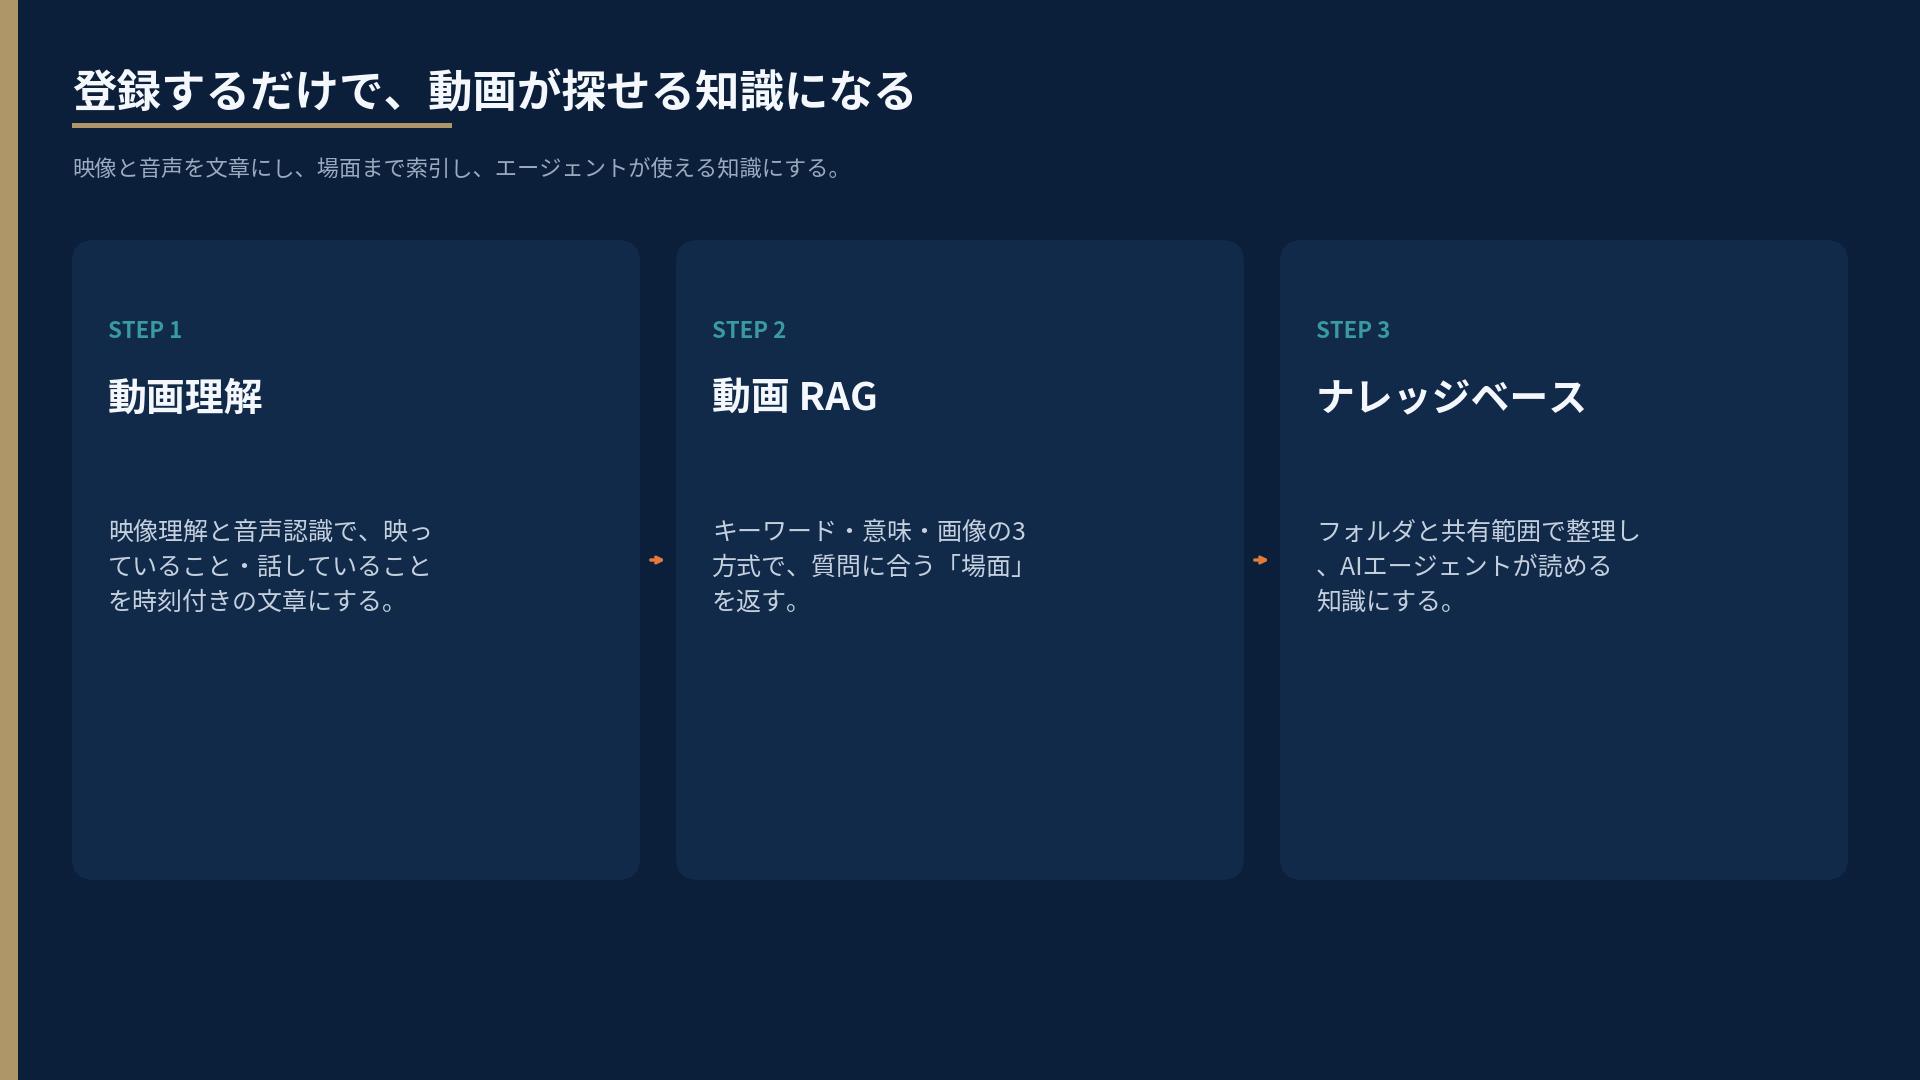
- 動画理解 ― 場面に分け、発話を文字に起こし、映像を説明する。全体サマリー・手順書・絵コンテの3種を自動で作る。
- 動画 RAG ― 全文・意味・画像で索引する。質問に合うのは「動画」ではなく、開始秒つきの場面。
- ナレッジベース ― 個人とグループの領域、階層フォルダで整理する。Luqua や業務システムからも、同じ範囲だけが見える。
同じ基盤で、現場・監視・比較・講義
現場の作業、監視、講義など、業務で撮った動画を同じ仕組みで扱います。
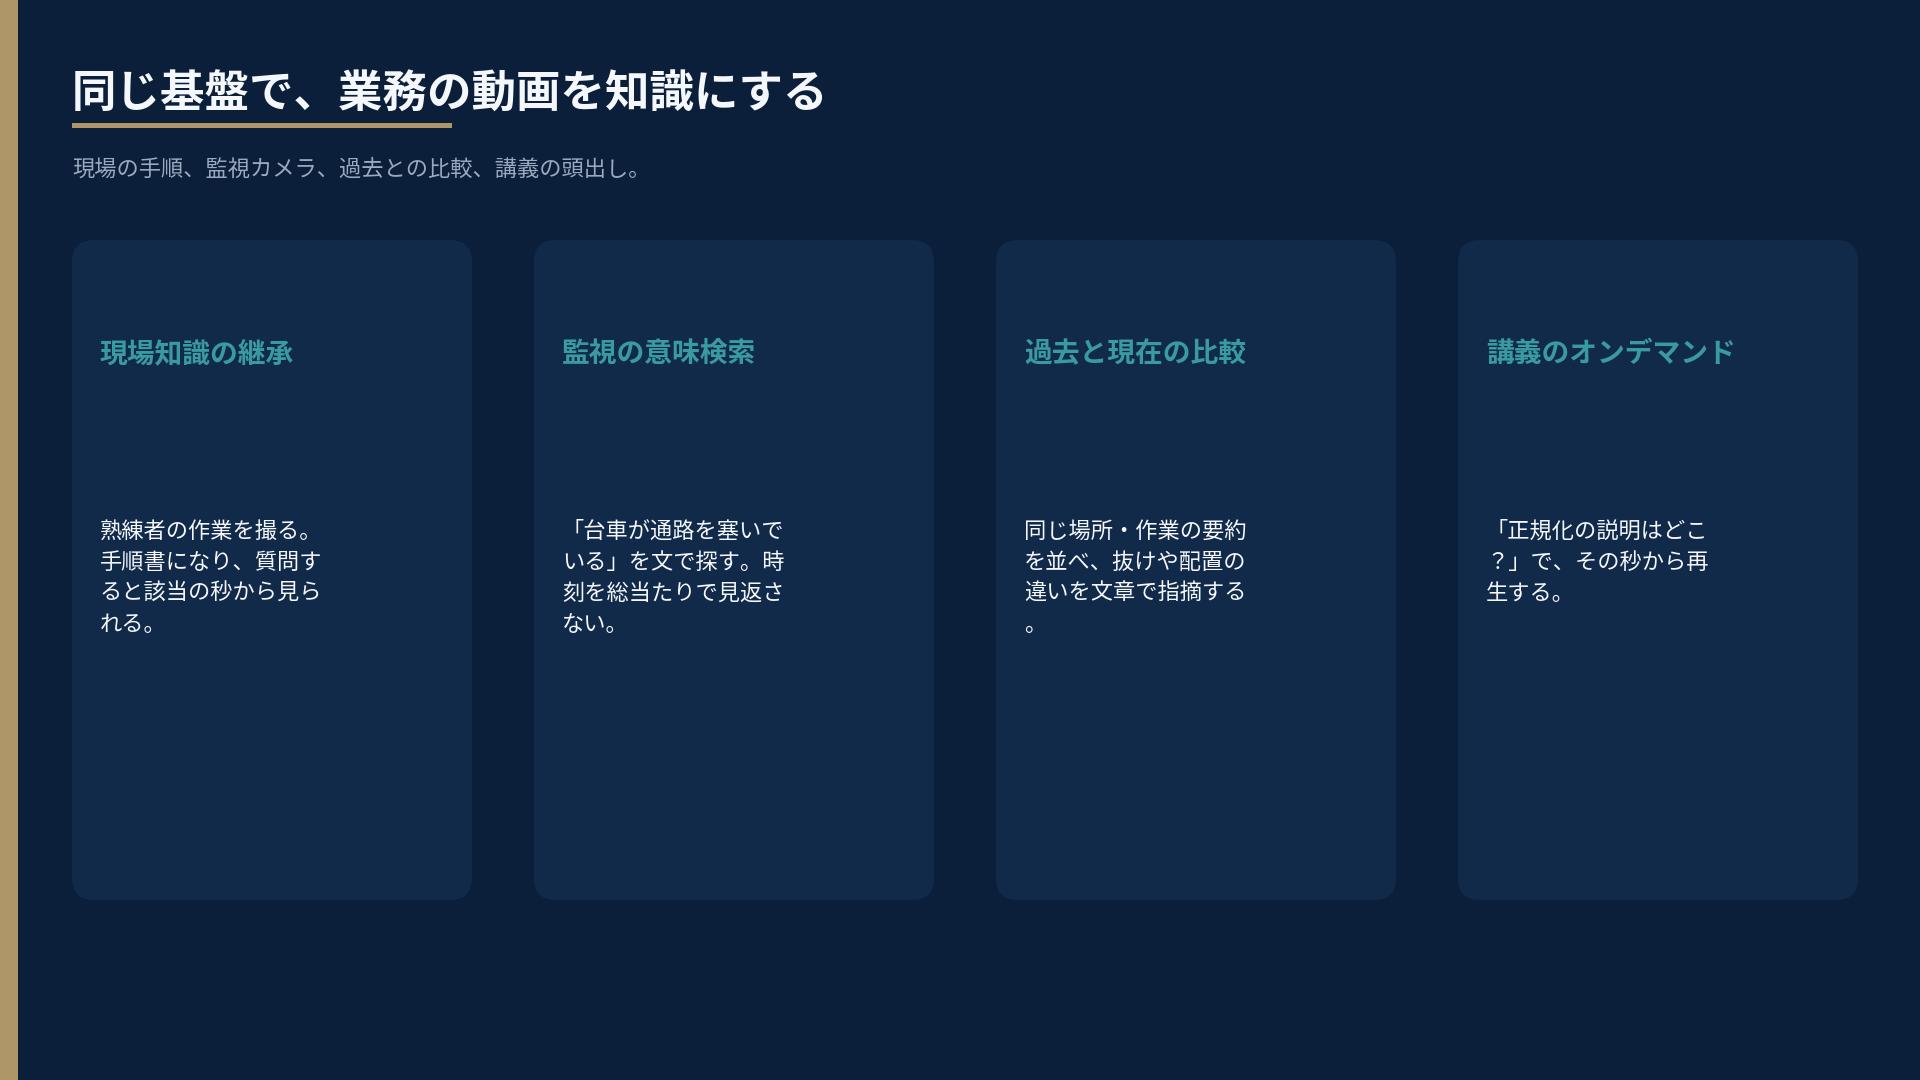
- 現場知識の継承 ― 熟練者の作業を撮る。手順に分解され、代表画像が付く。「0姿勢に戻すには」のような言い換えでも、意味検索で該当手順が1位になりました(90秒の操作動画での実測)。生成物は下書きで、現場リーダーが直してから標準にする前提です。
- 監視カメラの意味検索 ― 「台車が通路を塞いでいる」を文で探す。現状は、区切った録画ファイルをフォルダへ一括登録するバッチ方式です。常時の取り込みとアラートは、今後の拡張です。
- 過去と現在の比較 ― 同じ形式の要約が残るので、並べて抜けや配置の違いを文章にできます。比較の文章化は Luqua 側の構成例で、専用画面はこれから。
- 講義のオンデマンド ― 「正規化の説明はどこ?」で、その秒から再生する。全体の要旨と絵コンテで、先に流れをつかめます。
手順が音声で説明されている動画ほど、手順書は良くなります。1本1作業、数分以内が扱いやすい目安です。
クラウドに出さない
Video RAG は、映像理解・音声認識・意味検索・画像検索のモデルをすべてサーバ内に置きます。データベースもサーバ内です。外部の動画AIは呼びません。
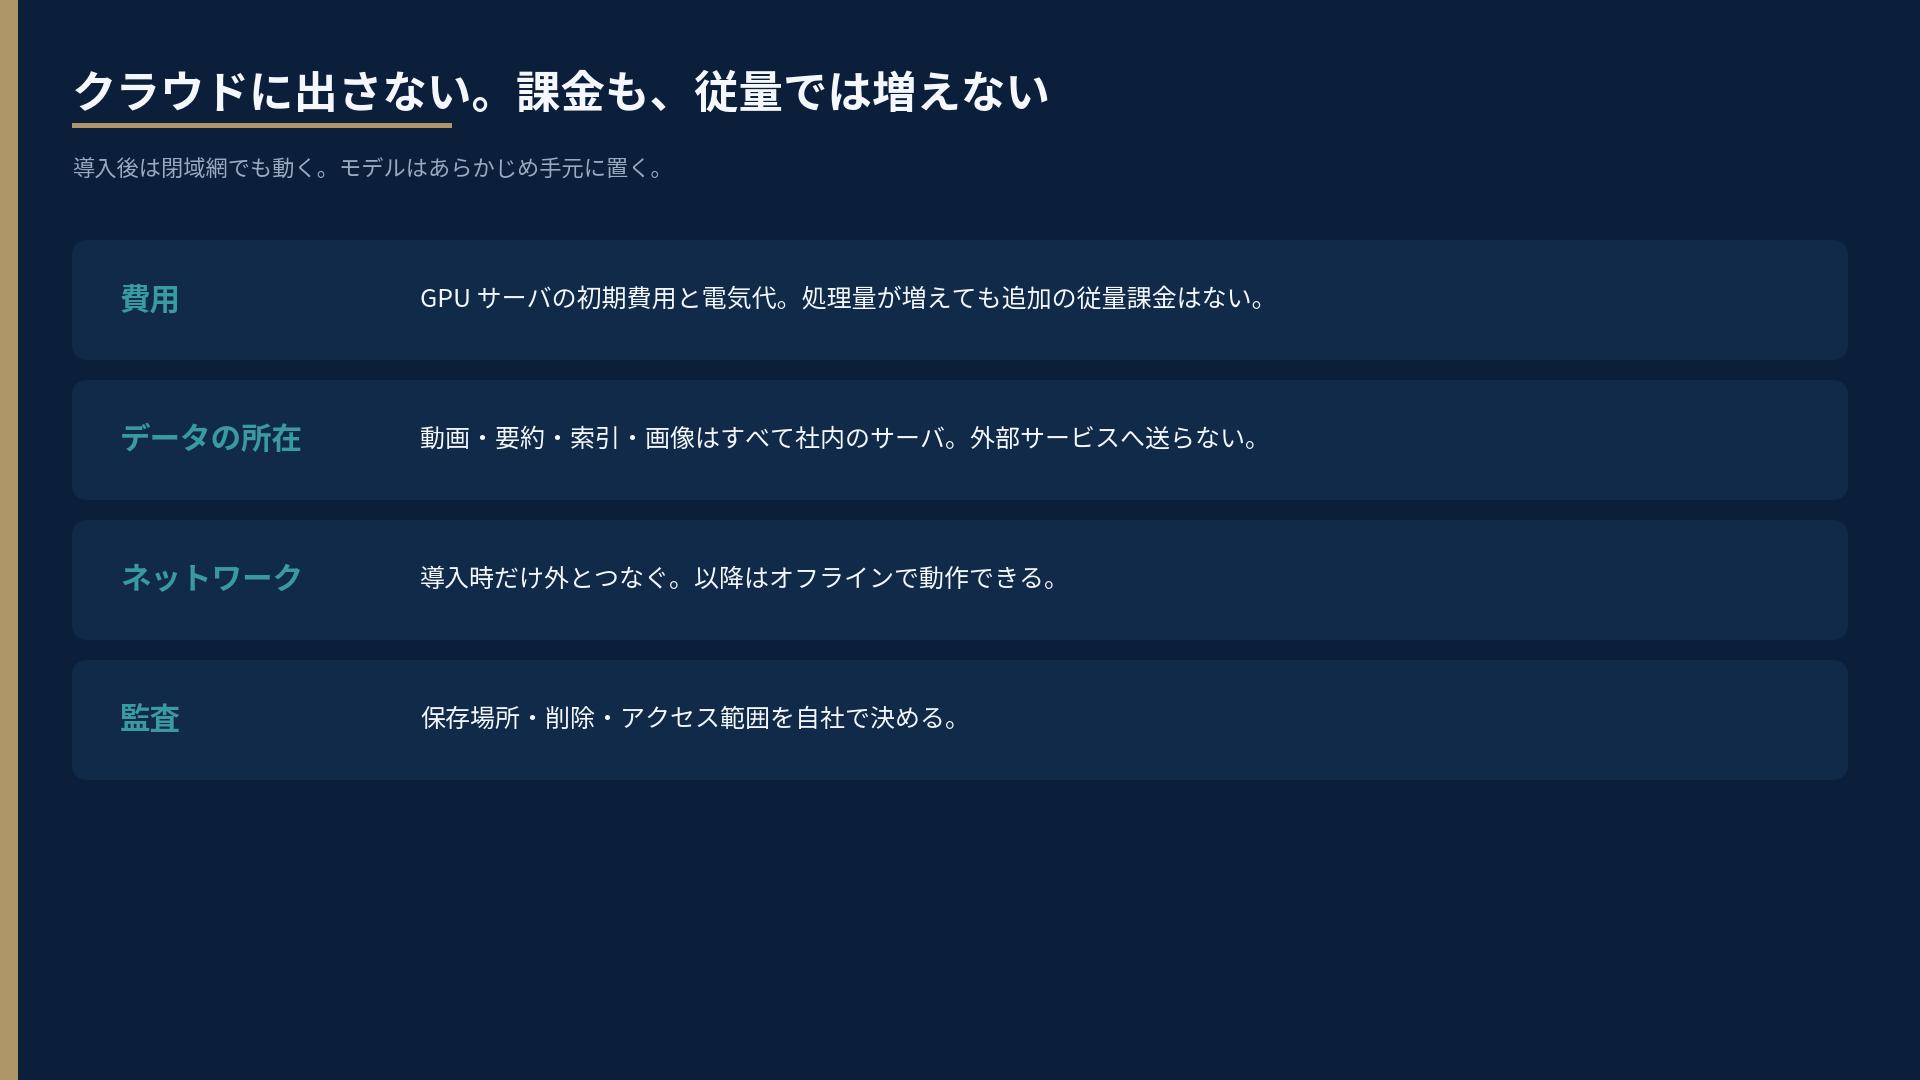
- 費用 ― GPU サーバの初期費用と電気代。処理量が増えても、長さや本数の従量課金は乗らない。
- データの所在 ― 動画・要約・索引・画像は社内のディスク。外部サービスへ送らない。
- ネットワーク ― 導入時にモデルを一度置く。以降はオフラインで動作できる。
- 監査 ― 保存場所・削除・見える範囲を自社で決める。動画を消すと、要約と索引と画像も一緒に消えます。戻せません。
検証環境は NVIDIA GPU 24GB・Linux です。常駐時のモデル読み込みは、この GPU メモリに収まる前提で測っています。同じ GPU で他の重い処理は動かさず、処理は1本ずつ行います。
登録すると、検索できるまで自動で進む
画面から複数本をまとめて入れると、以降の処理はサーバ側で進みます。
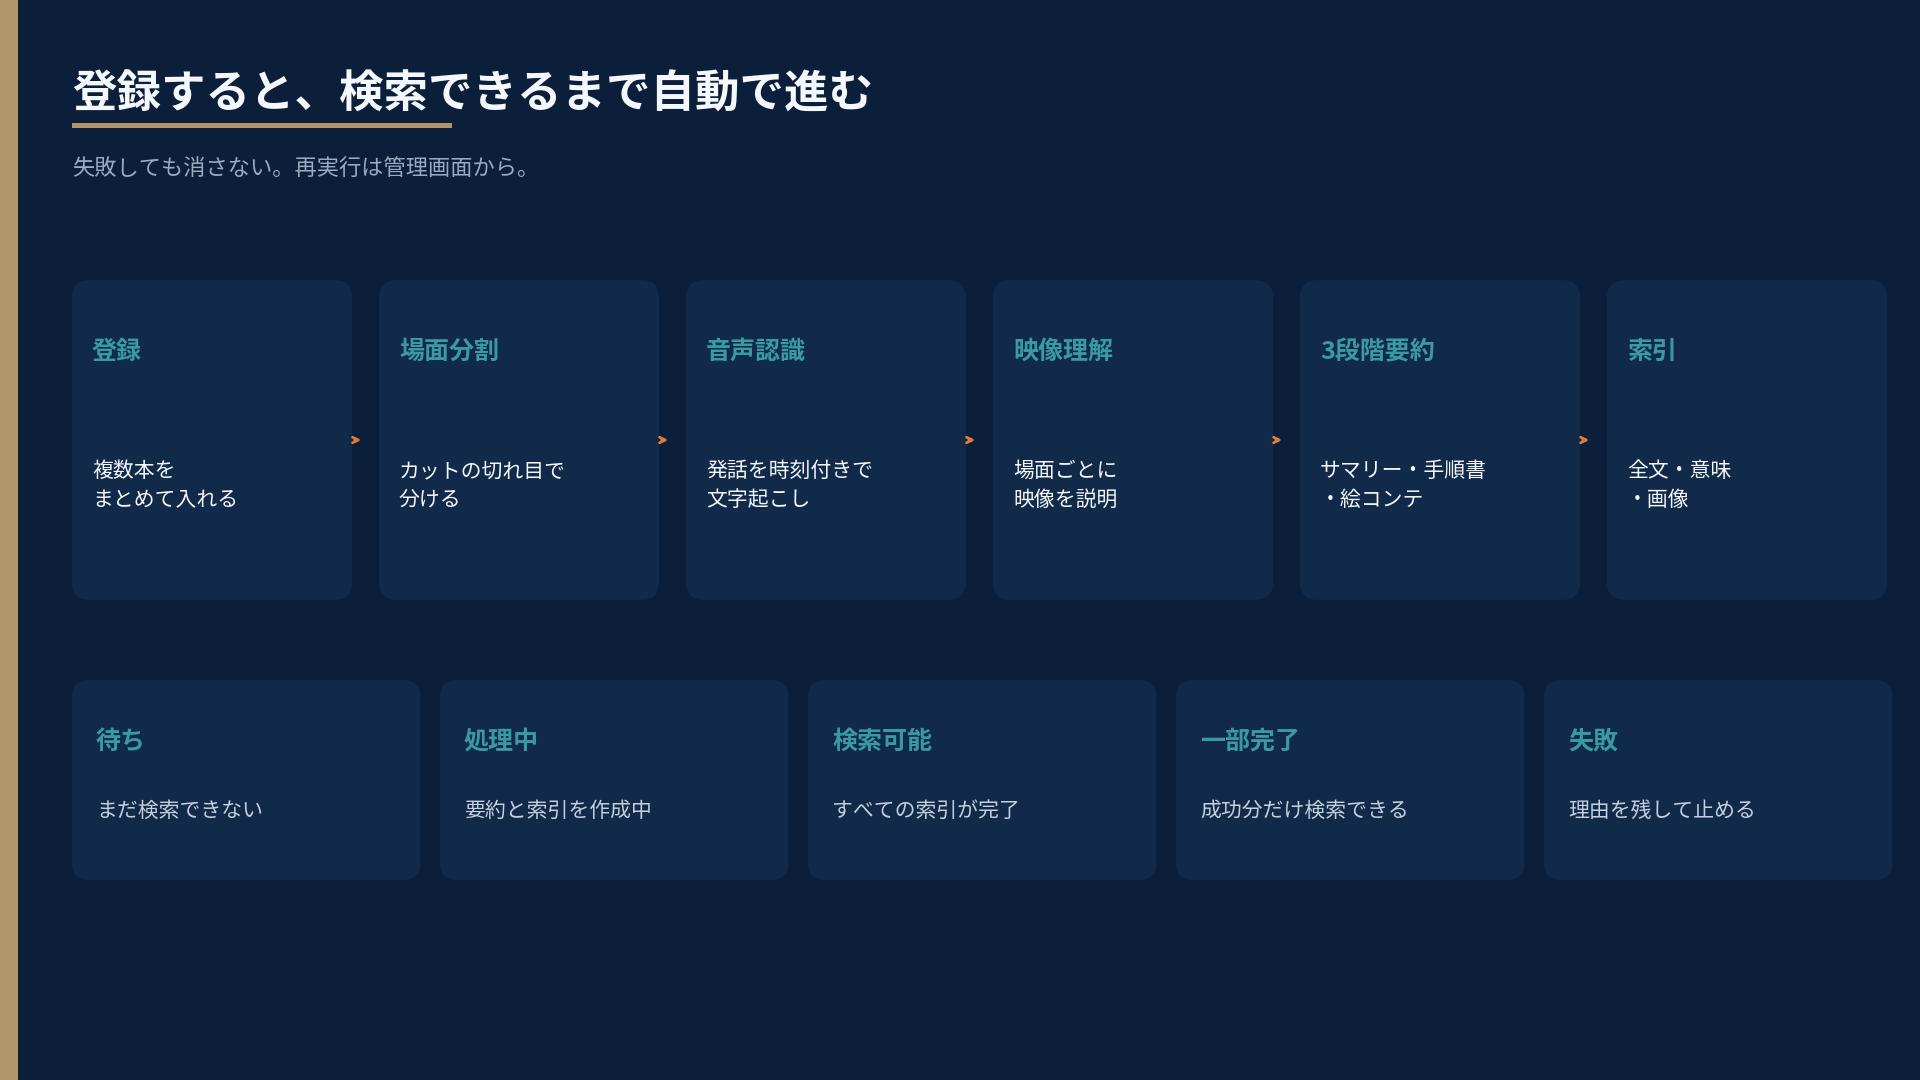
状態は5つです。待ちと処理中はまだ探せません。検索可能で全索引が揃い、一部完了は成功した要約だけ探せます。失敗は理由を残して止めます。失敗した動画を自動で消したり、勝手に再実行したりはしません。再起動で処理中の動画は止まるので、管理画面からやり直します。
1本から、3種類の文書
同じ動画が、用途の違う3つの文書になります。どれも検索対象です。
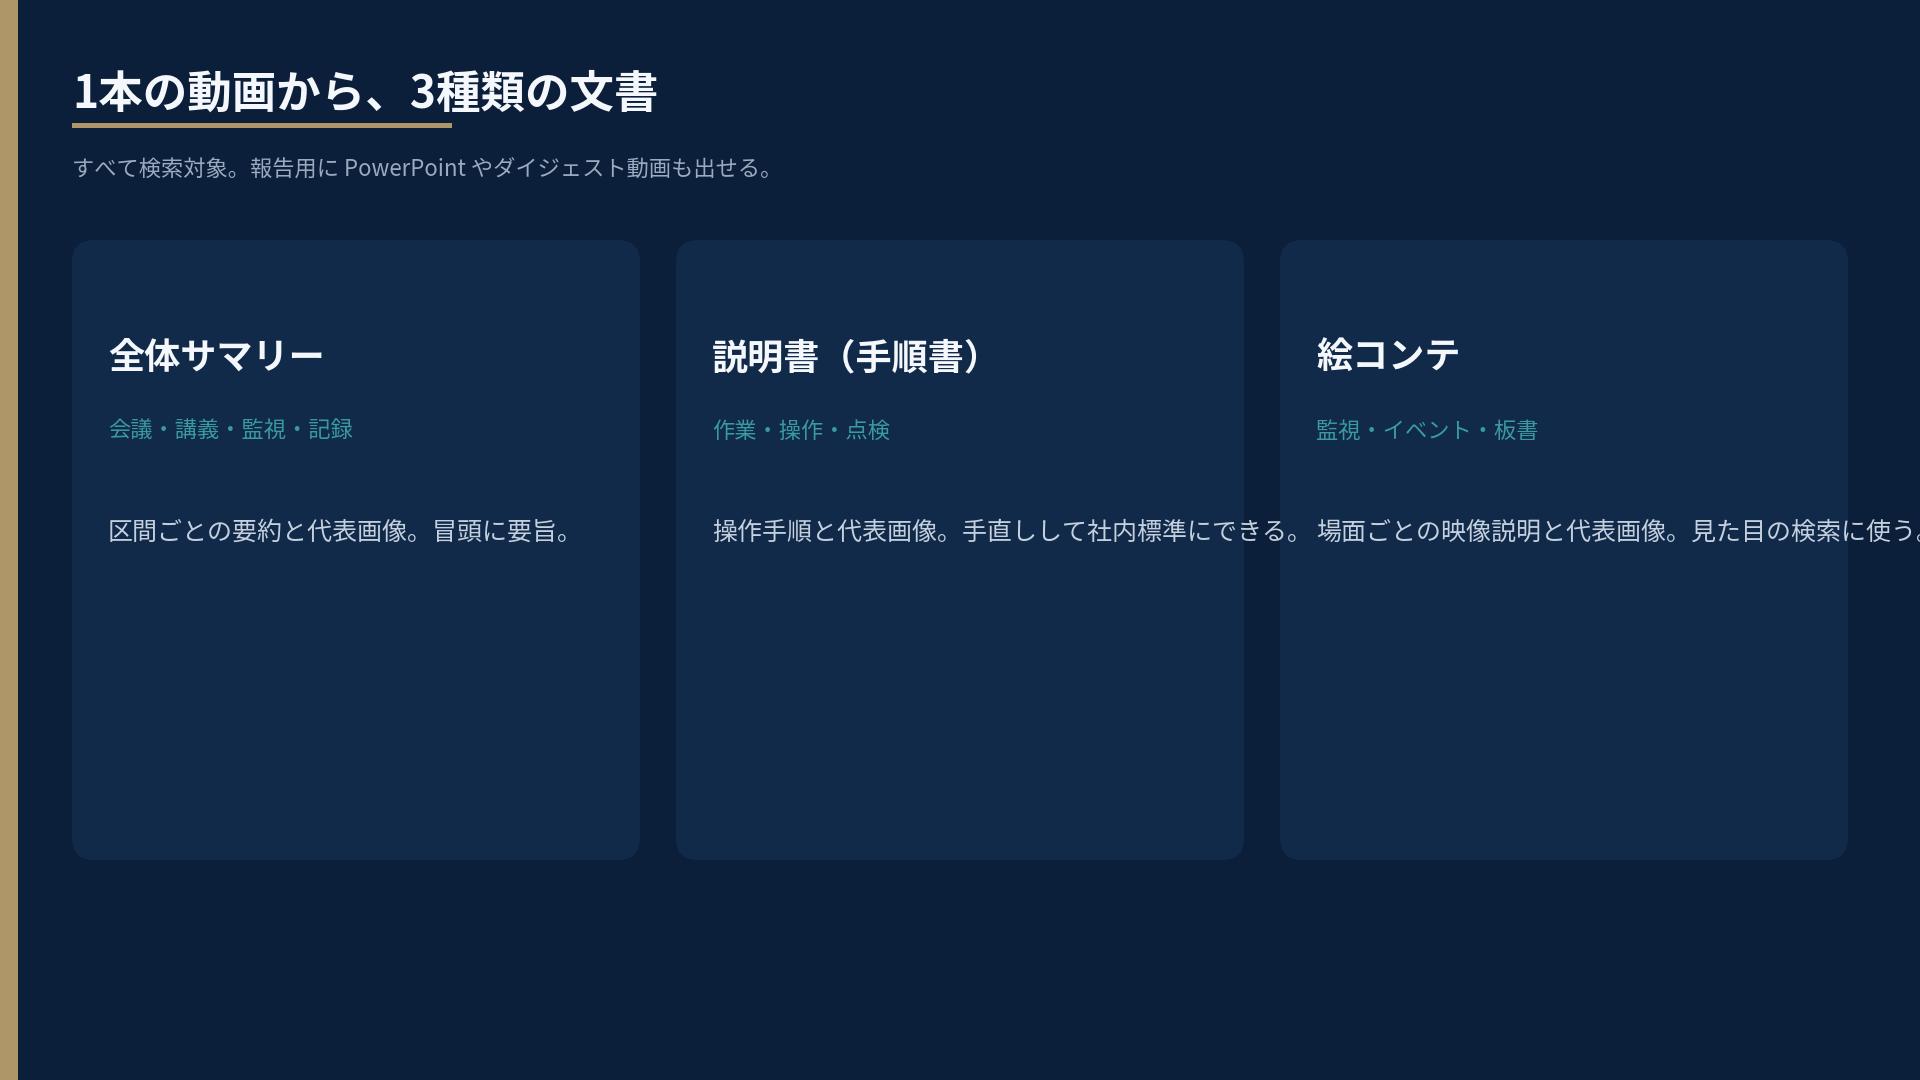
| 種類 | 向く動画 | 中身 |
|---|---|---|
| 全体サマリー | 会議・講義・監視・記録 | 区間ごとの要約と代表画像。冒頭に要旨 |
| 説明書(手順書) | 作業・操作・点検 | 操作手順と代表画像。手直しして標準にできる |
| 絵コンテ | 監視・イベント・板書 | 場面ごとの映像説明と代表画像 |
音声認識の誤字や、手順の抜けはあり得ます。重要文書は人が確認する前提です。
3つの探し方。結果は「動画+開始秒」
押すと、その場面から再生されます。

- キーワード ― 要約と発話の全文から、語が全部含まれる箇所を探す。固有名詞・型番向き。
- 意味 ― 文の近さで探す。語が一致しなくてよい。言い換え向き。
- 画像 ― 3秒ごとのフレームから、文と見た目が近い場面を返す。現状は英語の文が有効です。日本語で見た目を探すときは、絵コンテの意味検索を使います。
絞り込みは、要約の種類、フォルダ(下の階層を含む)、動画1本です。キーワード自己試験は、登録済み20本×2語で、元の動画が上位5件に入るかを画面から回せます。この検証では 40 / 40 でした。
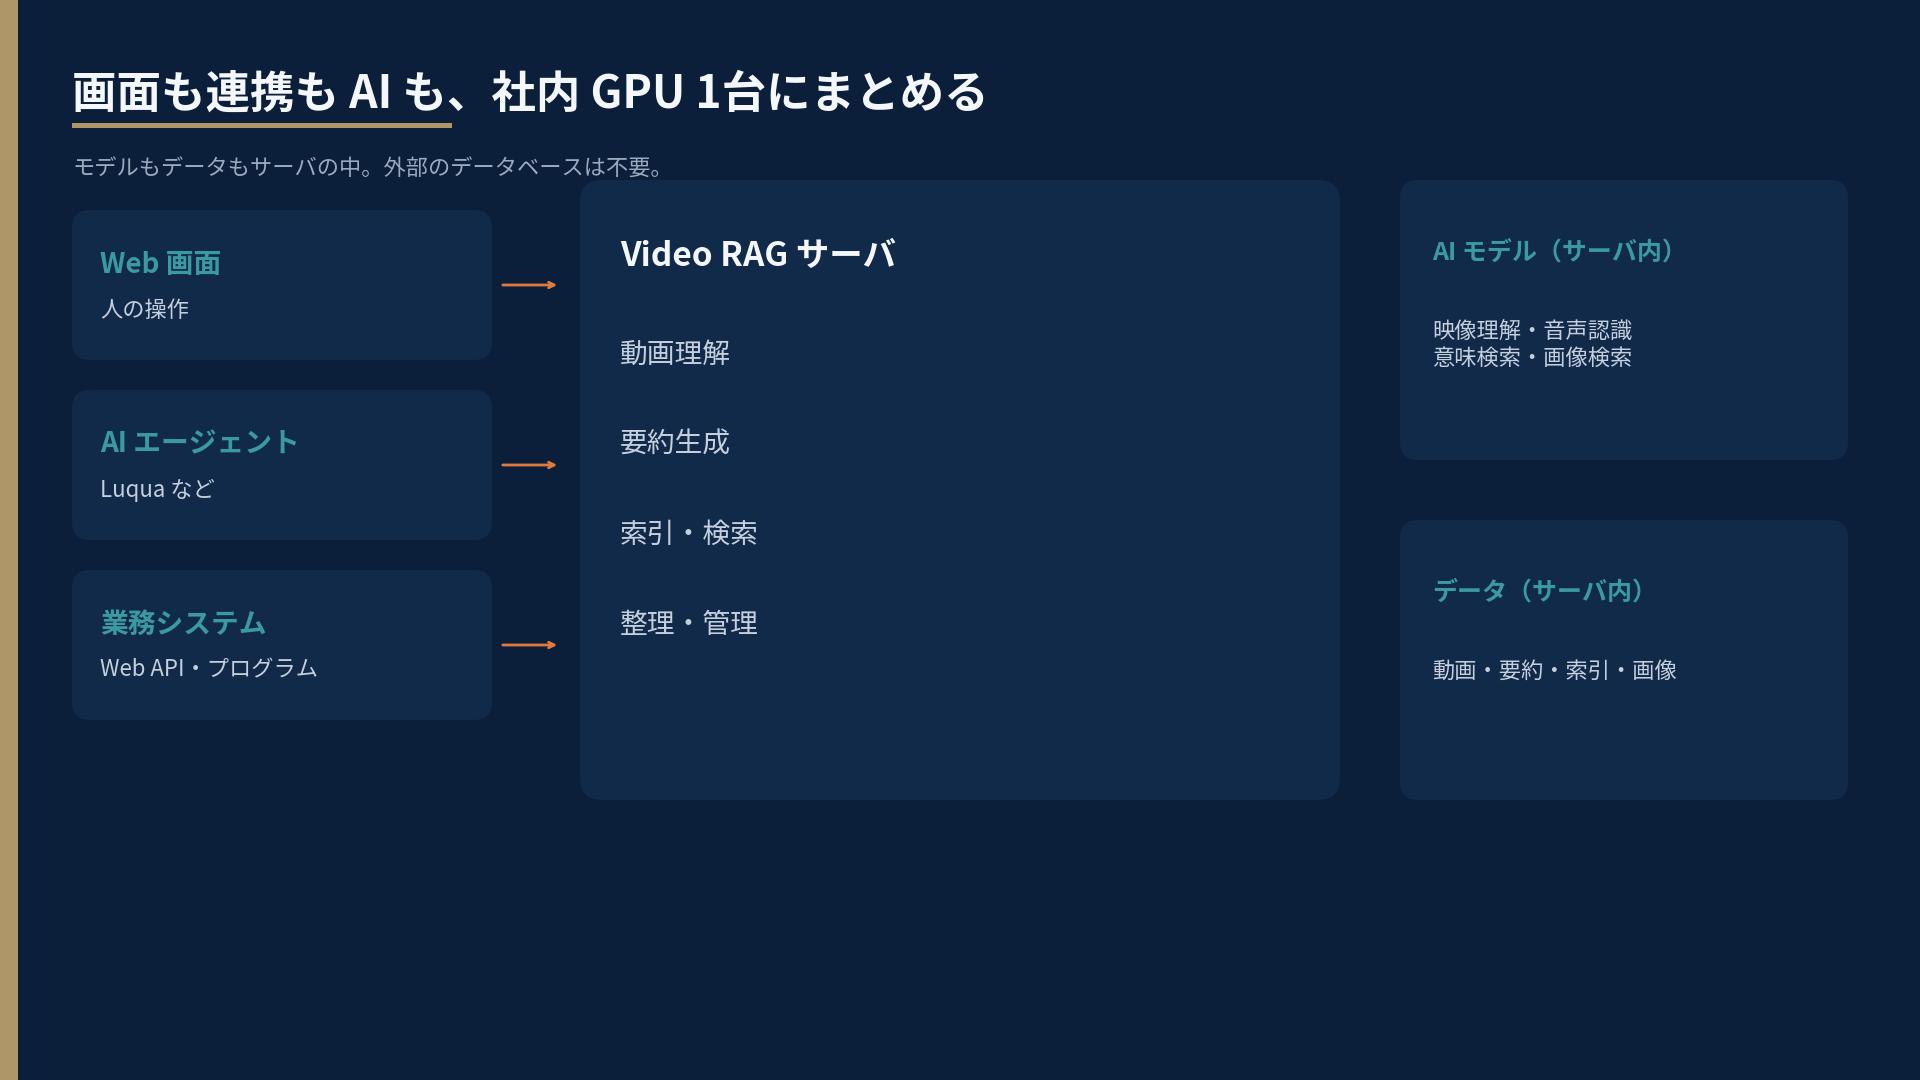
画面も連携も、社内 GPU 1台にまとめる
Web画面、Luqua、業務システムから使えます。どれも同じサーバに接続します。
画面では、左に個人とグループのフォルダ、上で登録、中で3方式の検索、下に一覧と状態が出ます。要約の時刻を押すと、そこから再生します。
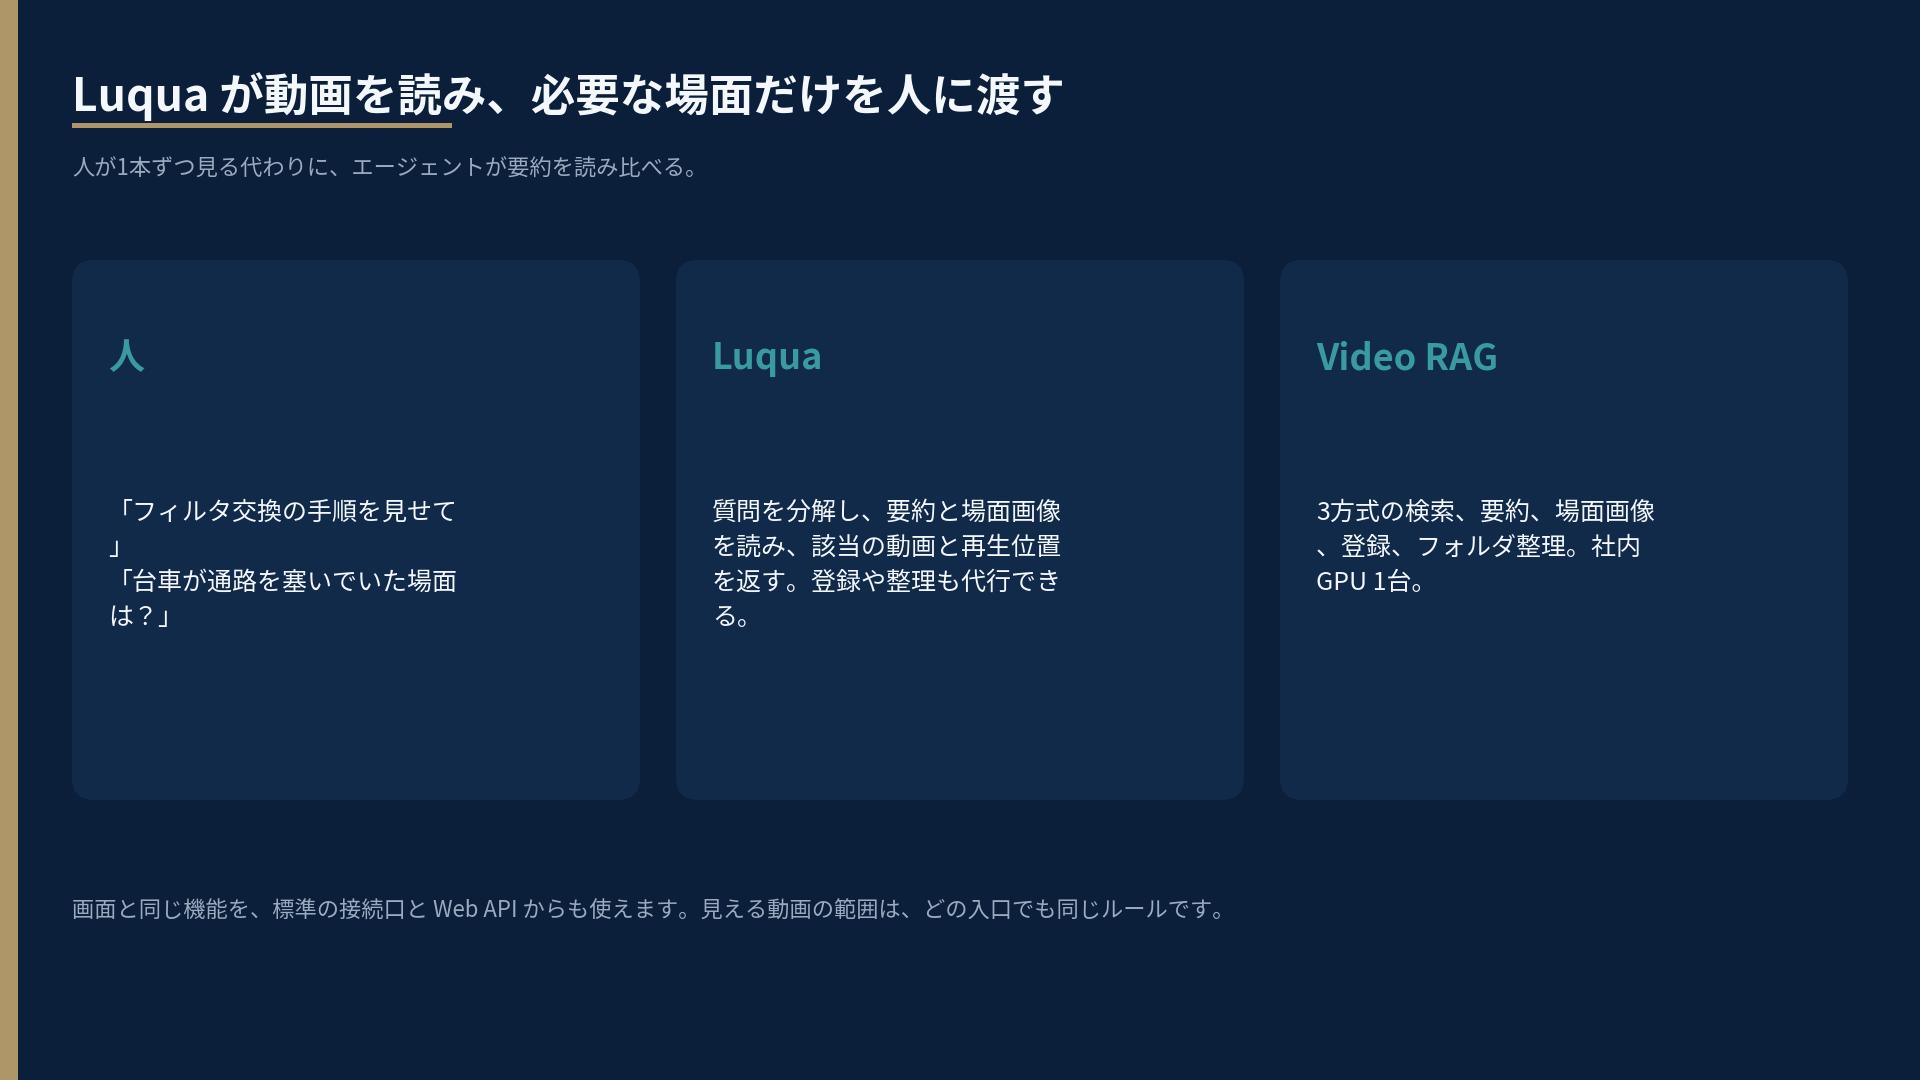
画面と同じ操作を、標準の接続口と Web API からも呼べます。見える範囲は入口によらず同じで、自分の動画と、所属グループに共有された動画だけです。権限のない動画は返しません。変更と削除は所有者だけです。
本体は利用者認証を持ちません。初期設定では、サーバ自身からの接続だけを受け付けます。社内に公開するときは、認証付きの中継の後ろに置き、中継が利用者とグループを渡す構成を推奨します。Luqua から使うときも、エージェント側で利用者を確定させてから渡します。
この検証での実測
2026-09-25 から 09-29。NVIDIA GPU 24GB、標準設定です。
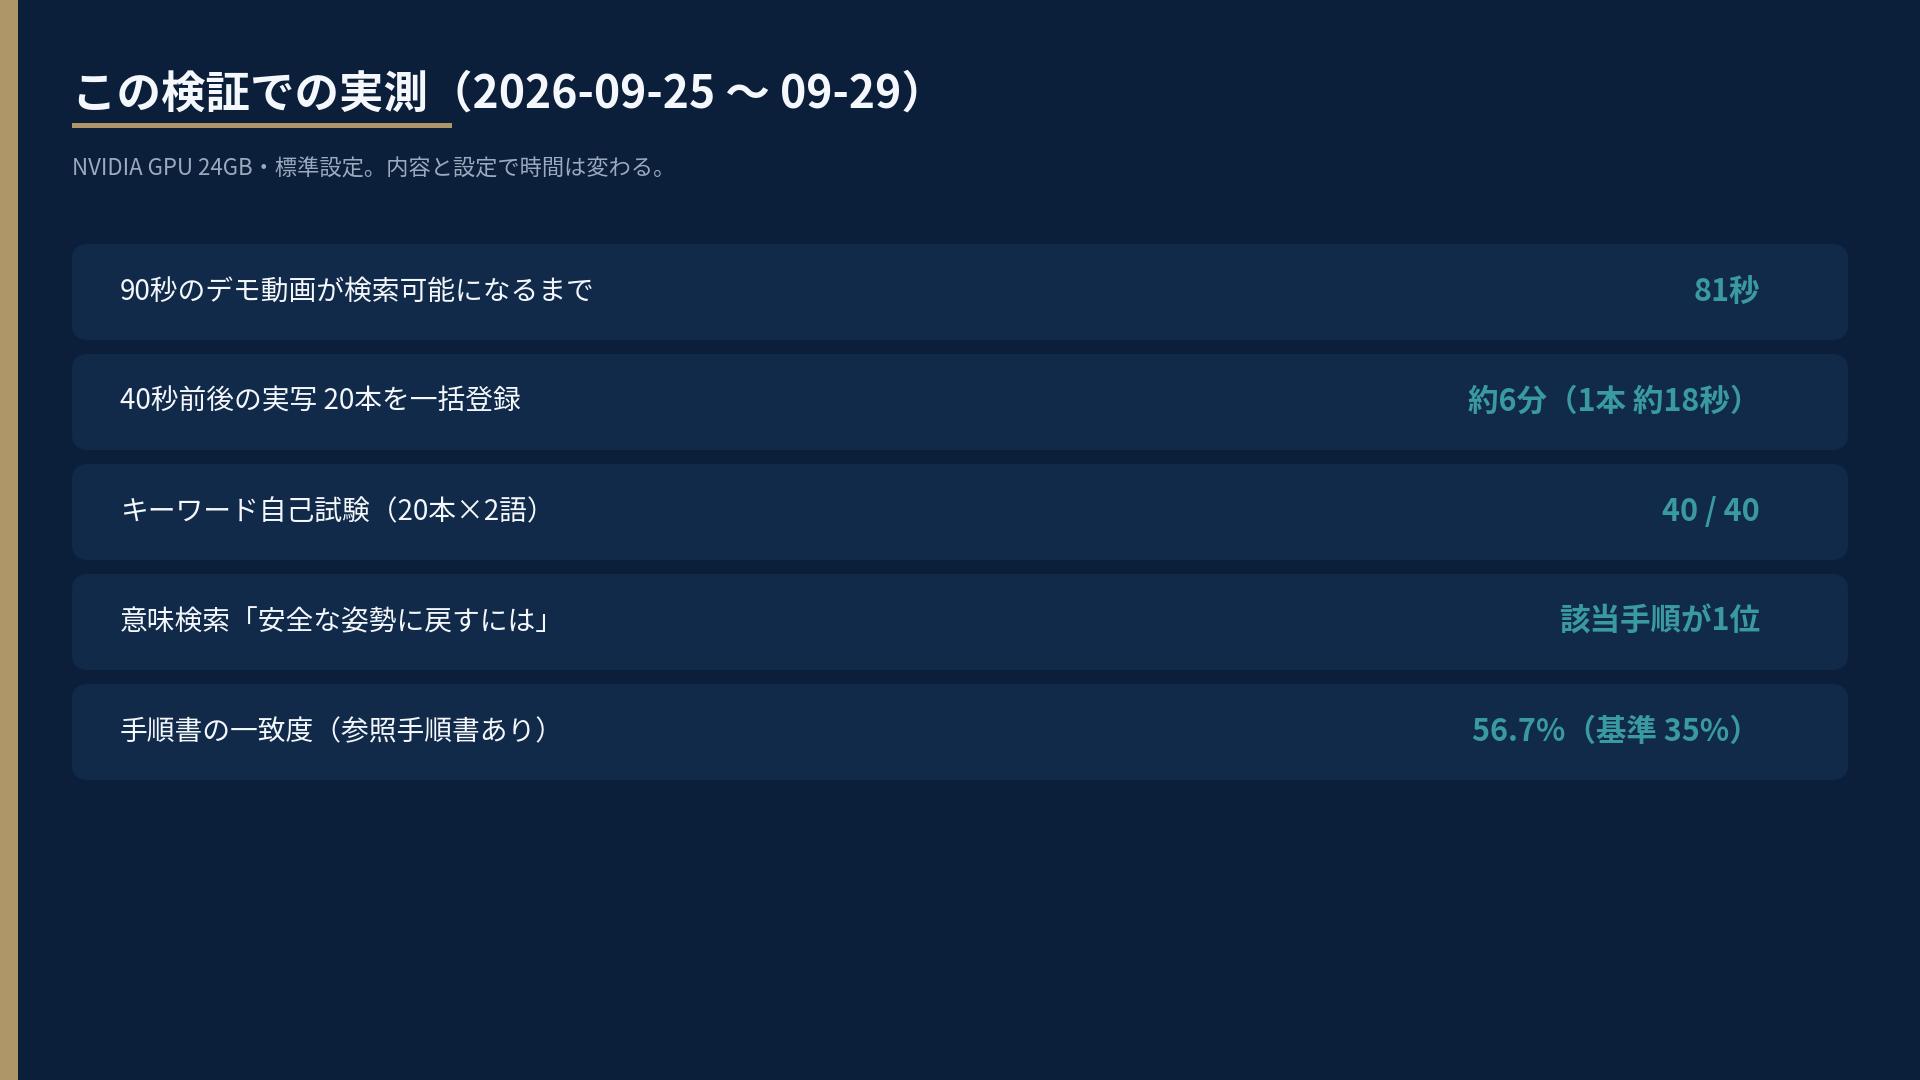
- 90秒のデモ動画が検索可能になるまで ― 81秒(要約3種、検索単位16、フレーム42枚)。
- 40秒前後の実写20本 ― 約6分(1本 約18秒)。会話・ナレーション入り。失敗0。
- キーワード自己試験 ― 40 / 40。元の動画が上位5件以内。
- 意味検索 ― 「ロボットを安全な姿勢に戻すには」で、該当手順が1位。
- 手順書の一致度 ― 参照手順書ありで 56.7%(基準 35%)。デモ動画の手順4つ。基準は超えましたが、公開前の人手確認は必要です。
- サーバ起動 ― 初回のモデル読み込み 約6分。2回目以降は短くなります。
導入時は、1日に登録する動画の長さから GPU 台数を見積もります。検索だけなら GPU 負荷は小さめです。
今の制約
- 本体に利用者認証はない ― 社内公開は、認証付きの中継の後ろで。
- 画像検索は英語が有効 ― 日本語の見た目検索は、絵コンテの意味検索で代替。
- 処理は GPU 1台で1本ずつ ― 本数が増えたら、登録用の GPU を分ける。
- 監視はバッチ登録 ― 連続取り込みとアラートはこれから。
- 再起動で処理中は止まる ― 管理画面から再実行。
- 要約は下書き ― 誤字や抜けがあり得る。重要文書は人が見る。
使う AI モデルのライセンスは、導入前に確認が必要です。
まとめ
- 登録すると場面まで探せる ― 要約・手順書・絵コンテができ、開始秒つきで検索できる。
- 探し方は3つ ― キーワード、意味、画像。結果を押すとその場面から再生する。
- Luqua と連携できる ― エージェントが要約を読み、必要な秒だけ人に渡す。
- クラウドには出さない ― モデルもデータも社内 GPU 1台。従量課金は乗らない。
- 数字はこの検証の範囲 ― 90秒が81秒で検索可能、20本で40/40、手順書の一致は56.7%。下書きは人が直す前提。
デモやご相談を承っています。