作業のやり方は、現場の動画には残っています。残らないのは、次の人が読める手順書です。撮影したあと、人が止め絵を切り、文言を書き、体裁を整える。その往復が、更新のたびに戻ってきます。
当社では、現場の操作動画を入れるだけで、写真つきの手順書まで手元のPCで書き出す流れを作りました。映像の理解と音声認識で手順を切り出し、代表写真を添えて Word / PowerPoint / PDF / HTML にします。生成も音声認識も、このPCの中で完結します。クラウドAIは使いません。2026-09-24 の実証では、ロボットアームの基本操作(90秒)を題材に、要約48秒・取り込み3秒・書き出し13秒〜で文書になりました。
紹介映像
動画を入れるだけ。写真つきの手順書が、このPCの中でできる
やりたいことは単純です。撮った動画を渡し、読める文書を受け取る。
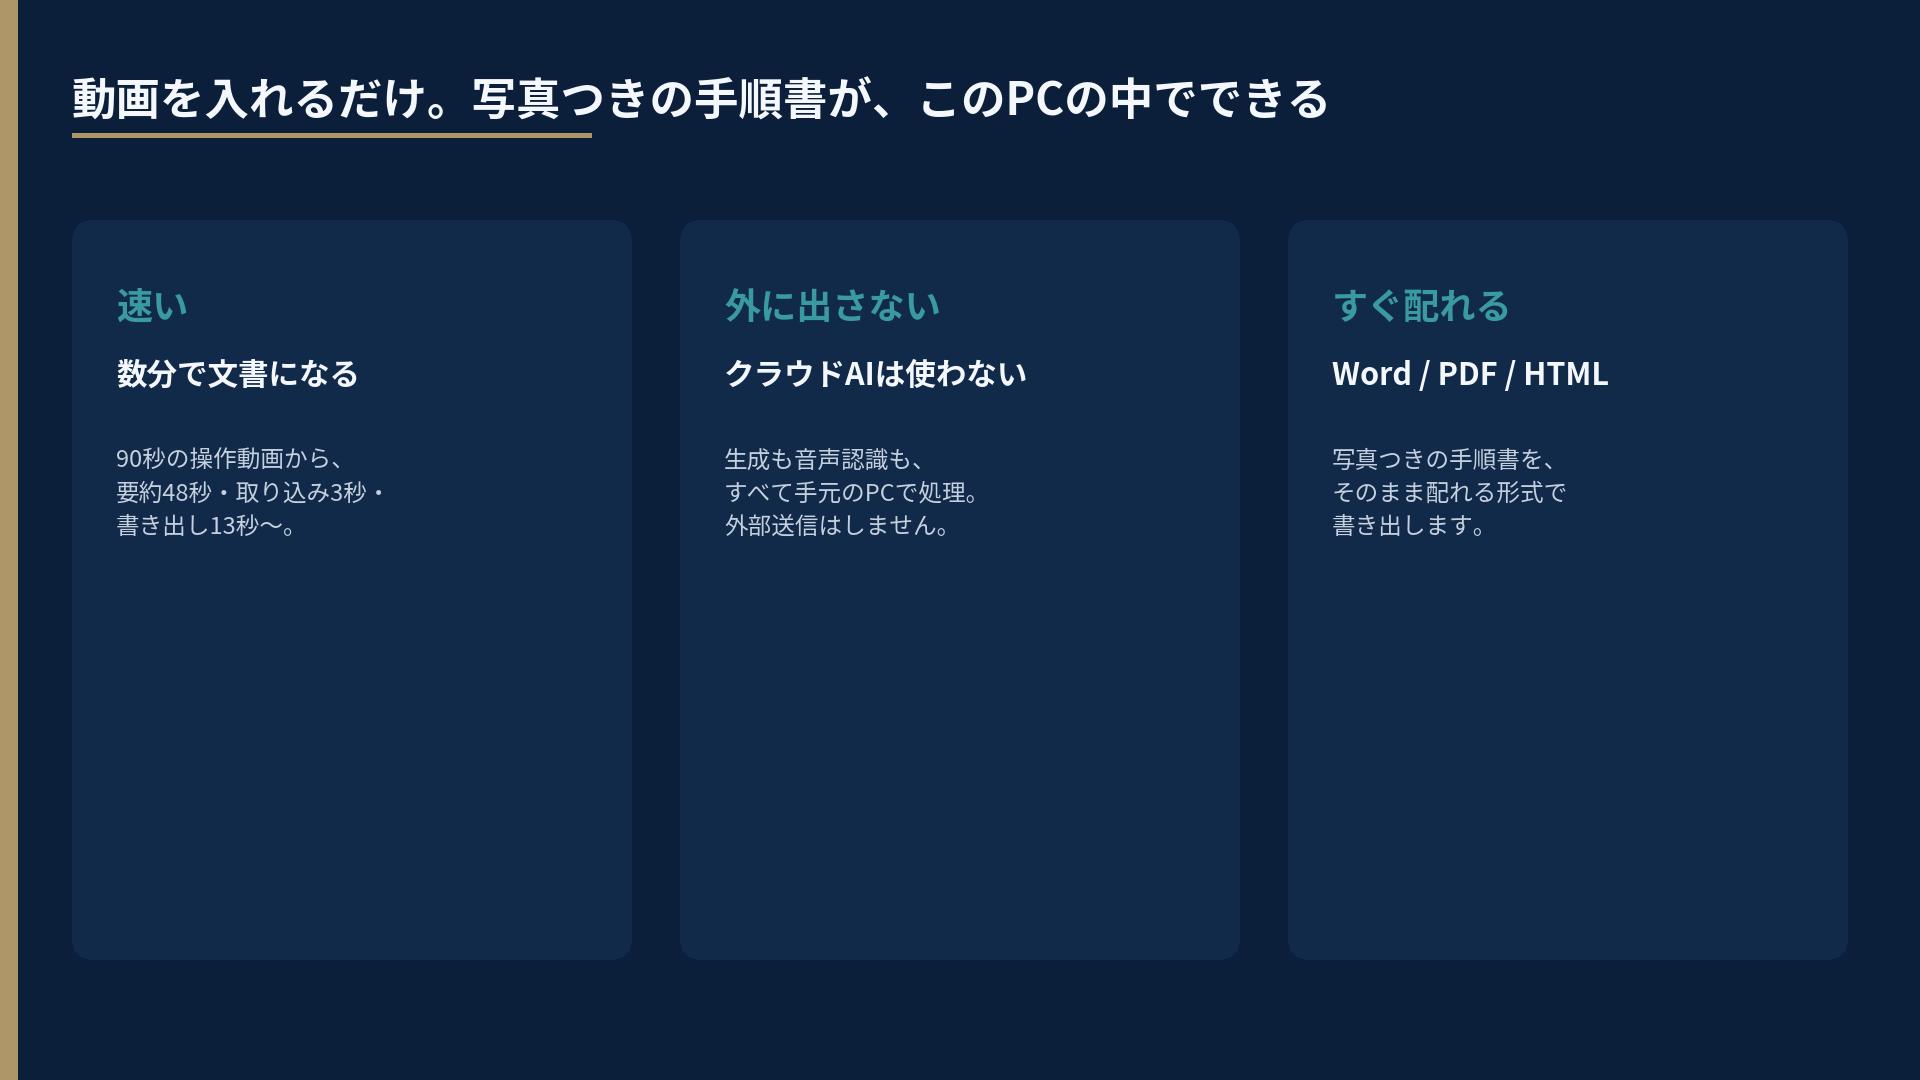
- 速い ― 数分で文書になる。この実証では、90秒の操作から1分強でたたき台まで届きました。
- 外に出さない ― クラウドAIは使わない。映像も音声も、外部へ送りません。
- すぐ配れる ― 写真つきの手順書を、そのまま配れる形式で書き出します。
現場の動画は、人の手元や装置の画面を映します。クラウドへ上げると、見せたくないものが一緒に出ていきます。だから、処理は手元に置きます。
全体の流れ。入力は動画1本だけ
処理は2段です。まず動画から手順を切り出し、次に写真を添えて文書にします。途中にクラウドAIは入りません。
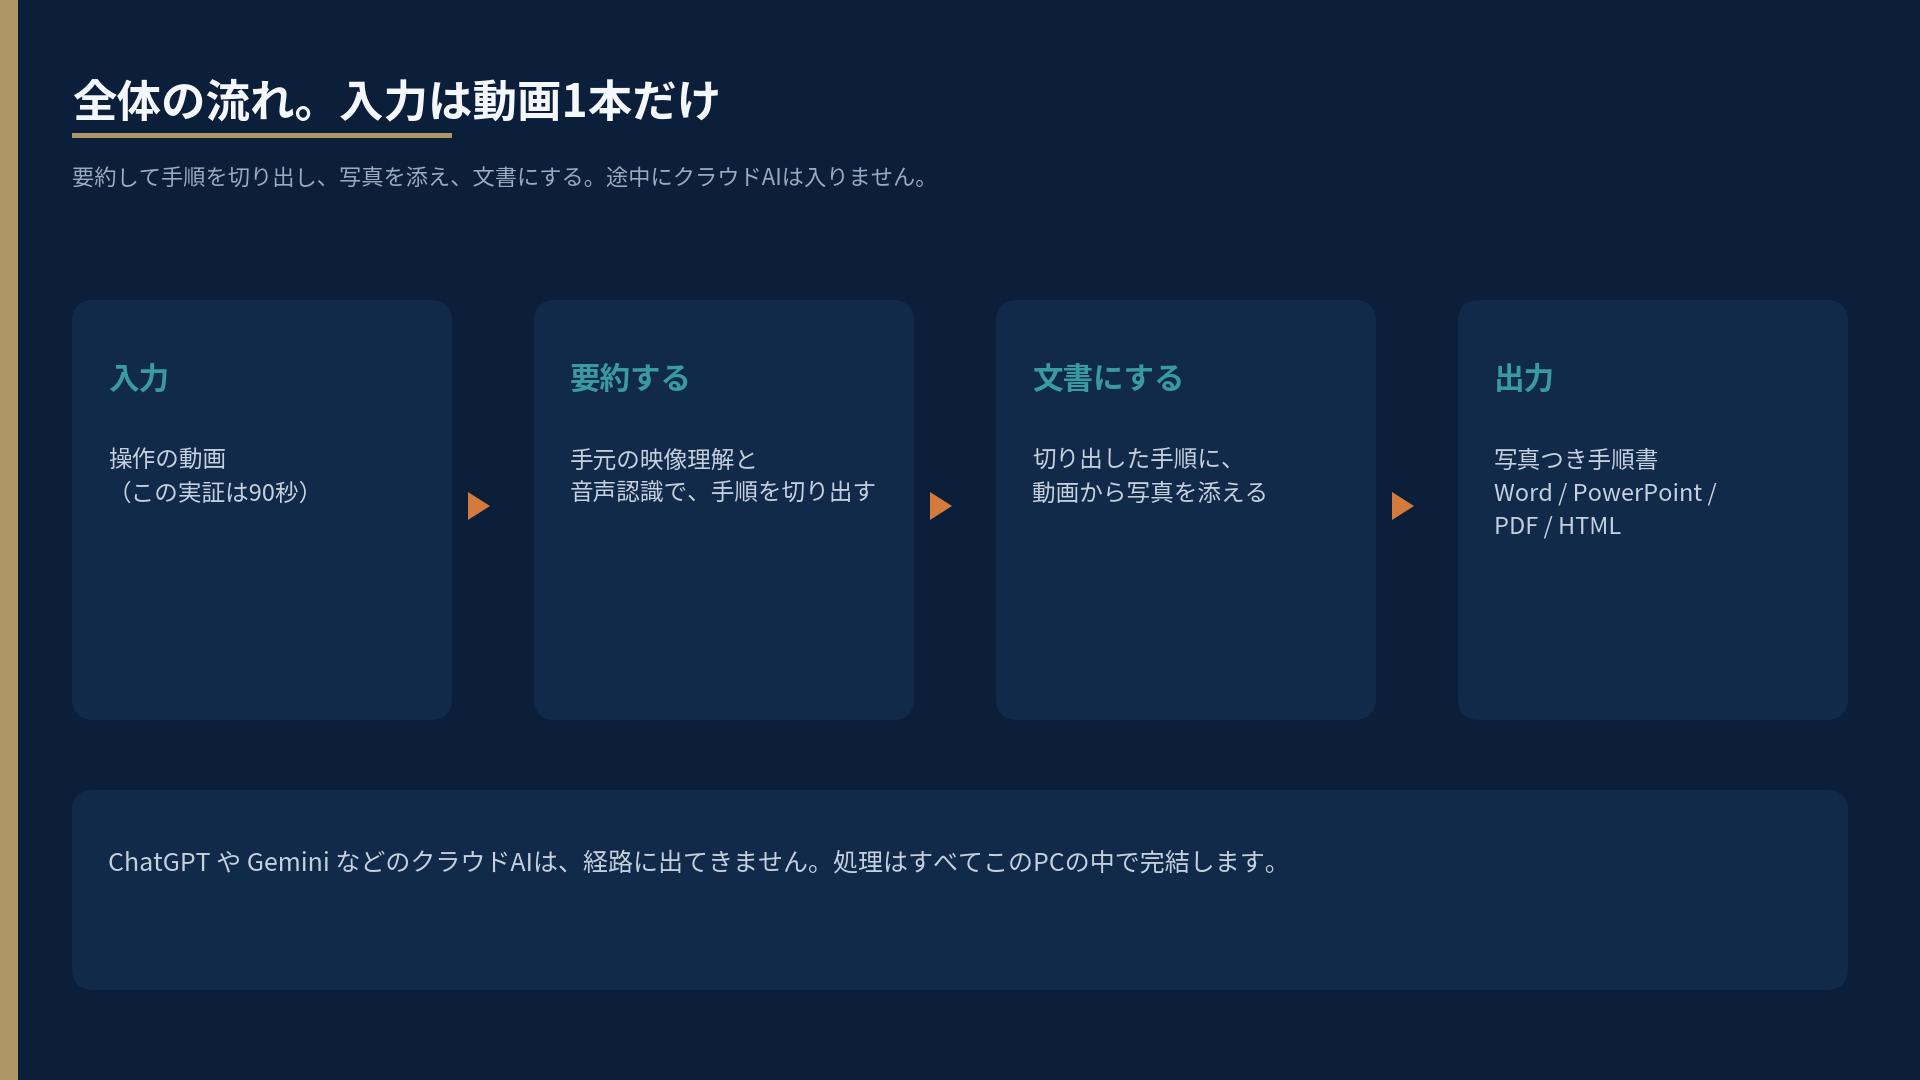
- 入力 ― 操作の動画。この実証の題材は90秒です。
- 要約する ― 手元の映像理解と音声認識で、手順の切れ目と文言を切り出します。
- 文書にする ― 切り出した手順に、動画から代表写真を添えます。
- 出力 ― 写真つきの手順書を、配りたい形式で書き出します。
ChatGPT や Gemini などのクラウドAIは、経路に出てきません。処理はすべてこのPCの中で完結します。
ネットワークを切っても、手順書はできた
「ローカル」と書いてあっても、途中で外へ出ていないかは、切ってみないと分かりません。この実証では、実行中に外部への接続をすべて遮断しました。
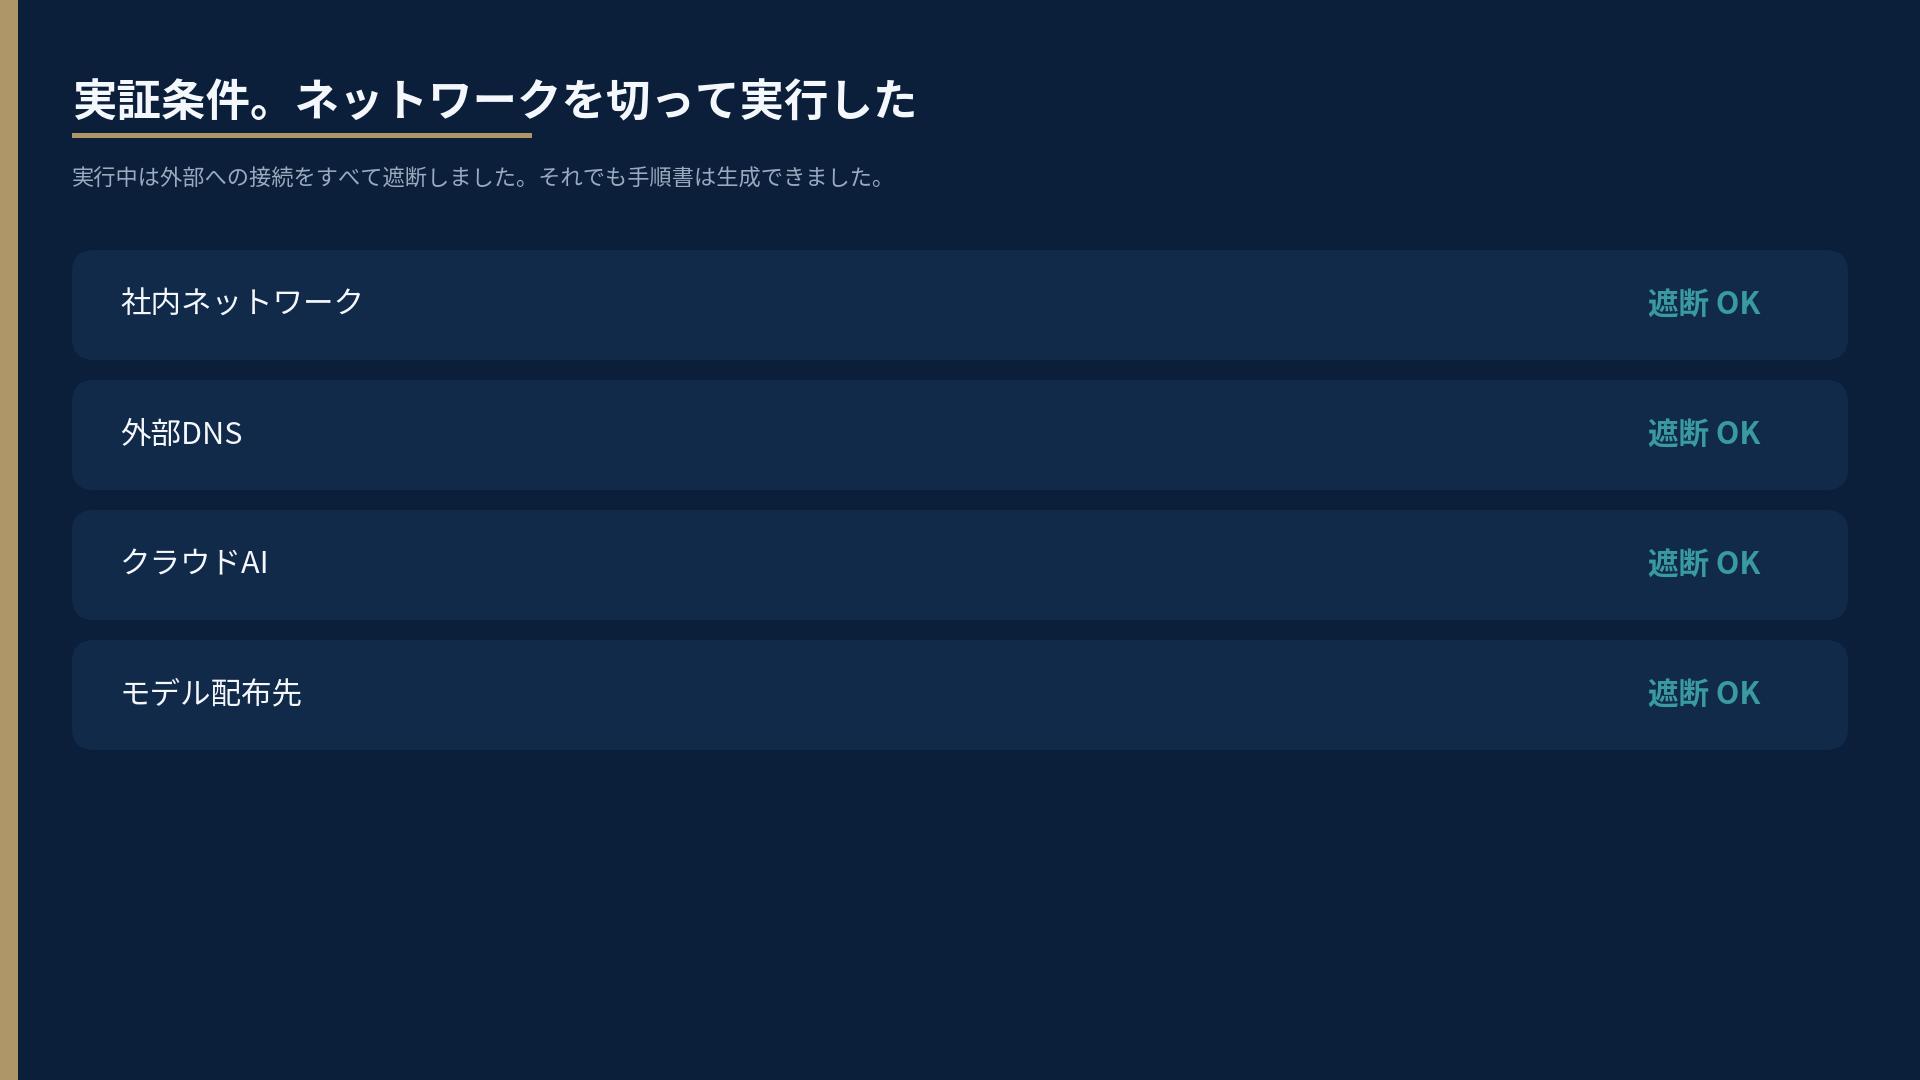
モデルはあらかじめ手元に置いてあります。実行中に取りに行きません。現場の映像を外へ出さずに、同じ流れを回せます。
AIが切り出した4つの手順
題材は、ロボットアームの基本操作です。90秒の動画から、次の4ステップと注意事項が切り出されました。各ステップの代表写真も、自動で選んでいます。
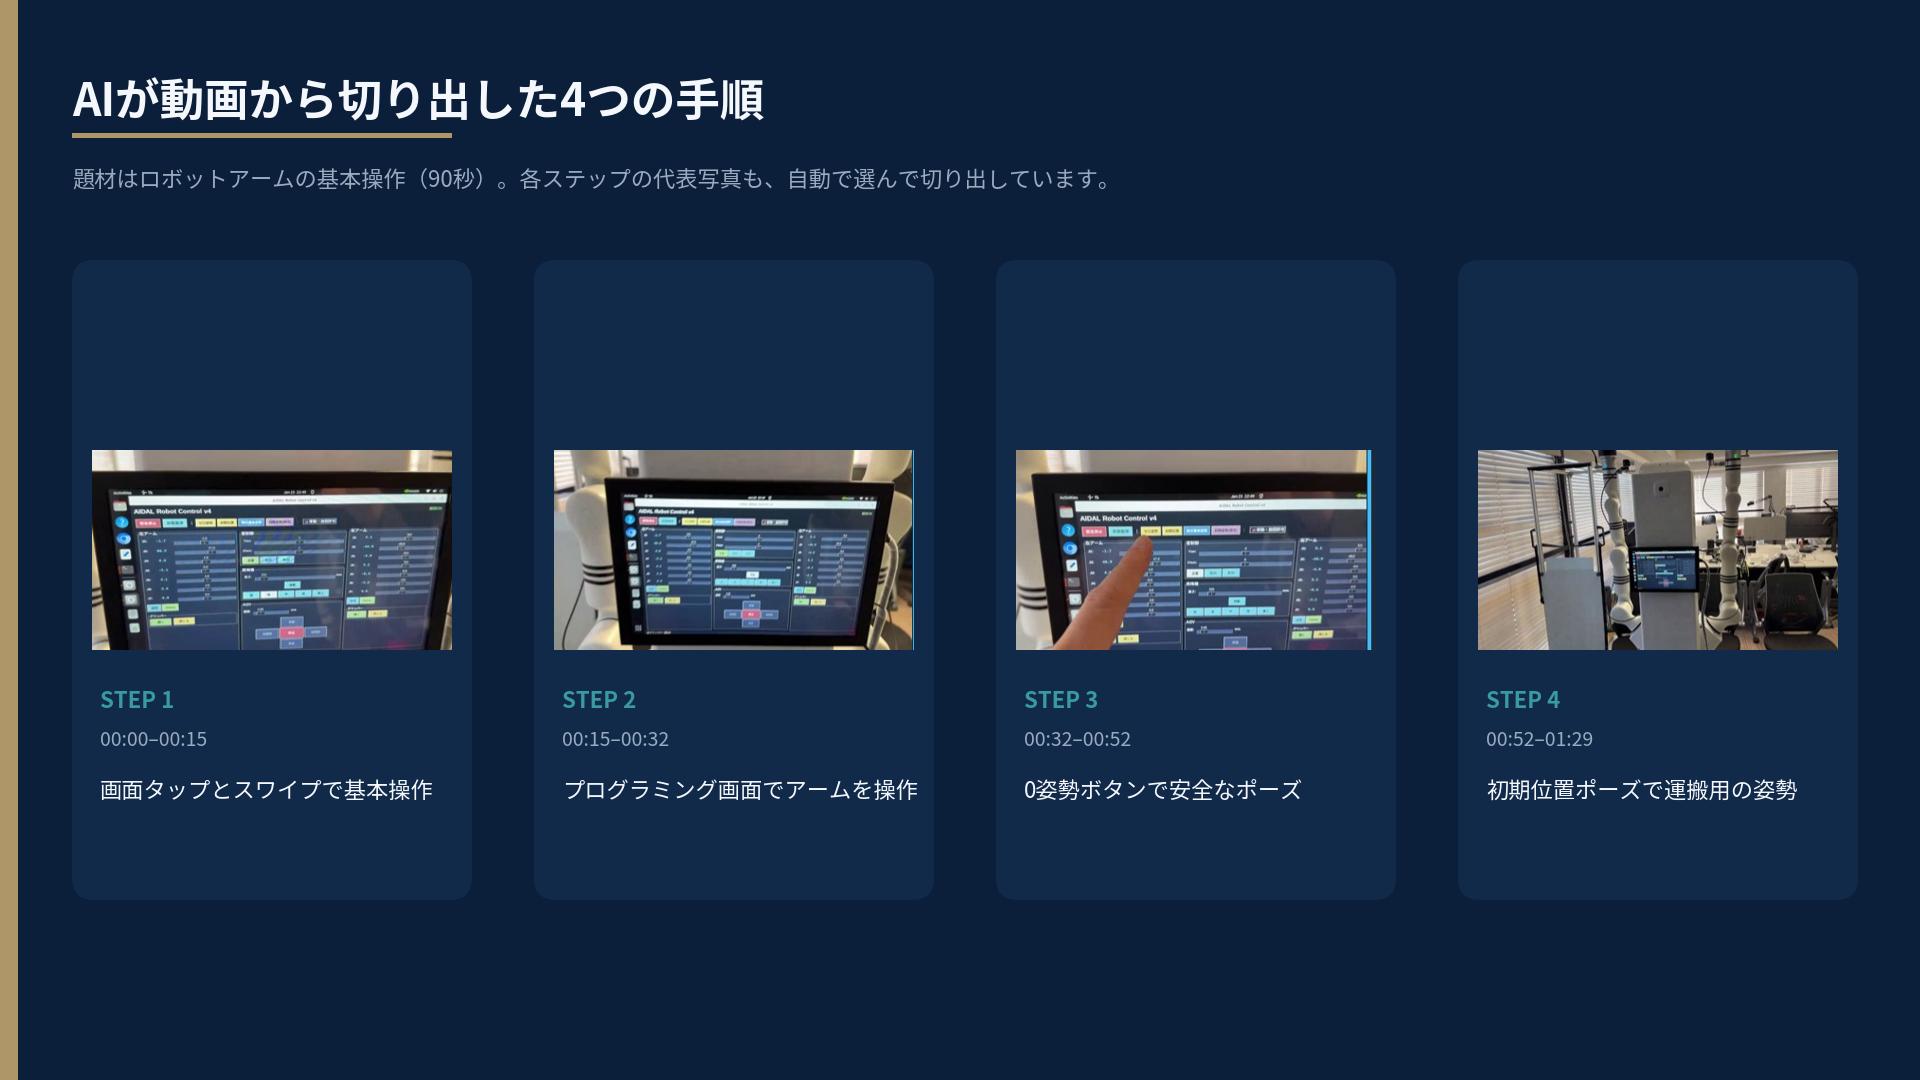
| ステップ | 時間 | 内容 |
|---|---|---|
| 1 | 00:00–00:15 | 画面タップとスワイプで基本操作 |
| 2 | 00:15–00:32 | プログラミング画面でアームを操作 |
| 3 | 00:32–00:52 | 0姿勢ボタンで安全なポーズ |
| 4 | 00:52–01:29 | 初期位置ポーズで運搬用の姿勢 |
注意事項として、「動作前に周囲に人がいないことを確認する」「初期位置や0姿勢は安全な操作に役立つ」「ダイアログが出たら実行するかを慎重に判断する」も、同じ動画から拾っています。
切り出しはたたき台です。文言の過不足や、写真の切り方は、次の画面で直せます。
エディタで直して、そのまま配る
切り出した手順は、手順書エディタに取り込みます。左で文言と写真を直し、右で PDF の見え方を確認してから書き出します。

自動で入る項目には、画像のタイトル・説明・タイムスタンプなど、生成時のメモが残ることがあります。公開前に目視し、要らない行は消す前提です。人が見て直せるところまで持っていくのが、この流れの役割です。
生成したサンプル
ロボットアームの基本操作を題材に、実際に書き出した文書です。目次、4つの手順、注意事項の5ページです。
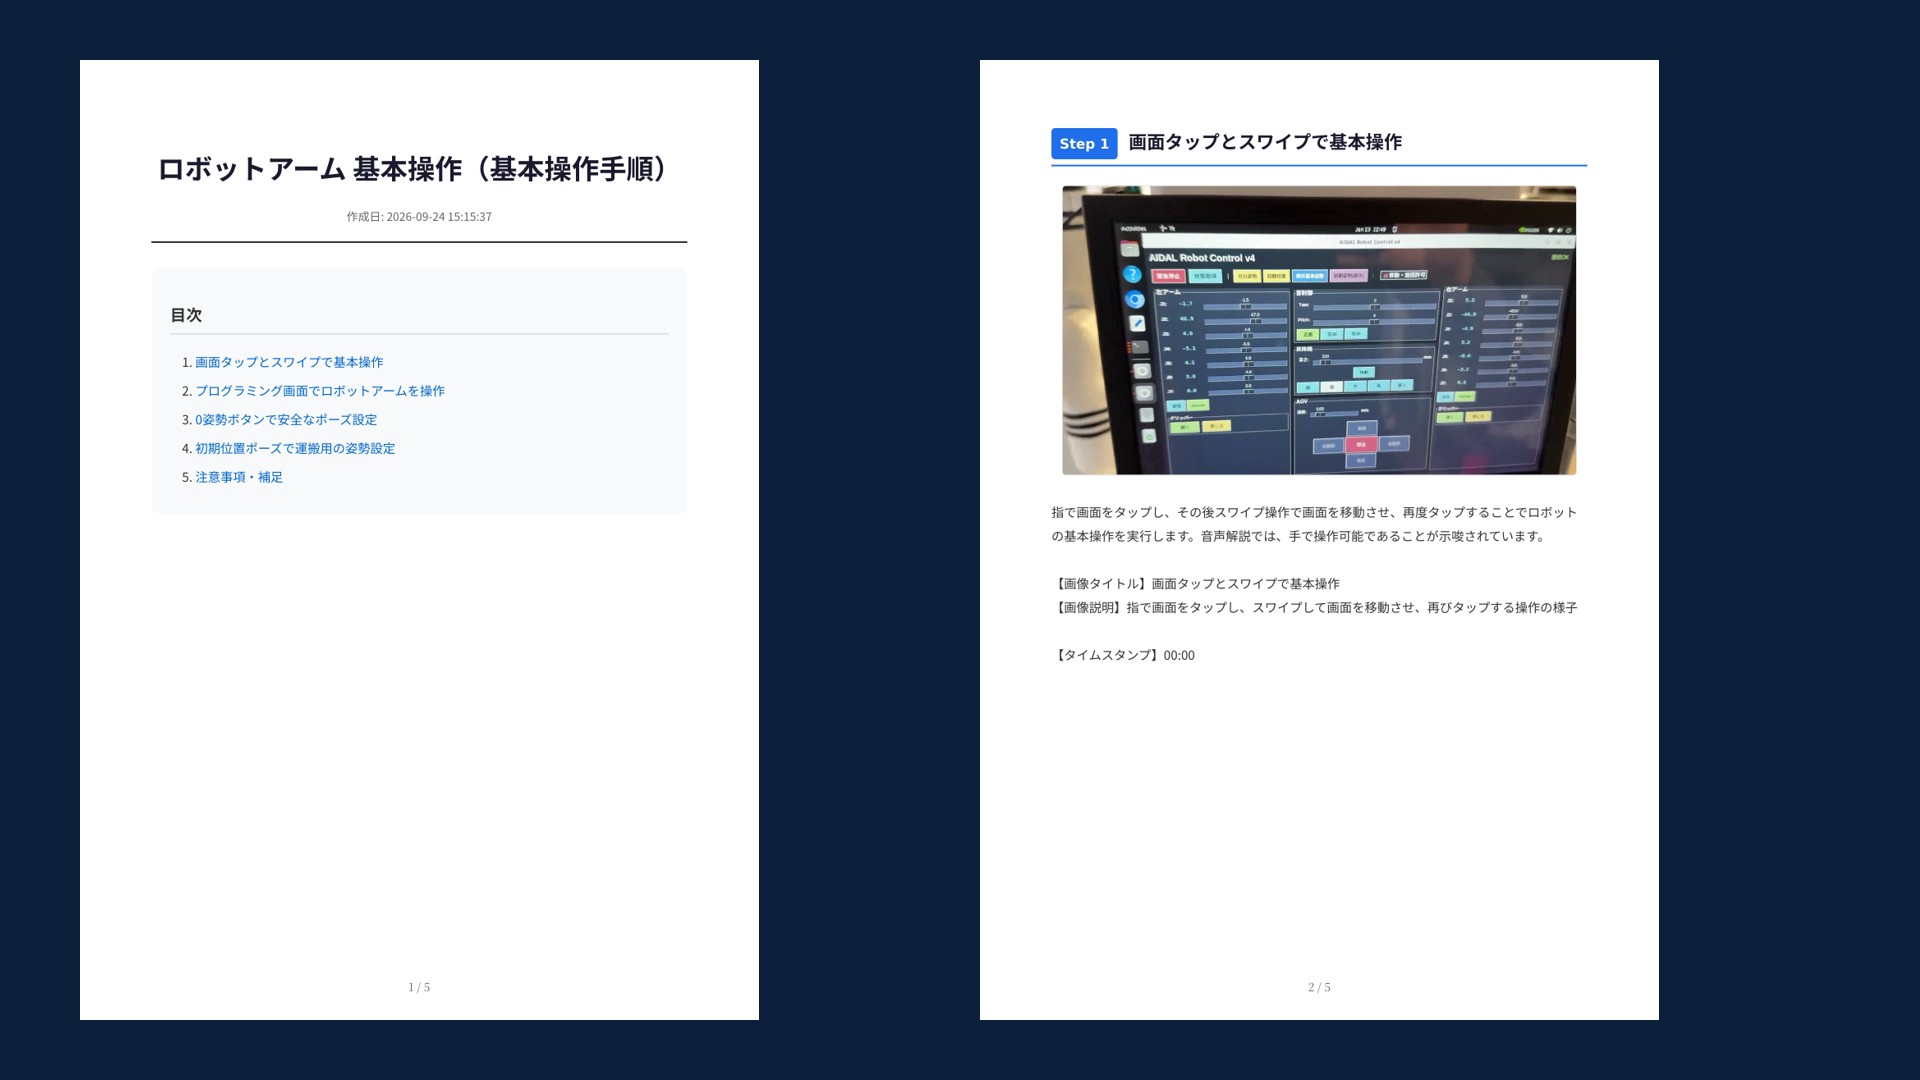
同じ内容を PDF と Word で書き出しています。PowerPoint / HTML にも出せます。
この実証での所要時間
入力から手順書まで、このPCの中で完結したときの実測です。
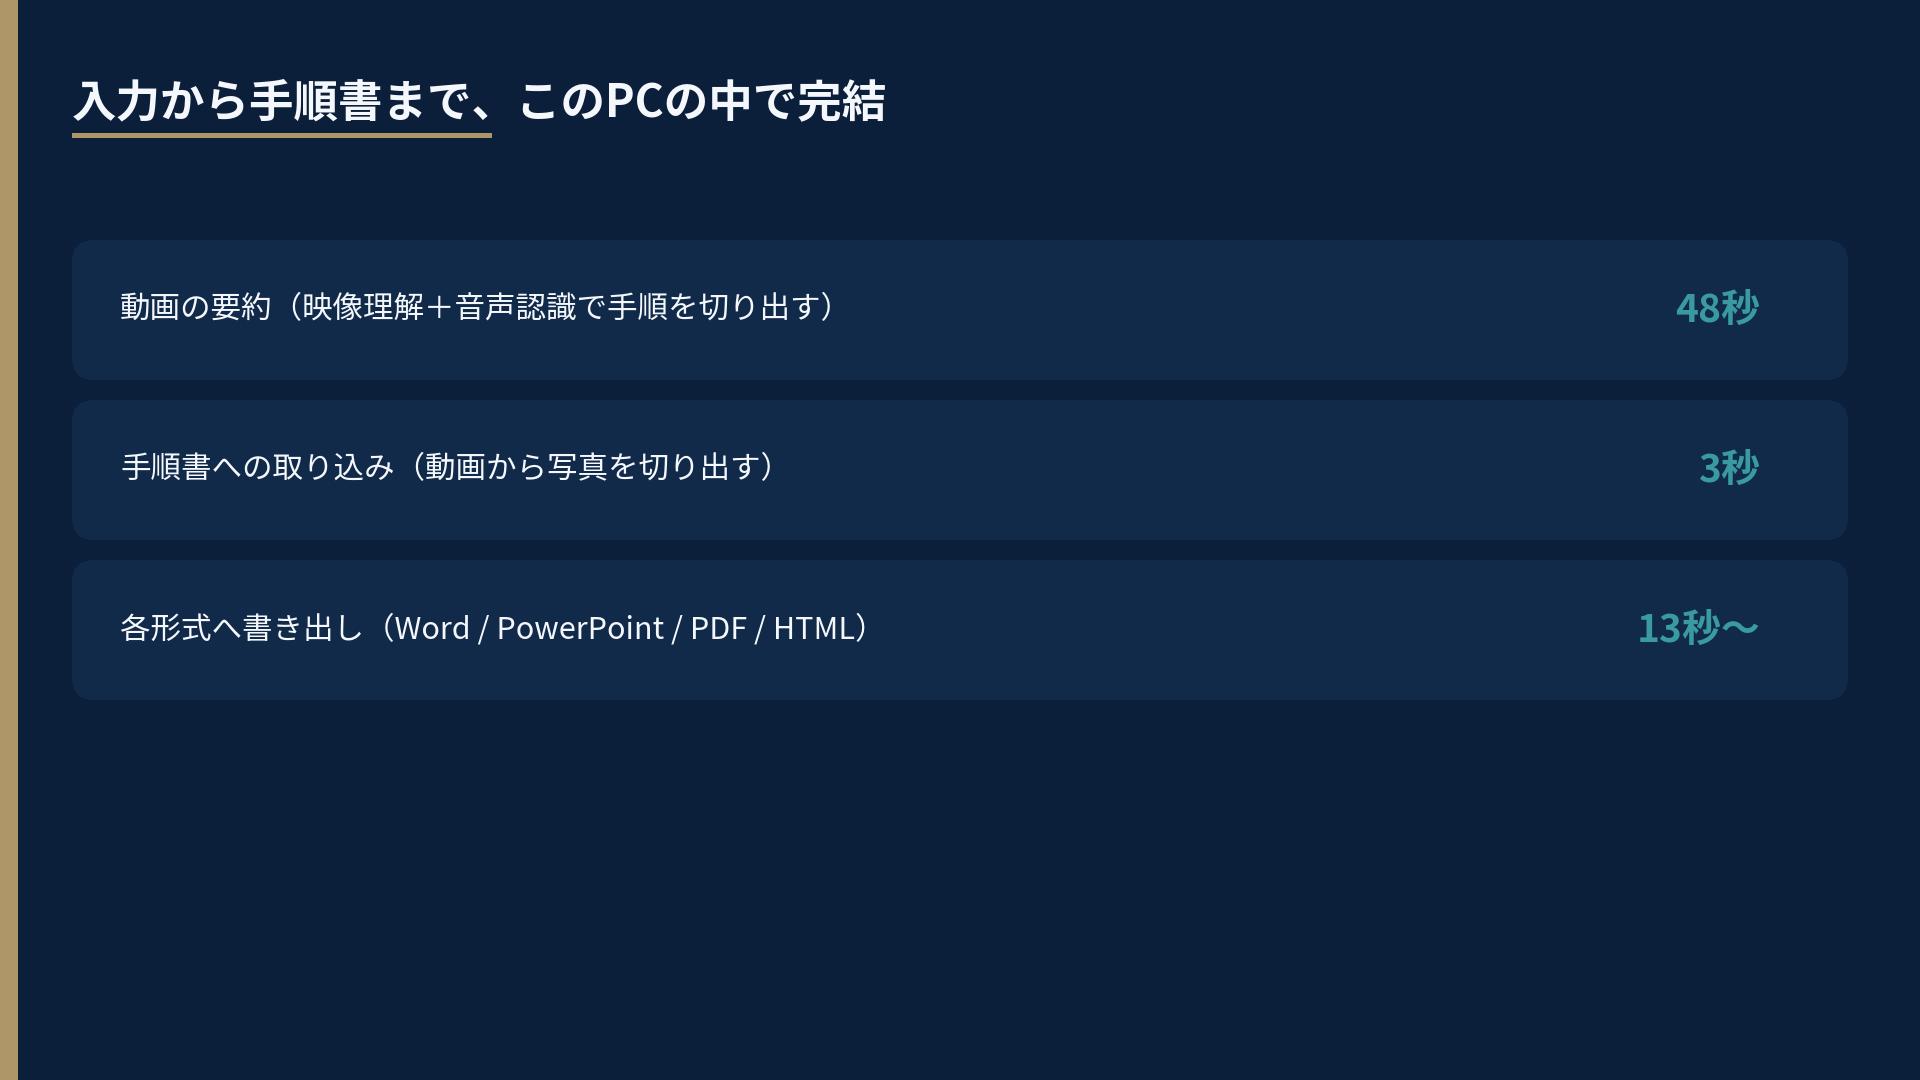
- 動画の要約 ― 48秒。映像理解と音声認識で手順を切り出します。
- 手順書への取り込み ― 3秒。動画から代表写真を切り出します。
- 各形式へ書き出し ― 13秒〜。Word / PowerPoint / PDF / HTML。
尺が長い動画、説明が少ない動画、画面が暗い動画では、切れ目や文言の精度は落ちます。そのときはエディタで直す前提です。今回の数字は、この90秒の題材での実測です。
まとめ
- 動画が入力、手順書が出力 ― 現場の操作を撮る。写真つきの文書が返る。
- クラウドAIは使わない ― 映像理解も音声認識も、このPCの中。実行中に外へ出さないことを、遮断して確認しました。
- たたき台までが速い ― 90秒の題材で、要約48秒・取り込み3秒・書き出し13秒〜。
- 人が直して配る ― エディタで文言と写真を直し、Word / PDF などですぐ配れます。
- サンプルを公開 ― ロボットアームの基本操作で書き出した PDF と Word を置いています。
現場に残っているのは動画です。残したいのは、次の人が読める手順です。そのあいだを、手元の処理でつなぐ。デモやご相談を承っています。