ロボットに手順を渡すのではなく、「やってほしい状態」と、その状態になったかを判断する成功条件を渡します。ロボット側は、いまの状況を観測して計画を立て、実行し、条件を満たしたかを確かめます。満たしていなければ、最新の観測から計画し直します。この考え方を、ここでは Agentic Robotics と呼んでいます。
題材は、警報が鳴っている操作盤をロボットが復旧する作業です。物理エンジンの違う3つのシミュレータ、MuJoCo、Gazebo Fortress、Isaac Sim で、同じプログラムを同じ初期条件のまま動かしました。途中でスイッチを物理的に戻す外乱も入れています。ロボットへの指令は共通のハーネスを通しているので、接続先をシミュレータから実機に切り替えれば、同じプログラムのまま実機のロボットも動きます。ここで紹介する動画と数値は、2026年11月1日時点でシミュレータを使って取ったものです。
人がしたのは、プロンプトを入れることだけです。作業環境は 3DBuilder で作り、そこから先の計画と実行は Luqua が進めています。
手順どおりに動くロボットは、途中のずれに気づけない
手順をそのまま実行するロボットは、途中で物がずれたり、誰かが触ったりしても、最後まで動いてしまいます。失敗したまま終わり、失敗したことにも気づきません。
ここでは、ゴールを達成するまで、観測、計画、実行、確認を回し続けます。考え方の要点は3つです。成功したかどうかは、実行した側ではなく、独立した判定が確かめます。値が分からないときは、成功にせず「不明」として扱います。手持ちのスキルで足りなければ、実行中に新しいスキルを作り、検査を通してから使います。
言葉を先に揃えておきます。ゴールは、達成してほしい状態とその成功条件で、操作盤なら「警報が止まり、確認済みになっている」です。ワールドステートは、物体ごとの属性で表した、いまの世界の状況です。分からない値は「不明(UNKNOWN)」のまま持ちます。スキルは「スイッチを押す」「赤ボタンを押す」のような単位動作で、内部で関節の動きに変換されます。スキルを並べたものがプランで、実行前に検査されます。
判断と物理を分け、その間に安全監視を置く

人が入れたプロンプトは、当社のローカルAIエージェント Luqua が受け取ります。作業環境のシーンは、3DBuilder で3つのシミュレータ向けに作っています。
中心にあるのは AGE(Agentic Goal Engine)です。ゴール、計画、判定、状態遷移を受け持ち、どれも決まった規則で動く決定論のコードです。スキルを関節の軌道に変えるところは、LEIVOR の逆運動学(IK)が受け持ちます。ロボットとの間には、共通の操作口になるハーネスがあり、MuJoCo、Gazebo、Isaac Sim を差し替えられます。同じハーネスの接続先を実機に切り替えれば、実機のロボットも同じプログラムで動きます。
プログラムは、コードを手で書いていません。当社の BlockPy でブロックをつないで組んでいます。組んだ処理フローは、手順を順番に並べたJSON(手順化JSON)として出力されます。
計画は、Luqua(LLM)が提案し、AGE のツールを呼んで進めます。LLM を使わず、決まった手順で AGE を呼ぶ決定論ドライバでも動かせます。どちらの場合も、LLM が間違えたときに止めるのは、AGE の検査と、別のプロセスで動く Safety Supervisor です。
AGE のプログラムは3つのシミュレータで共通です。違うのは、ハーネスのバックエンドの設定と、安全ポリシーの数値だけです。
1つのゴールは、観測から判定までの繰り返しで進む
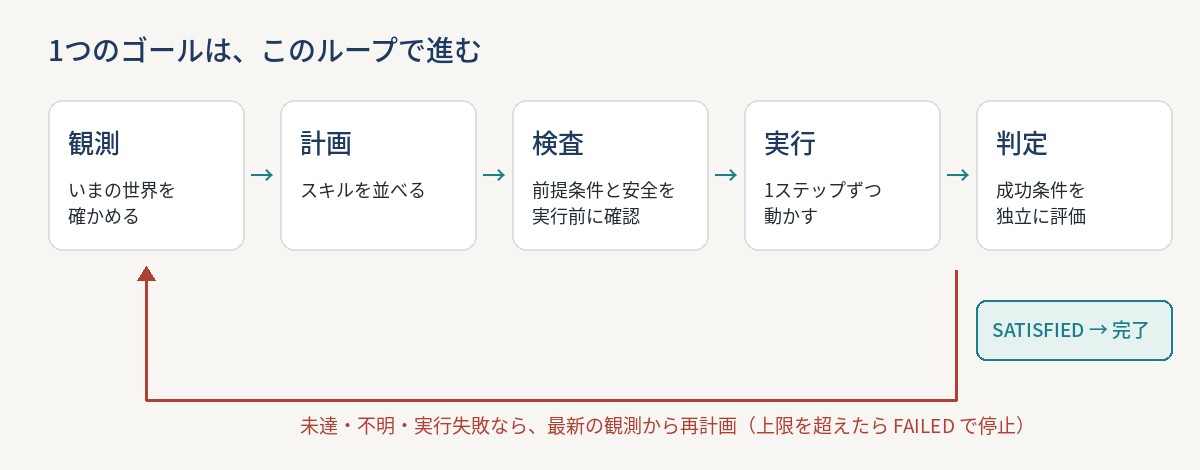
いまの世界を観測し、スキルを並べて計画を作ります。実行する前に、前提条件と安全を検査します。実行は1ステップずつです。終わったら、成功条件を独立に評価します。
満たしていれば完了です。満たしていない、値が分からない、実行に失敗した、のどれかなら、最新の観測から計画し直します。上限の回数を超えたら FAILED で止まり、黙って続けることはしません。
ゴールの状態遷移は表が1つだけあり、作成、計画中、実行中、検証中、成功と進みます。途中に再計画、失敗、取り消しがあります。検証を通らずに成功へ移ることはできず、表にない遷移は例外になります。
判定は4種類。分からないものは成功にしない
操作盤の成功条件は「警報が OFF、かつ確認済みが true」です。判定の結果は4つに分けています。
SATISFIED は、すべての条件が真のときで、ゴール達成です。UNSATISFIED は、偽の条件があるときで、最新の観測から計画し直します。UNKNOWN は、値が分からず評価できない条件があるときで、成功にはせず、観測し直してから判断します。INVALID は、条件式の誤りや、知らない物体の名前があるときで、エラーとして止めます。補正して続けることはしません。
LLM や制御コードが「できました」と返しても、それだけでは成功にしません。判定は、AGE の決定論のコードが、世界の観測値だけを見て行います。思い込みや自己申告では、成功になりません。
安全は4段で守り、止まったら人が解除する
Safety Supervisor は、AGE とも LLM とも別のプロセスで、設定もログも別です。判断の側にバグがあっても、安全の判定は曲げられません。
1段目は、AGE による計画の検査です。前提条件の違反、知らないスキル、ロボットの部位を直接動かす指定を拒否します。2段目は、実行前に Supervisor が自分で確かめる、関節速度の上限(既定 0.4 rad/s)と可動域です。3段目は、実行中の監視です。本体と環境の接触力 60 N、指と環境の接触力 100 N を上限にし、物体の落下も見ています。超えたら非常停止します。4段目は、止まったあとです。自動では復旧せず、解除は人が行います。失敗したときの状態は、そのまま残します。
異常を見つけたら、エラーをログに残して止めます。もっともらしい値で続ける、別の経路で代わりに動かす、自動で元に戻す、ということはしません。そうすると異常が隠れ、原因が追いにくくなるからです。止まって残ったログが、いちばん早い修正の手がかりになります。数値は設定ファイルで与え、シミュレータごとに別のポリシーを使えます。
題材は、警報が鳴っている操作盤
操作盤には、押し上げて ON にするスイッチ、警報を止める赤ボタン、確認済みにする青ボタンがあります。ボタンとスイッチはばね付きの物理で、その上に盤の論理(PLC)が載っています。
スイッチが ON のまま赤ボタンを押し込むと、警報が止まります。警報が止まっている状態で青ボタンを押し込むと、確認済みになります。スイッチを OFF に戻すと、警報がまた鳴り、確認済みも外れます。ゴールは、警報が止まり、確認済みになっていることです。
課題は2つあります。1つ目は、青ボタンを押すスキルが、最初は用意されていないことです。手元にあるのは、スイッチを押すスキルと赤ボタンを押すスキルだけです。2つ目は、途中でスイッチを物理的に戻されることです。外乱として、こちらから入れています。
期待する動きは、足りないスキルを実行中に作り、実行し、外乱を観測で見つけて計画し直し、警報停止と確認済みで SATISFIED になることです。3つのシミュレータで、同じプログラム、同じ初期条件、同じ 5 mm の認識ノイズで動かしました。
足りないスキルは、実行中に作って検査してから使う
ISE(Instant Skill Expansion)と呼んでいる仕組みです。新しいスキルは、名前、前提、効果、対象の機器を宣言するところから始まります。
宣言は、まず矛盾や知らない機器がないかを検査します。次に、逆運動学のドライランで、すべての点に手が届くかを確かめ、安全の事前検査も通します。最後に、対応しているシミュレータでは、実際に試しに動かして効果を確認します。全部を通ったスキルだけを登録し、来歴をファイルに残します。
どこかで棄却されたら、ヒントを変えて宣言し直します。3回まで試し、それでも通らなければ ISE_REJECTED として止まります。
MuJoCo の操作盤シナリオで、21試行ずつ比べました。ISE がない場合は 0/21 で、21試行すべてがスキルがないために何もできず止まりました。ISE があり、試し実行まで検証した場合は 16/21 で、5試行が ISE_REJECTED で止まりました。ISE があり、試し実行の検証をしない場合は 20/21 で、ISE_REJECTED は1試行です。
試し実行の検証には、本来なら成功するスキルを棄却してしまう誤りがあります。押下量の判定などの条件は、見直しが必要です。
3つのシミュレータで、同じプログラムを動かす
下の2本は、MuJoCo と同じシナリオ、同じプログラム、同じ seed(2007)、同じ外乱(スイッチ戻し)です。動かしているのは決定論ドライバで、LLM は使っていません。
シミュレータごとの違いは、ハーネスが申告する「できること」だけです。対応していない機能を要求されたら、近い動きで代わりにすることはせず、「非対応」のエラーで止まります。そのため、3つの結果を同じ尺度で比べられます。
| MuJoCo | Gazebo Fortress | Isaac Sim 2023.1 | |
|---|---|---|---|
| 物理エンジン | MuJoCo | DART | PhysX 5(コンテナで実行) |
| ロボット制御・グリッパ | ○ | ○ | ○ |
| 実行時の環境生成 | ○ | ○ | ○ |
| 録画用のカメラ映像 | ○ | ○ | ○ |
| 接触力の読み出し、状態の保存と復元 | ○ | 非対応 | 非対応 |
| 「試して選ぶ」評価 | 全群 | C群のみ | C群のみ |
MuJoCo がいちばん機能が揃っているので基準にし、Gazebo は別の物理での再現、Isaac Sim は別の物理と高品質な描画での再現を確かめる位置づけです。
3つとも、ほぼ同じ達成率と自律回復になった
操作盤シナリオを、seed 2000〜2020 の21試行ずつ動かしました。認識ノイズは 5 mm です。外乱は試行ごとに、なし、スイッチ戻し、赤ボタンを押したあとの3種類を順に入れています。
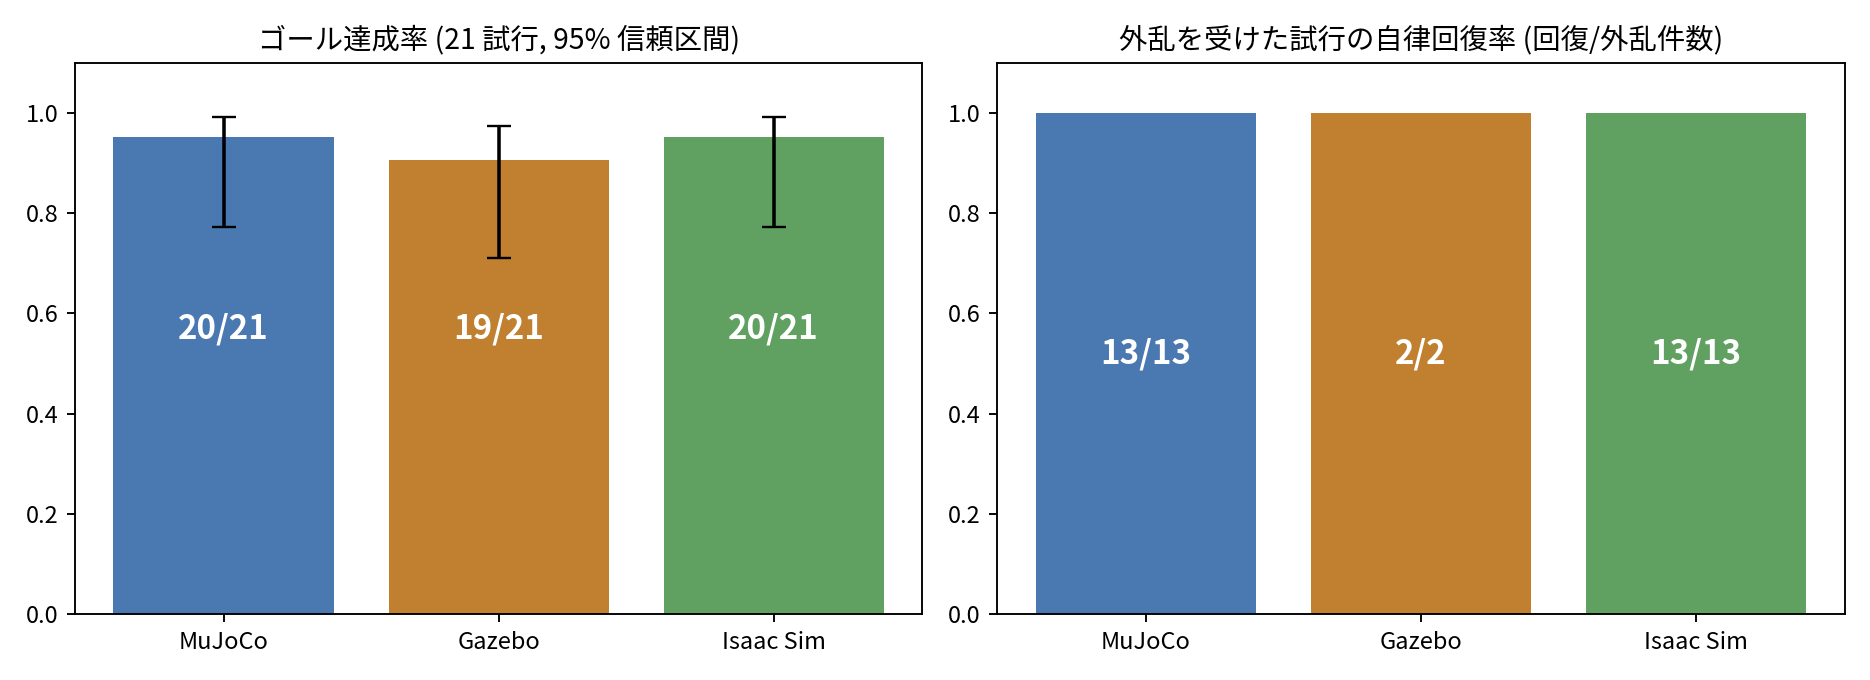
達成は、MuJoCo が 20/21、Gazebo が 19/21、Isaac Sim が 20/21 です。1試行あたりの再計画は、MuJoCo と Isaac Sim が 0.48回、Gazebo が 2.71回でした。非常停止と人の介入は、3つとも0回です。
達成しなかった試行は、3つとも seed 2002 です。新しいスキルの検査で棄却され、止まって記録を残しています。補正して続けてはいません。Gazebo は、seed 2019 も FAILED で止まりました。
Gazebo は再計画が多いうえ、外乱を入れられた試行が2件しかありません。回復を確かめられた範囲は限られます。完了までの時間には、シミュレータの実行速度と、同時に動かしていた影響が含まれるので、シミュレータ同士の優劣の比較には使っていません。
認識がずれているときは、試して選ぶと達成率が上がる
認識の誤差を、位置 20 mm、姿勢 15° に増やして、MuJoCo で4つの群を20試行ずつ比べました。
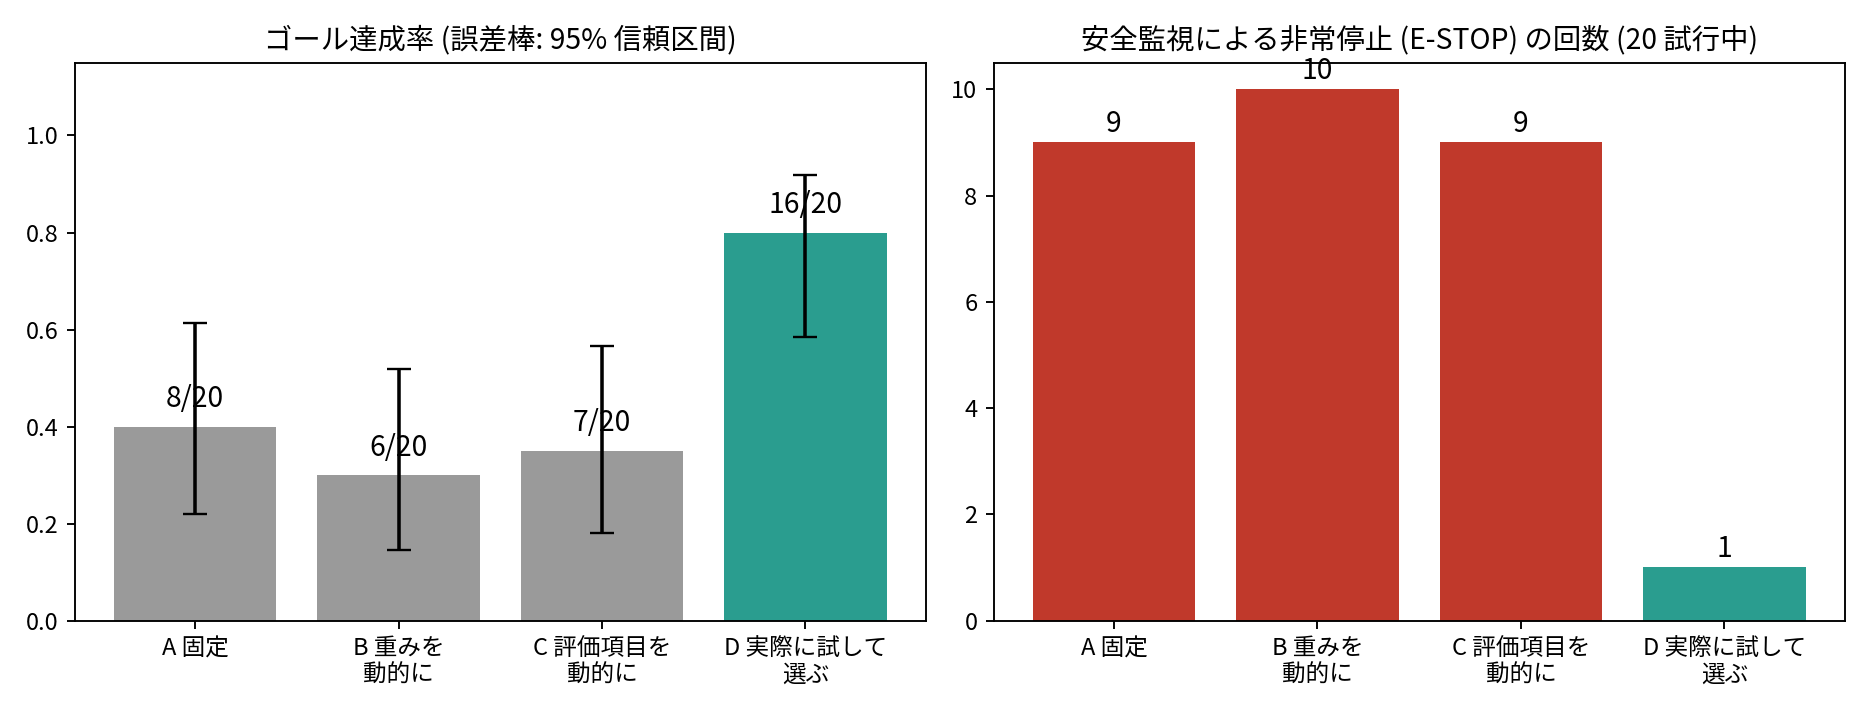
A から C は、観測をそのまま信じて動きます。ずれた位置をつかもうとして接触が大きくなり、安全監視に止められます。達成は 8/20、6/20、7/20 で、非常停止は 9回、10回、9回でした。D は、候補をシミュレータの中で試し、うまくいくものを選びます。達成は 16/20、非常停止は1回です。D だけが成功した試行が 8〜10件あり、A から C だけが成功した試行は0件でした(いずれも p < 0.01)。
そのぶん、D には費用がかかります。計画に約4.5倍の時間(中央値 58.8秒、A から C は約13秒)を使い、1試行あたり約795秒分の仮想実行をします。時間の制約が厳しい用途では、A から C の方が向いている場面があります。この評価は決定論ドライバで行っていて、LLM は使っていません。AGE の仕組みがどれだけ効くかだけを測っています。
LLM が AGE を操作して、机の上を片付ける
最後の1本は、Luqua(LLM)が AGE のツールを呼んで動かした例です。題材は、机の上の物をビンへ仕分ける作業です。LLM の役目は計画を提案するところまでで、実行してよいかどうかは AGE の検査と Safety Supervisor が決めます。
1つ目は、おてだまをビンAへ入れます。つかむ位置をずらして、もう一度試しています。ここで再計画が1回入りました。2つ目は、ケーブルをビンBへ入れます。つかむ向きを調整して実行しました。最後に AGE が状態を検証して SATISFIED です。実時間は LLM の思考時間を含めて約243秒、シミュレータの中の時間は約46秒でした。
LLM で動かした実績は、この動画の1本だけです。統計的な評価は、まだ行っていません。
できていることと、これからの課題
できていることは、次のとおりです。ゴールから計画、検査、実行、独立した判定、再計画までのループが、3つのシミュレータで動きます。存在しないスキルを実行時に作り、検査して使えます。操作盤では、達成が 0% から 76〜95% になりました。外乱を観測で見つけて自律で回復することは、MuJoCo と Isaac Sim でそれぞれ 13/13 です。独立した安全監視が危険な動作を止め、記録を残します。評価は、seed を固定し、ログをすべて保存し、統計検定をつけて、再現できる形にしています。
これからの課題も書いておきます。LLM で動かした統計評価はまだなく、評価は決定論ドライバで行っています。「試して選ぶ」評価は MuJoCo だけで、Gazebo と Isaac Sim は状態の保存と復元に対応していません。Gazebo での外乱からの回復は2件だけです。認識は人工的に入れたノイズで、実際のカメラの認識はまだつないでいません。試し実行の検証には、本来成功するスキルを棄却する誤りがあります。D群の計画は約4.5倍遅いので、実時間の要件には注意が必要です。
次は、安全監視とエラーで止める方針を変えずに、この順で進める予定です。LLM で動かす A/B 評価を20試行以上で行い、制約と失敗の記録を整えます。同じ AGE と同じ Supervisor のまま、ハーネスの接続先を実機に切り替え、シミュレータで確かめた振る舞いを実機で確認します。カメラや視覚モデルの出力を、ワールドステートへつなぎます。Gazebo と Isaac Sim に、状態の保存と復元を足します。ISE の検証基準を見直し、本来成功するスキルを棄却する誤りを減らします。